J'ai toujours voulu écrire un résumé relativement complet et parfait. Mais après y avoir réfléchi, je ne savais pas par où commencer. Comme on dit, tout est difficile au début. Aujourd'hui, j'ai mis de l'ordre dans mes pensées en désordre. Bon, je ne les ai toujours pas bien démêlées. Je vais juste parler de ce qui me vient à l'esprit.
Les débutants ne comprennent vraiment pas :
- 1. Qu'est-ce que l'architecture trois tiers ?
- 2. Pourquoi utiliser l'architecture trois tiers ?
- 3. Quelle est la différence entre l'architecture trois tiers et l'architecture deux tiers utilisée auparavant ? Quels sont ses avantages ?
- 4. Comment bien apprendre l'architecture trois tiers ? Comment appliquer l'architecture trois tiers ? ……
Dans cet article de blog, je vais les expliquer un par un. Je n'en connais qu'un peu, alors veuillez me pardonner !!!
Le professeur Mi insiste toujours : associez l'apprentissage à la vie, reliez l'apprentissage à la vie. C'est seulement alors que l'apprentissage peut être appelé véritable apprentissage, et la vie véritablement vécue.
Quant à l'architecture trois tiers, j'ai réfléchi intensément à la façon de la relier à la vie réelle. Eh bien, hier soir, j'ai soudain eu une « inspiration ». Vous souvenez-vous encore de l'histoire dans Big Talk Design Patterns à propos de Big Bird et Xiao Cai mangeant des brochettes d'agneau — un motif Commande déclenché par le fait de manger à un stand de rue plutôt qu'au restaurant (bien sûr, aujourd'hui nous n'étudions pas le motif Commande). Le serveur, le chef et l'acheteur.
N'est-ce pas là une architecture trois tiers typique ??? (⊙ o ⊙) Ah ! Haha (je vais l'expliquer plus tard)
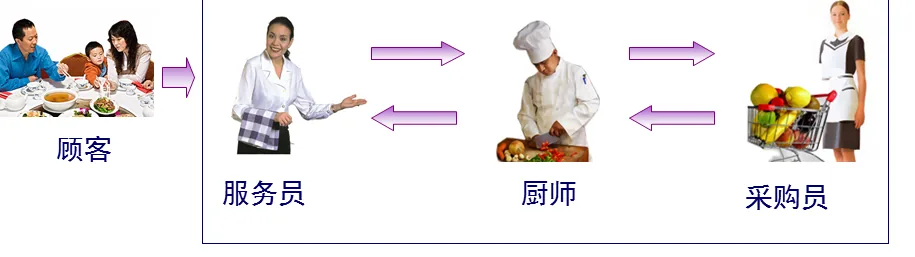
Tout d'abord, comprenons :
1. Qu'est-ce que l'architecture trois tiers ?
UI (couche de présentation) :Désigne principalement l'interface qui interagit avec l'utilisateur. Elle sert à recevoir les données saisies par l'utilisateur et à afficher les données traitées dont l'utilisateur a besoin.
BLL (couche de logique métier) :Le pont entre la couche UI et la couche DAL. Elle implémente la logique métier. La logique métier comprend spécifiquement : la validation, le calcul, les règles métier, etc.
DAL (couche d'accès aux données) :Elle s'occupe de la base de données. Elle implémente principalement l'ajout, la suppression, la modification et l'interrogation des données. Elle soumet les données stockées dans la base de données à la couche métier et, en même temps, enregistre dans la base de données les données traitées par la couche métier. (Bien sûr, ces opérations reposent toutes sur la couche UI. Les besoins de l'utilisateur sont répercutés vers l'interface (UI), l'UI les répercute vers BLL, BLL les répercute vers DAL, DAL effectue les opérations sur les données, puis les renvoie une par une jusqu'à ce que les données dont l'utilisateur a besoin soient renvoyées à l'utilisateur.)
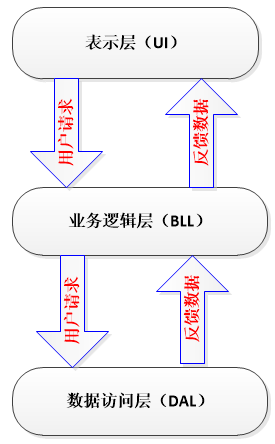
Chaque couche a ses propres responsabilités, alors comment les trois couches doivent-elles être connectées ?
1. Référence unidirectionnelle (voir figure ci-dessous)
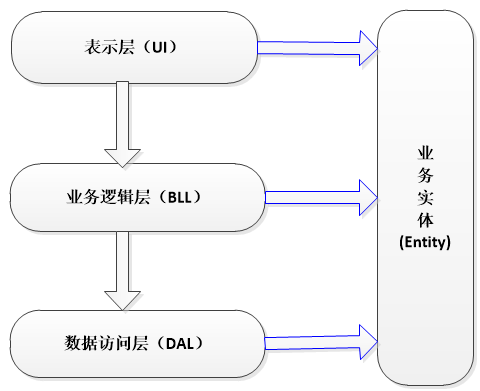
2. À ce stade, la couche Entité entre en jeu. (Remarque : Bien sûr, le rôle de la couche Entité ne se limite pas à cela.)
Entité :Elle n'appartient à aucune des trois couches, mais c'est une couche essentielle.
Le rôle de l'Entité dans l'architecture en trois couches :
- 1. Mettre en œuvre « l'encapsulation » dans la pensée orientée objet ;
- 2. Parcourir les trois couches et transmettre des données entre elles ; (Remarque : Pour être précis, la couche Entité parcourt les trois couches pour les relier.)
- 3. Pour les débutants, on peut le comprendre ainsi : chaque table de données correspond à une entité, c'est-à-dire que les champs de chaque table de données correspondent aux propriétés de l'entité. (Remarque : Bien sûr, ce n'est pas réellement le cas. Pourquoi ? 1> L'entité dont nous avons besoin peut ne pas exister dans l'entité correspondant à la table de données ; 2> Nous pouvons tout à fait mettre tous les champs de toutes les tables de données dans une seule entité.)
- 4. Le transfert de données (unidirectionnel) entre chaque couche (UI—>BLL—>DAL) est transmis à l'aide de variables ou d'entités comme paramètres. Cela établit la connexion entre les trois couches et complète la mise en œuvre de la fonctionnalité.
Mais pour de grandes quantités de données, l'utilisation de variables comme paramètres est quelque peu compliquée, car trop de paramètres peuvent facilement être confondus. Par exemple : si je veux transmettre les informations d'un employé à la couche inférieure, et que les informations comprennent : numéro d'employé, nom, âge, sexe, salaire... si des variables sont utilisées comme paramètres, alors il y aura de nombreux paramètres dans notre méthode, et il est très probable que la correspondance des paramètres soit confondue lors de l'utilisation. À ce stade, si une entité est utilisée comme paramètre, cela devient très pratique. Il n'est pas nécessaire de s'inquiéter de la correspondance des paramètres ; il suffit de prendre n'importe quelle propriété de l'entité et de l'utiliser directement. C'est très pratique. Cela améliore aussi l'efficacité.
(Remarque :Pourquoi est-il dit ici que l'on peut temporairement comprendre que chaque table de données correspond à une entité ? Réponse : comme tout le monde le sait, le but de la construction d'un système est de fournir des services aux utilisateurs. Les utilisateurs ne se soucient pas du fonctionnement du back-end de votre système ; les utilisateurs se soucient seulement de savoir si le logiciel est facile à utiliser et si l'interface correspond à leurs goûts. Lorsque les utilisateurs ajoutent, suppriment, modifient et interrogent facilement sur l'interface, la base de données doit également avoir des opérations correspondantes d'ajout, de suppression, de modification et d'interrogation. Les objets spécifiques des opérations d'ajout, de suppression, de modification et d'interrogation sont les données de la base de données, ce qui, en termes simples, correspond aux champs des tables. Par conséquent, traiter chaque table de données comme une classe d'entité, les propriétés encapsulées par la classe d'entité correspondant aux champs de la table, alors lorsque l'entité traverse les trois couches, elle peut implémenter l'ajout, la suppression, la modification et l'interrogation de données.)
En résumé : les relations de dépendance entre les trois couches et la couche Entité :
L'idée vient de la vie :
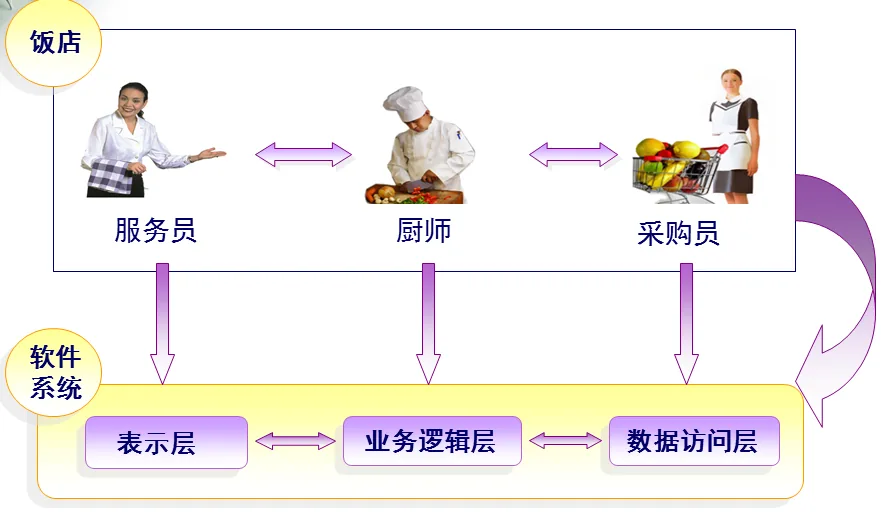
Serveur :Uniquement chargé de recevoir les clients ;
Cuisinier :Uniquement chargé de cuisiner les plats commandés par les clients ;
Acheteur :Uniquement chargé d'acheter les ingrédients selon les exigences de commande des clients ;
Chacun assume ses propres responsabilités. Le serveur n’a pas besoin de savoir comment le chef cuisine, ni comment l’acheteur achète les ingrédients ; le chef n’a pas besoin de savoir quels clients le serveur a reçus, ni comment l’acheteur achète les ingrédients ; de même, l’acheteur n’a pas besoin de savoir quels clients le serveur a reçus, ni comment le chef cuisine.
Comment sont-ils tous les trois reliés ?
Par exemple : le chef peut préparer : de l’aubergine sautée, des œufs brouillés, du chow mein — à ce stade, trois méthodes sont créées (cookEggplant(), cookEgg(), cookNoodle())
Le client traite directement avec le serveur. Le client dit au serveur (couche UI) : « Je veux une aubergine sautée. » Le serveur n’est pas chargé de cuisiner l’aubergine, il transmet donc la demande au chef (couche BLL). Le chef a besoin d’aubergine, il transmet donc la demande à l’acheteur (couche DAL). L’acheteur prend l’aubergine dans l’entrepôt et la renvoie au chef. Le chef appelle la méthode cookEggplant(), et après avoir préparé l’aubergine sautée, la renvoie au serveur, qui présente l’aubergine au client.
Cela termine une opération complète.
Dans ce processus, l’aubergine est transmise comme paramètre entre les trois couches. Si le client commande des œufs brouillés, alors l’œuf est utilisé comme paramètre (il s’agit ici d’utiliser des variables comme paramètres). Si l’utilisateur ajoute des exigences, nous devons encore ajouter des paramètres aux méthodes — une méthode en ajoute un, et une méthode implique les trois couches ; de plus, en réalité, ce n’est pas seulement une méthode qui est modifiée. Par conséquent, pour résoudre ce problème, nous pouvons définir l’aubergine, l’œuf et les nouilles comme propriétés dans l’entité client. Une fois que le client ajoute l’exigence des œufs brouillés, nous pouvons directement extraire la propriété œuf et l’utiliser. Il n’est pas nécessaire d’envisager d’ajouter des paramètres aux méthodes de chaque couche, et encore moins de se soucier de la correspondance des paramètres.
Je me demande si tout le monde peut comprendre cette explication. (Je l'expliquerai plus tard avec un exemple.)
2. Pourquoi utiliser l'architecture trois tiers ?
Le but de l'utilisation d'une architecture trois tiers : découplage!!!
De même, prenons l'exemple du restaurant ci-dessus :
(1) Le serveur (couche UI) prend un congé—trouver un autre serveur ; le chef (couche BLL) démissionne—embaucher un autre chef ; l'acheteur (couche DAL) démissionne—embaucher un autre acheteur ; (2) Retour client :
- 1. « Votre restaurant a un mauvais service »—c'est le problème du serveur. Virez le serveur ;
- 2. « Il y a un bug dans votre plat »—c'est le problème du chef. Remplacez le chef ;
Tout changement dans une couche n'affectera pas les autres couches!!!
3. Quelle est la différence avec une architecture deux tiers ?
Deux tiers :
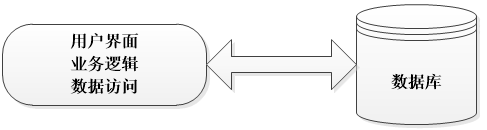
(Lorsqu'une partie quelconque change, tout le système doit être redéveloppé. « Plusieurs couches » sont placées dans une seule couche, avec une répartition des tâches peu claire et un couplage élevé—ce qui rend difficile l'adaptation aux changements d'exigences, avec une faible maintenabilité et une faible évolutivité.)
Trois tiers :
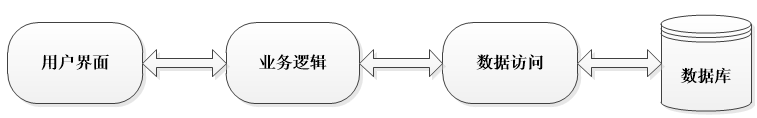
(Un changement dans une couche, quelle qu'elle soit, ne nécessite que la modification de cette couche, et non celle de tout le système. La hiérarchie est claire, la répartition des tâches est claire, et le couplage entre les couches est faible—ce qui améliore l'efficacité, permet de s'adapter aux changements d'exigences, avec une maintenabilité et une évolutivité élevées.)
En résumé, les avantages de l'architecture à trois niveaux :
- 1. Structure claire et faible couplage
- 2. Maintenabilité élevée, évolutivité élevée
- 3. Facilite le développement synchrone des tâches, s'adapte facilement aux changements d'exigences
Les avantages et les inconvénients de l'architecture à trois niveaux :
- 1. Cela réduit les performances du système. C'est évident. Si une structure en couches n'est pas adoptée, de nombreuses opérations peuvent accéder directement à la base de données pour obtenir les données correspondantes, mais maintenant elles doivent passer par la couche intermédiaire.
- 2. Cela entraîne parfois des modifications en cascade. Ce type de modification se reflète particulièrement dans le sens du haut vers le bas. Si une fonction doit être ajoutée dans la couche de présentation, pour garantir que sa conception est conforme à la structure en couches, du code correspondant peut devoir être ajouté à la fois dans la couche de logique métier et dans la couche d'accès aux données.
- 3. Cela augmente la quantité de code et accroît la charge de travail.
4. Quelles sont les formes concrètes des trois niveaux ?
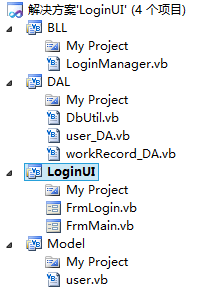
UI:
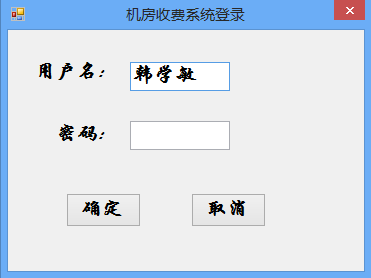
(Ne vous méprenez pas — la couche UI n'est pas seulement un ensemble d'interfaces utilisateur ; elle doit aussi contenir du code.)
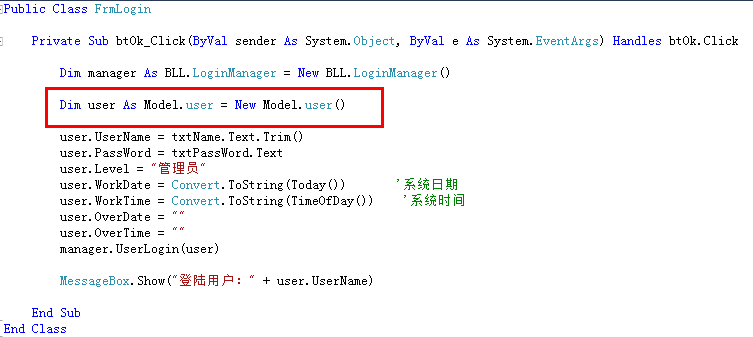
(1. Fonction : l'utilisateur saisit des données, renvoie des données à l'utilisateur ; 2. Tout le monde observe le code : aucune logique métier impliquée, uniquement un passage direct de paramètres, des appels de fonctions/méthodes, et aucune instruction SQL ni ADO.NET traitant avec la base de données.)
BLL :
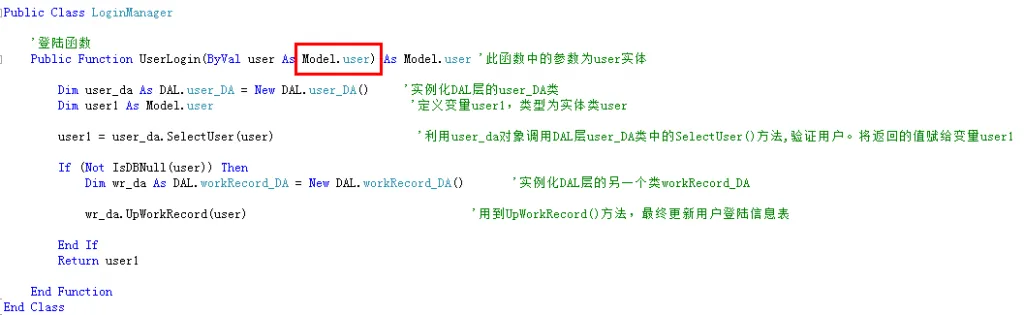
(1. La BLL est le pont entre la couche de présentation et la couche d'accès aux données, responsable du traitement et du transfert des données ; 2. Observez tous le code : aucun contrôle d'interface n'intervient, aucune instruction SQL ni ADO.NET n'intervient.)
DAL :
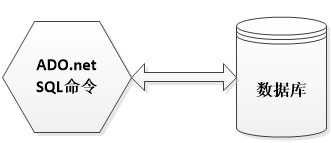
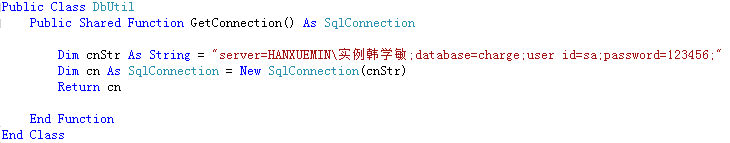
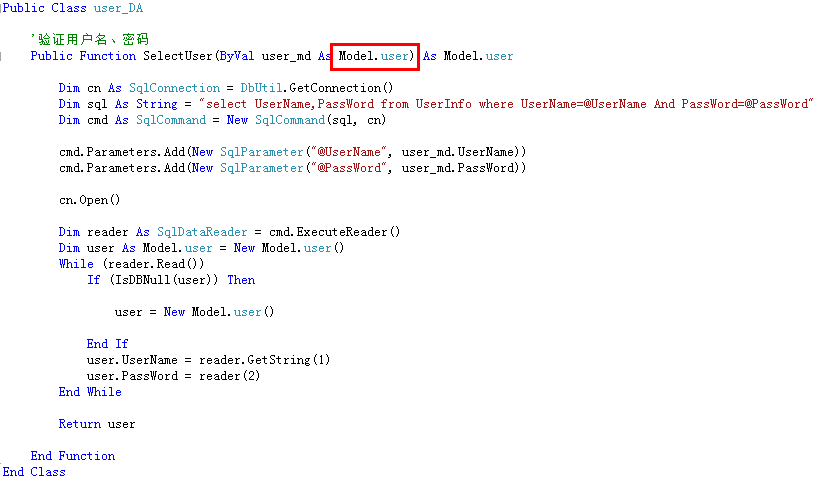
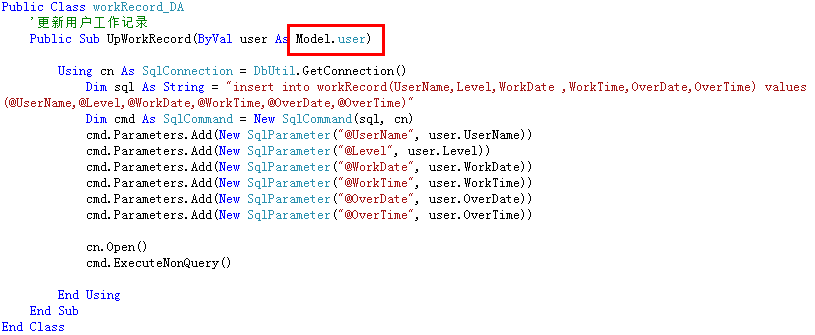
(1. Ce qui précède est le code dans la classe DbUtil, la classe user_DA et la classe workRecord_DA de la couche DAL ; 2. Observez tous le code : aucun contrôle d'interface n'intervient, aucune logique métier n'intervient ; uniquement des instructions SQL et ADO.NET en rapport avec la base de données.)
Couche Entité (Modèle) :
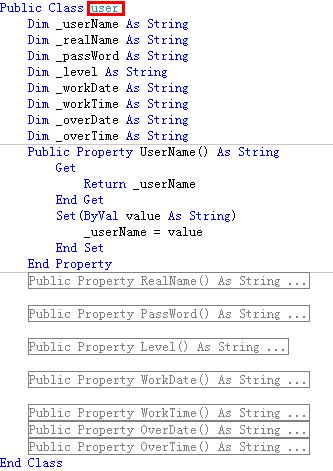
(Définit la classe d'entité user)
Observez les trois couches ci-dessus :
- 1. La classe d'entité user traverse les trois couches en tant que paramètre ;
- 2. Implémentez les fonctionnalités par le passage de paramètres et les appels de méthodes ;
- 3. Chaque couche est responsable de ses propres tâches et n'affecte pas les autres ;
Comparez la structure à deux couches pour donner à chacun une compréhension approfondie des grands avantages de la structure à trois couches :
Prenons toujours comme exemple la connexion du système de facturation de la salle informatique :
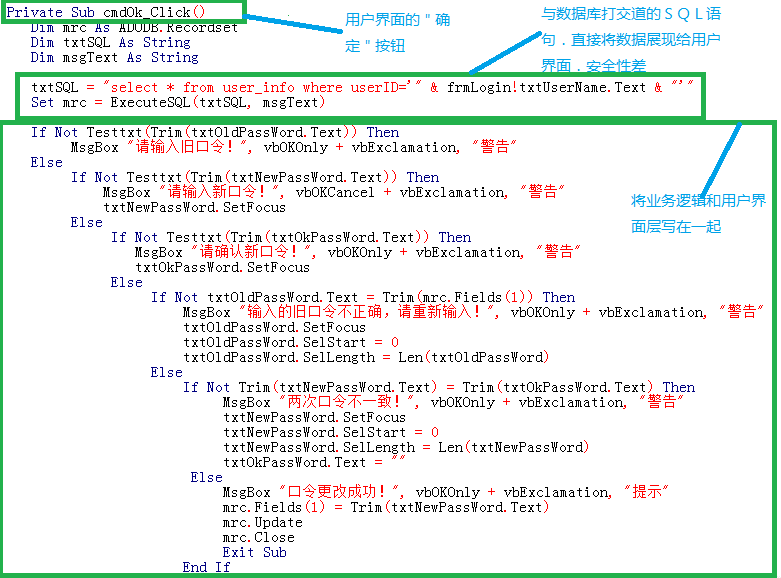
(Observez le code à deux couches ci-dessus : la logique métier et l'accès aux données sont tous deux présentés dans la couche de présentation utilisateur. Lorsque les exigences doivent changer, l'ensemble du système doit être modifié. Par exemple, si je change le nom de la zone de texte txtPassWord en txtPwd, vous pouvez voir combien d'endroits doivent être modifiés. Un tel changement est considéré comme mineur. S'il y a un vrai changement dans les exigences métier, ce serait vraiment pénible et compliqué. Ce serait un miracle si les programmeurs ne sautaient pas d'un immeuble. Héhé... je plaisante)
Adresse originale : https://blog.csdn.net/hanxuemin12345/article/details/8544957/