Scrapy — это прикладной фреймворк, написанный на Python, для сканирования данных веб-сайтов и извлечения структурированных данных.
Scrapy часто используется в ряде программ, включая интеллектуальный анализ данных, обработку информации или хранение исторических данных.
Обычно мы можем легко реализовать краулер с помощью фреймворка Scrapy, чтобы собирать содержимое или изображения указанного веб-сайта.
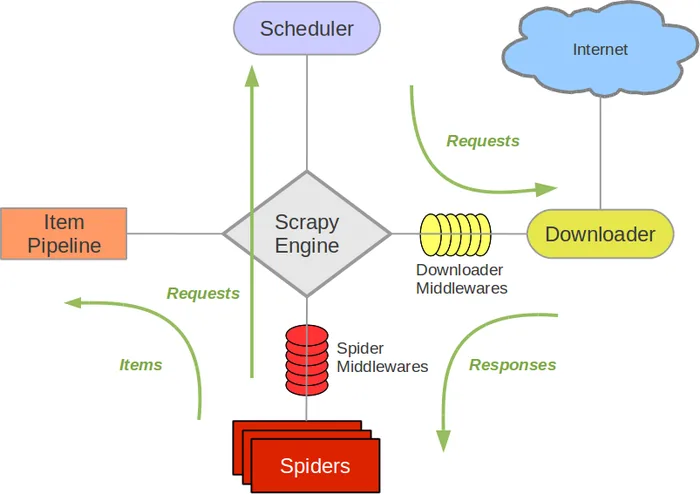
Схема архитектуры Scrapy (зелёные линии обозначают поток данных)
-
Scrapy Engine: отвечает за связь, сигналы, передачу данных и т. д. между Spider, ItemPipeline, Downloader и Scheduler.
-
Scheduler: он отвечает за приём запросов Request, отправленных движком, их организацию и упорядочивание определённым образом, постановку в очередь и возврат движку, когда они ему нужны.
-
Downloader: он отвечает за загрузку всех Requests, отправленных Scrapy Engine, и возврат полученных Responses в Scrapy Engine, который затем передаёт их Spider для обработки.
-
Spider: он отвечает за обработку всех Responses, анализ и извлечение из них данных, получение данных, необходимых для полей Item, и отправку движку URL-адресов, по которым нужно перейти, после чего они снова попадают в Scheduler.
-
Item Pipeline: он отвечает за обработку Items, полученных от Spider, и является местом для постобработки (детального анализа, фильтрации, хранения и т. д.).
-
Downloader Middlewares: его можно рассматривать как компонент, позволяющий настраиваемо расширять функциональность загрузки.
-
Spider Middlewares: его можно понимать как функциональный компонент, позволяющий настраиваемо расширять и управлять взаимодействием между движком и Spider (например, Responses, поступающие в Spider, и Requests, покидающие Spider).
Процесс работы Scrapy
Как только код написан, программа запускается...
- 1 Engine: Привет! Spider, какой сайт ты хочешь обработать?
- 2 Spider: Босс хочет, чтобы я обработал xxxx.com.
- 3 Engine: Дай мне первый URL для обработки.
- 4 Spider: Держи, первый URL — xxxxxxx.com.
- 5 Engine: Привет! Scheduler, у меня есть запрос, пожалуйста, отсортируй и поставь его в очередь для меня.
- 6 Scheduler: Хорошо, я обрабатываю его, подожди немного.
- 7 Engine: Привет! Scheduler, дай мне обработанный запрос.
- 8 Scheduler: Держи, это обработанный запрос.
- 9 Engine: Привет! Downloader, пожалуйста, скачай этот запрос в соответствии с настройками downloader middleware босса.
- 10 Downloader: Хорошо! Держи, это загруженное содержимое. (Если не удалось: извините, этот запрос не удалось скачать. Тогда Engine сообщает Scheduler, что этот запрос не удалось скачать, запиши это, и мы скачаем его снова позже.)
- 11 Движок: Привет! Паук, это загруженное содержимое, и оно уже обработано в соответствии с middleware загрузчика босса. Разбирайся сам. (Примечание! Здесь ответ по умолчанию передаётся в функцию def parse() для обработки.)
- 12 Паук: (После обработки данных, для URL, по которым нужно перейти дальше), Привет! Движок, у меня здесь два результата. Это URL, по которому мне нужно перейти дальше, а это данные Item, которые я получил.
- 13 Движок: Привет! Конвейер, у меня здесь есть Item, обработай его, пожалуйста! Планировщик! Это URL, требующий последующей обработки, обработай его, пожалуйста. Затем повторяйте с шага 4, пока не будет получена вся информация, нужная боссу.
- 14 Конвейер и Планировщик: Хорошо, мы сделаем это прямо сейчас!
Примечание! Вся программа остановится только тогда, когда в планировщике больше не останется запросов. (То есть для URL, которые не удалось загрузить, Scrapy также загрузит их снова.)
Создание краулера Scrapy требует всего 4 шагов:
- Создайте новый проект (scrapy startproject xxx): Создайте новый проект краулера.
- Определите цель (напишите items.py): Определите цель, которую вы хотите обойти.
- Создайте краулер (spiders/xxspider.py): Создайте краулер, чтобы начать обход веб-страниц.
- Сохраните содержимое (pipelines.py): Спроектируйте конвейеры для сохранения собранного содержимого.
Установка
Способ установки в Windows
Обновите версию pip:
pip install --upgrade pip
Установите фреймворк Scrapy через pip:
pip install Scrapy
Способ установки в Ubuntu
Установите зависимости, не относящиеся к Python:
sudo apt-get install python-dev python-pip libxml2-dev libxslt1-dev zlib1g-dev libffi-dev libssl-dev
Установите фреймворк Scrapy через pip:
sudo pip install scrapy
Способ установки в Mac OS
В системе Mac OS, поскольку сама система ссылается на свои встроенные библиотеки python2.x, пакеты, установленные по умолчанию, нельзя удалить. Однако установка Scrapy с python2.x выдаст ошибку, а установка с python3.x также выдаст ошибку. В конце концов, я не нашёл способа установить Scrapy напрямую, поэтому объясню шаги установки с использованием другого способа. Решение — использовать virtualenv для установки.
$ sudo pip install virtualenv
$ virtualenv scrapyenv
$ cd scrapyenv
$ source bin/activate
$ pip install Scrapy
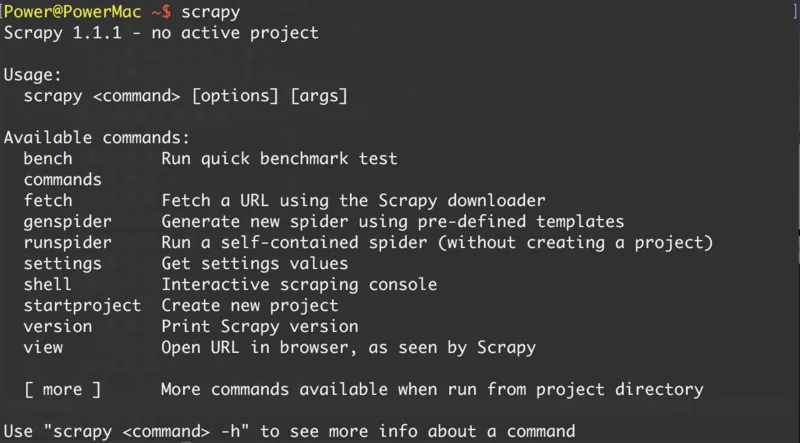
После установки просто введите scrapy в командном терминале, и если отобразится результат, подобный следующему, это означает, что установка прошла успешно.
Пример для начала работы
Цели обучения
- Создайте проект Scrapy
- Определите структурированные данные (Item) для извлечения
- Напишите Spider для обхода веб-сайта и извлечения структурированных данных (Item)
- Напишите Item Pipelines для сохранения извлечённых Items (то есть структурированных данных)
1. Создайте новый проект (scrapy startproject)
Перед началом сканирования необходимо создать новый проект Scrapy. Перейдите в каталог пользовательского проекта и выполните следующую команду:
scrapy startproject mySpider
Здесь mySpider — имя проекта. Вы увидите, что создаётся папка mySpider, и структура каталогов примерно следующая:
Кратко опишем назначение каждого основного файла:
mySpider/
    scrapy.cfg
    mySpider/
        __init__.py
        items.py
        pipelines.py
        settings.py
        spiders/
            __init__.py
            ...
Эти файлы:
- scrapy.cfg: файл конфигурации проекта.
- mySpider/: Python-модуль проекта, откуда будет ссылаться код.
- mySpider/items.py: целевой файл проекта.
- mySpider/pipelines.py: файл конвейера проекта.
- mySpider/settings.py: файл настроек проекта.
- mySpider/spiders/: каталог, в котором хранится код краулера.
2. Определите цель (mySpider/items.py)
Мы планируем собратьhttp://www.itcast.cn/channel/teacher.shtmlимена, должности и личную информацию всех преподавателей на сайте.
Откройте items.py в каталоге mySpider.
Item определяет структурированные поля данных, используемые для сохранения собранных данных. Он несколько похож на dict в Python, но обеспечивает дополнительную защиту, чтобы уменьшить количество ошибок.
Вы можете определить Item, создав класс scrapy.Item и определив атрибуты класса типа scrapy.Field (что можно понимать как аналог связи ORM-отображения).
Затем создайте класс ItcastItem и постройте модель Item.
import scrapy

class ItcastItem(scrapy.Item):
   name = scrapy.Field()
   title = scrapy.Field()
   info = scrapy.Field()
3. Создание краулера (spiders/itcastSpider.py)
Функциональность краулера нужно разделить на два шага:
1. Соберите данные
Введите команду в текущем каталоге, она создаст краулера с именем itcast в каталоге mySpider/spider и укажет область домена для сканирования:
scrapy genspider itcast "itcast.cn"
Откройте itcast.py в каталоге mySpider/spider. По умолчанию добавлен следующий код:
import scrapy

class ItcastSpider(scrapy.Spider):
    name = "itcast"
    allowed_domains = ["itcast.cn"]
    start_urls = (
        'http://www.itcast.cn/',
    )

    def parse(self, response):
        pass
На самом деле мы также можем создать itcast.py сами и написать приведённый выше код, но использование команды избавляет от необходимости писать фиксированный шаблонный код.
Чтобы создать Spider, необходимо создать подкласс, используя класс scrapy.Spider, и определить три обязательных атрибута и один метод.
name = "" : идентификационное имя этого паука. Оно должно быть уникальным; разные пауки должны определять разные имена.
allow_domains = [] — это область поиска доменов, то есть ограниченная область паука. Он указывает, что паук обходит только страницы в этом домене, а несуществующие URL будут игнорироваться.
start_urls = () : кортеж/список URL для обхода. Паук начинает получение данных отсюда, поэтому первые загруженные данные будут начинаться с этих URL. Другие дочерние URL будут генерироваться путём наследования от этих начальных URL.
parse(self, response) : метод разбора. Он будет вызван после загрузки каждого начального URL. При вызове он принимает объект Response, возвращённый для каждого URL, в качестве единственного параметра. Его основные функции таковы:
Отвечает за разбор возвращённых данных веб-страницы (response.body) и извлечение структурированных данных (создание items).
Генерирует URL-запросы для следующей страницы.
Измените значение start_urls на первый url, который нужно обойти.
start_urls = ("http://www.itcast.cn/channel/teacher.shtml",)
Измените метод parse().
def parse(self, response):
    filename = "teacher.html"
    open(filename, 'w').write(response.body)
Затем запустите, чтобы увидеть. Выполните в каталоге mySpider:
scrapy crawl itcast
Да, это itcast. Глядя на код выше, это атрибут name класса ItcastSpider, который является уникальным именем паука при использовании команды scrapy genspider.
После запуска, если в напечатанном логе отображается [scrapy] INFO: Spider closed (finished), это означает, что выполнение завершено. После этого в текущей папке появляется файл teacher.html, который содержит всю информацию исходного кода веб-страницы, которую мы только что обошли.
Примечание:Среда кодировки по умолчанию для Python2.x — ASCII. Когда она не соответствует формату кодировки полученных данных, может возникнуть искажённый текст; мы можем указать формат кодировки сохраняемого содержимого. Обычно мы можем добавить в начале кода:
import sys
reload(sys)
sys.setdefaultencoding("utf-8")
Эти три строки кода — универсальный ключ к решению проблем с китайской кодировкой в Python2.x. После стольких лет жалоб Python3 усвоил урок, и его кодировка по умолчанию — Unicode... (Желаю всем скорее перейти на Python3)
2. Извлечение данных
После сканирования всей веб-страницы следующим шагом является процесс извлечения. Сначала посмотрите на исходный код страницы:
<div class="li_txt">
    <h3>  xxx  </h3>
    <h4> xxxxx </h4>
    <p> xxxxxxxx </p>
Разве не ясно с первого взгляда? Сразу используйте XPath, чтобы начать извлекать данные.
Для метода xpath нам нужно только ввести правила xpath, чтобы найти соответствующие узлы html-тегов. Подробнее можно посмотреть здесь:руководство по xpath。
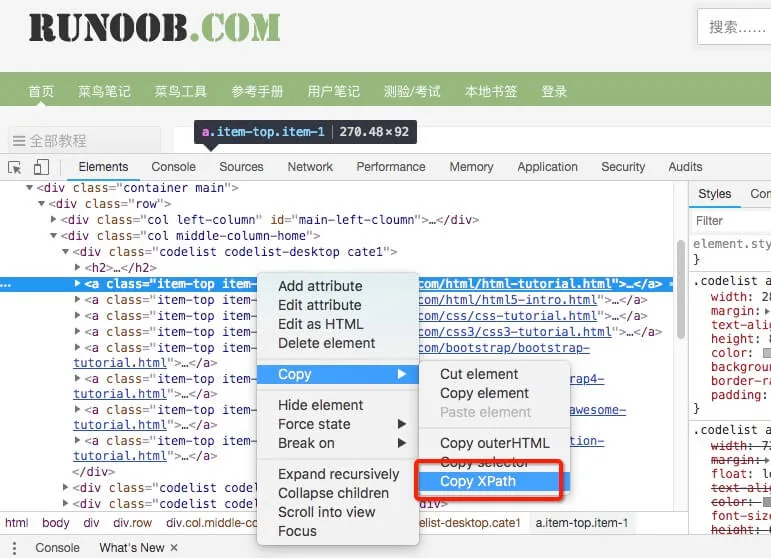
Незнание синтаксиса xpath не имеет значения. Chrome предоставляет нам способ получить xpath-адрес в один клик (Right-click -> Inspect -> Copy -> Copy XPath), как показано ниже:
Вот несколько примеров выражений XPath и их соответствующие значения:
/html/head/title: Выбрать в HTML-документе<head>тег внутри<title>элемент/html/head/title/text(): Выбрать вышеупомянутый<title>текст элемента//td: Выбрать все<td>элементов//div[@class="mine"]: Выделить все с помощьюclass="mine"атрибутdivэлементов
Например, мы читаем у сайтаhttp://www.itcast.cn/заголовок. Измените код файла itcast.py следующим образом:
# -*- coding: utf-8 -*-
import scrapy

# 以下三行是在 Python2.x版本中解决乱码问题,Python3.x 版本的可以去掉
import sys
reload(sys)
sys.setdefaultencoding("utf-8")

class Opp2Spider(scrapy.Spider):
    name = 'itcast'
    allowed_domains = ['itcast.com']
    start_urls = ['http://www.itcast.cn/']

    def parse(self, response):
        # 获取网站标题
        context = response.xpath('/html/head/title/text()')

        # 提取网站标题
        title = context.extract_first()
        print(title)
        pass
Выполните следующую команду:
$ scrapy crawl itcast
...
...
传智播客官网-好口碑IT培训机构,一样的教育,不一样的品质
...
...
Ранее мы определили класс ItcastItem в mySpider/items.py. Здесь мы импортируем его:
from mySpider.items import ItcastItem
Затем инкапсулируем полученные данные в объект ItcastItem, который может сохранять атрибуты каждого преподавателя:
from mySpider.items import ItcastItem

def parse(self, response):
    #open("teacher.html","wb").write(response.body).close()

    # 存放老师信息的集合
    items = []

    for each in response.xpath("//div[@class='li_txt']"):
        # 将我们得到的数据封装到一个 `ItcastItem` 对象
        item = ItcastItem()
        #extract()方法返回的都是unicode字符串
        name = each.xpath("h3/text()").extract()
        title = each.xpath("h4/text()").extract()
        info = each.xpath("p/text()").extract()

        #xpath返回的是包含一个元素的列表
        item['name'] = name[0]
        item['title'] = title[0]
        item['info'] = info[0]

        items.append(item)

    # 直接返回最后数据
    return items
Пока мы не будем работать с pipeline; подробно рассмотрим его позже.
Сохранение данных
Простейшие способы сохранения информации в scrapy в основном включают четыре типа. -o выводит файлы в указанном формате с помощью следующих команд:
scrapy crawl itcast -o teachers.json
формат json lines, по умолчанию используется кодировка Unicode
scrapy crawl itcast -o teachers.jsonl
формат csv с разделением запятыми, можно открыть в Excel
scrapy crawl itcast -o teachers.csv
формат xml
scrapy crawl itcast -o teachers.xml
Размышление
Если изменить код на следующую форму, результат будет точно таким же.
Пожалуйста, подумайте о роли yield здесь (Краткий анализ использования yield в Python):
# -*- coding: utf-8 -*-
import scrapy
from mySpider.items import ItcastItem

# 以下三行是在 Python2.x版本中解决乱码问题,Python3.x 版本的可以去掉
import sys
reload(sys)
sys.setdefaultencoding("utf-8")

class Opp2Spider(scrapy.Spider):
    name = 'itcast'
    allowed_domains = ['itcast.com']
    start_urls = ("http://www.itcast.cn/channel/teacher.shtml",)

    def parse(self, response):
        #open("teacher.html","wb").write(response.body).close()

        # 存放老师信息的集合
        items = []

        for each in response.xpath("//div[@class='li_txt']"):
            # 将我们得到的数据封装到一个 `ItcastItem` 对象
            item = ItcastItem()
            #extract()方法返回的都是unicode字符串
            name = each.xpath("h3/text()").extract()
            title = each.xpath("h4/text()").extract()
            info = each.xpath("p/text()").extract()

            #xpath返回的是包含一个元素的列表
            item['name'] = name[0]
            item['title'] = title[0]
            item['info'] = info[0]

            items.append(item)

        # 直接返回最后数据
        return items
Исходная ссылка: https://segmentfault.com/a/1190000013178839