Das ist ein sehr interessantesNon-mainstream frontend fieldGebiet. Es untersucht, wie man Engineering-Methoden einsetzt, um das umfassende Problem der Frontend-Entwicklung und Deployment-Optimierung zu lösen. Ich lerne und praktiziere, seit ich in die Branche eingestiegen bin.
Meiner Meinung nach ist Facebook der Pionier auf diesem Gebiet. Wer interessiert ist und ein VPN hat, kann sich den Quellcode von Facebooks Seite ansehen und verstehen, was Engineering wirklich bedeutet.
Als Nächstes möchte ich von den Prinzipien her erklären. Es gibt viele Bilder und es ist ziemlich lang; ich hoffe, du bist geduldig genug, bis zum Ende zu lesen.
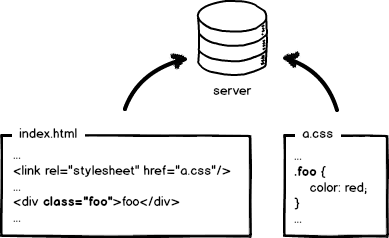
Kehren wir zu den Grundlagen zurück und beginnen mit der ursprünglichen Frontend-Entwicklung. Das obige Bild zeigt eine "süße" index.html-Seite und ihre Stildatei a.css. Schreibe den Code in einem Texteditor, keine Kompilierung nötig, sieh ihn dir lokal in der Vorschau an, bestätige, dass es OK ist, lade ihn auf den Server und warte, bis Nutzer sie besuchen. Frontend ist so einfach, so spaßig, die Einstiegshürde ist so niedrig, man kann es in Minuten lernen, oder?!
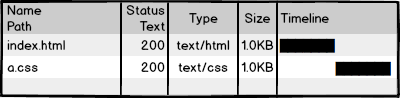
Dann besuchen wir die Seite, sehen den Effekt und prüfen die Netzwerkanfrage: 200! Nicht schlecht, verdammt perfekt! Also, ist die Entwicklung abgeschlossen ... fertig?
Warte, das ist noch nicht vorbei! Für große Unternehmen sorgen der wahnsinnige Traffic und die Performance-Kennzahlen dafür, dass Frontend überhaupt keinen "Spaß" mehr macht.
Sieh dir die Anfrage für a.css an. Wenn sie jedes Mal geladen wird, wenn ein Nutzer die Seite besucht, wirkt sich das nicht auf die Performance aus und verschwendet Bandbreite? Wir hoffen, es wäre so:
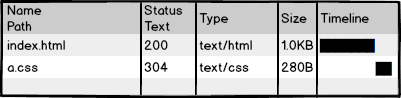
Verwende 304, damit der Browser den lokalen Cache nutzt. Aber reicht das? Nein! 304 nennt man ausgehandeltes Caching; es muss trotzdem einmal mit dem Server kommunizieren. Unser Optimierungsniveau ist wahnsinnig, also müssen wir diese Anfrage komplett eliminieren, sodass es so aussieht:
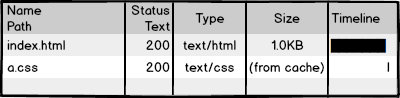
Erzwinge, dass der Browser den lokalen Cache nutzt (cache-control/expires), ohne Kommunikation mit dem Server. OK, die Optimierung auf der Anfrageseite hat ein wahnsinniges Niveau erreicht, aber hier ist die Frage: Wenn du den Browser keine Ressourcenanfragen senden lässt, wie wird der Cache dann aktualisiert?
Gut, ich glaube, jemand hat an eine Lösung gedacht:Durch die Aktualisierung der in der Seite referenzierten Ressourcenpfade wird der Browser dazu gebracht, den Cache freiwillig aufzugeben und neue Ressourcen zu laden.So:
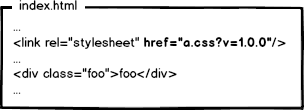
Beim nächsten Release ändert man die Link-Adressen auf neue Versionen, und die Ressourcen werden aktualisiert, richtig? OK, ist das Problem gelöst?! Natürlich nicht! Der Wahnsinn der großen Unternehmen schlägt wieder zu. Denk an diese Situation:
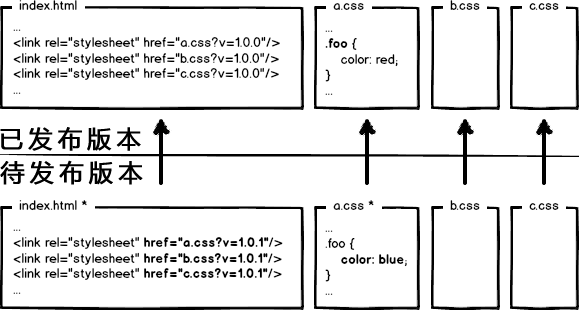
Die Seite referenziert 3 CSS-Dateien, aber ein bestimmtes Release hat nur a.css geändert. Wenn alle Link-Versionen aktualisiert werden, werden auch die Caches von b.css und c.css ungültig. Wäre das nicht wieder verschwenderisch?!
Wenn wir wieder den Wahnsinnsmodus einschalten, können wir leicht erkennen, dass zur Lösung dieses Problems URL-Änderungen an den Dateiinhalt gebunden werden müssen. Das heißt, nur wenn sich der Dateiinhalt ändert, ändert sich die entsprechende URL, wodurch eine präzise Cache-Steuerung auf Dateiebene erreicht wird.
Was hängt mit dem Dateiinhalt zusammen? Wir denken natürlich daran, einen Daten-Digest-Algorithmus zu verwenden, um Digest-Informationen für Dateien zu berechnen. Da Digest-Informationen eins zu eins dem Dateiinhalt entsprechen, haben wir nun eine Grundlage für eine dateigenaue Cache-Steuerung. OK, ändern wir die URLs so, dass sie die Digest-Informationen enthalten:
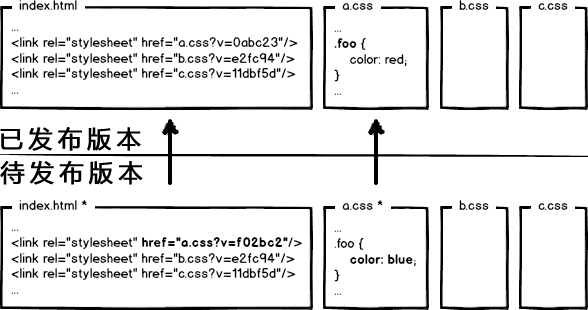
Diesmal wird, wenn eine Datei geändert wird, nur die dieser Datei entsprechende URL aktualisiert. An diesem Punkt scheint es perfekt. Glaubst du, das reicht? Große Unternehmen sagen dir: Zu jung, zu simpel!
Seufz~~~~, lass mich kurz durchatmen.
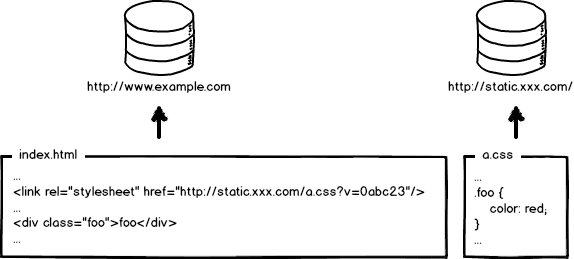
Um die Website-Performance weiter zu verbessern, deployen moderne Internetunternehmen statische Ressourcen und dynamische Webseiten in getrennten Clustern. Statische Ressourcen werden auf CDN-Knoten bereitgestellt, und die in Webseiten referenzierten Ressourcen werden ebenfalls zu entsprechenden Deployment-Pfaden:
OK, wenn ich statische Ressourcen aktualisieren muss, aktualisiere ich auch die Referenzen im HTML, richtig? So:
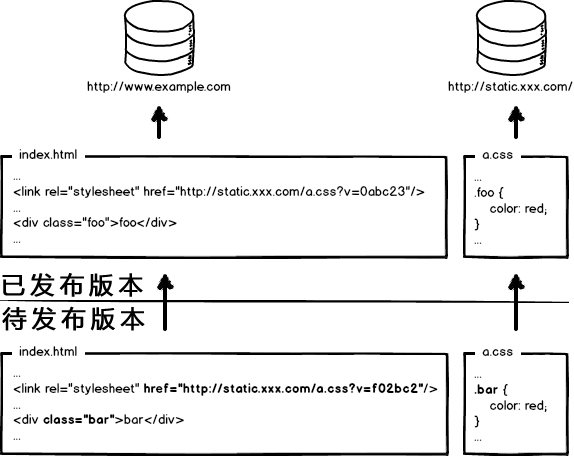
Dieses Release hat sowohl die Seitenstruktur als auch die Styles geändert und außerdem die URL-Adressen der statischen Ressourcen aktualisiert. Jetzt ist es an der Zeit, den Code zu deployen. Lieber Front-End-Entwickler, sag mir: Sollten wir zuerst die Seiten oder zuerst die statischen Ressourcen deployen?
Deploy the pages first, then deploy the resources: Wenn ein Benutzer die Seite in dem Zeitintervall zwischen den beiden Deployments besucht, lädt er alte Ressourcen in der neuen Seitenstruktur und speichert diese alte Version als die neue Version im Cache. Infolgedessen sieht der Benutzer eine Seite mit kaputten Styles. Wenn er nicht manuell neu lädt, läuft die Seite weiterhin fehlerhaft, bis der Ressourcen-Cache abläuft.Deploy the resources first, then deploy the pages: Innerhalb des Deployment-Intervalls besuchen Benutzer mit lokalen Caches alter Ressourcen die Website. Da die angeforderte Seite die alte Version ist und sich die Ressourcenverweise nicht geändert haben, verwendet der Browser direkt den lokalen Cache, sodass die Seite normal angezeigt wird. Doch Benutzer ohne lokale Caches oder mit abgelaufenen Caches sehen, wie die alte Seite neue Ressourcen lädt, was zu Fehlern bei der Seitenausführung führt. Sobald das Seiten-Deployment abgeschlossen ist, sind diese Benutzer beim nächsten Besuch wieder normal. OK, die ganze obige Analyse bedeutet: Egal, welche der beiden man zuerst deployt, es funktioniert nicht! Beides verursacht während des Deployments Seitenchaos. Deshalb kann man bei Projekten mit wenig Traffic den Entwickler ein bisschen leiden lassen, heimlich mitten in der Nacht deployen, zuerst die statischen Ressourcen online stellen und dann die Seiten deployen, was weniger Probleme zu verursachen scheint.
Große Unternehmen sind jedoch super verrückt; es gibt keinen solchen "absoluten Schwachlastzeitraum", nur einen "relativen Schwachlastzeitraum". Also müssen wir für einen stabilen Service weiterhin nach Perfektion streben!
Dieses bizarre Problem rührt vom überschreibenden Veröffentlichen von Ressourcen her. Bereits veröffentlichte Ressourcen mit noch zu veröffentlichenden Ressourcen zu überschreiben, verursacht dieses Problem. Die Lösung ist einfach: nicht überschreibendes Veröffentlichen implementieren.
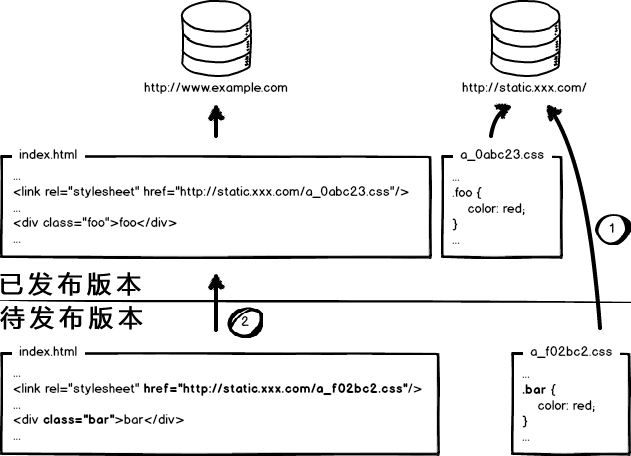
Schauen Sie sich die obige Abbildung an. Verwenden Sie die Digest-Informationen der Datei, um Ressourcendateien umzubenennen, und nehmen Sie die Digest-Informationen in den Veröffentlichungspfad der Ressourcendatei auf. Auf diese Weise werden Ressourcen mit geändertem Inhalt zu neuen Dateien, die online veröffentlicht werden, ohne vorhandene Ressourcendateien zu überschreiben. Beim Deployment werden zuerst statische Ressourcen vollständig bereitgestellt, dann Seiten graustufenweise bereitgestellt, und das ganze Problem ist ziemlich perfekt gelöst.
Daher muss die Optimierungslösung für statische Ressourcen in großen Unternehmen im Grunde diese Dinge umsetzen:
- Einen sehr langfristigen lokalen Cache konfigurieren — Bandbreite sparen, Leistung verbessern
- Inhalts-Digests als Grundlage für Cache-Aktualisierungen verwenden — präzise Cache-Steuerung
- CDN-Bereitstellung statischer Ressourcen — Netzwerkanfragen optimieren
- Ressourcen-Veröffentlichungspfade ändern, um eine nicht überschreibende Veröffentlichung umzusetzen — reibungslose Upgrades
Wenn man das komplette Set umsetzt, erhält man eine relativ vollständige Lösung zur Cache-Steuerung für statische Ressourcen. Beachten Sie außerdem, dass die Cache-Steuerung für statische Ressourcen erfordert, dassalle Stellen, an denen im Frontend statische Ressourcen geladen werden, auf diese Weise behandelt werden müssen. Ja, alle! Ganz zu schweigen von JS und CSS, müssen auch Ressourcenpfade einbezogen werden, auf die in JS- und CSS-Dateien verwiesen wird. Da Digest-Informationen im Spiel sind, verändern die Digest-Informationen referenzierter Ressourcen auch den Inhalt der referenzierenden Datei selbst, was kaskadierende Digest-Änderungen erzeugt. Eine grobe Darstellung wäre:
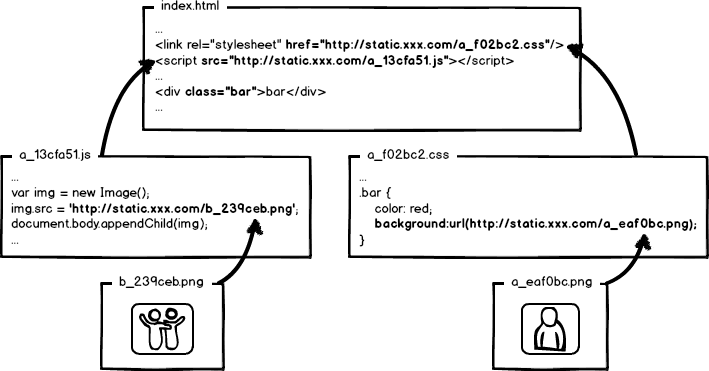
OK, wir haben schnell die Optimierungs- und Deployment-Probleme kennengelernt, mit denen das Frontend-Engineering beim Caching statischer Ressourcen konfrontiert ist. Jetzt taucht ein neues Problem auf: Wie zum Teufel sollen Entwickler Code wie diesen schreiben!!!
Um den kombinierten Ansatz aus Optimierung und Engineering zu erklären, werden eine Menge Engineering-Themen auftauchen, wie modulare Entwicklung, Ressourcenladen, Request-Zusammenführung, Frontend-Frameworks und so weiter. Das Obige ist nur der Anfang; die Lösung ist das Wesentliche, aber es gibt viel zu viel zu sagen. Ich werde darauf nach und nach eingehen, wenn ich Zeit habe.
Kurz gesagt, Frontend-Performance-Optimierung ist definitiv ein Engineering-Problem!
Das oben Gesagte ist nicht nur meine Einbildung. Sie können die Seiten und den Quellcode statischer Ressourcen von Baidu oder Facebook untersuchen, deren Handhabung von Ressourcenverweispfaden und die Cache-Steuerung statischer Ressourcen in Netzwerkanfragen prüfen. Einmal mehr bewundere ich das Niveau des Frontend-Engineerings von Facebook; ich bin ehrfürchtig.
Ich schlage vor, dass Frontend-Entwickler dem Bereich Frontend-Engineering mehr Aufmerksamkeit schenken. Manche mögen denken, ihre Produkte seien klein und müssten nicht so verrückt sein, aber es ist sehr wahrscheinlich, dass Sie eines Tages solche Änderungen vornehmen müssen. Außerdem, wenn wir Dinge perfekter machen können, warum nicht?
Denken Sie auch nicht, dass dies Probleme sind, die von Operations- oder Backend-Entwicklern gelöst werden müssen. Wenn sie anderen Rollen überlassen werden,neigt jeder dazu, Probleme, die ihn nicht interessieren, anderen zuzuwerfen., dann wird der Entwicklungsprozess von Frontend-Entwicklern stark eingeschränkt. Diese Situation ist selbst in einigen großen Unternehmen nicht ungewöhnlich!
Quelle: http://www.zhihu.com/question/20790576/answer/32602154