C'est un domaine très intéressant.Non-mainstream frontend fieldIl explore comment utiliser des méthodes d'ingénierie pour résoudre le problème global de l'optimisation du développement et du déploiement front-end. J'apprends et je mets en pratique depuis mon entrée dans le secteur.
D'après mon impression, Facebook est le pionnier dans ce domaine. Ceux que cela intéresse et qui ont un VPN peuvent consulter le code source de la page Facebook et comprendre ce que l'ingénierie signifie vraiment.
Ensuite, je veux expliquer à partir des principes. Il y a beaucoup d'images et c'est assez long ; j'espère que vous serez suffisamment patients pour lire jusqu'au bout.
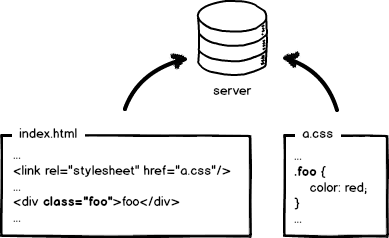
Revenons aux bases et commençons par le développement front-end primitif. L'image ci-dessus est une page index.html « mignonne » et son fichier de style a.css. Écrivez le code dans un éditeur de texte, aucune compilation nécessaire, prévisualisez localement, confirmez que c'est OK, mettez-le sur le serveur et attendez que les utilisateurs viennent. Le front-end, c'est aussi simple, tellement amusant, la barrière d'entrée est si basse, on peut l'apprendre en quelques minutes, non ?!
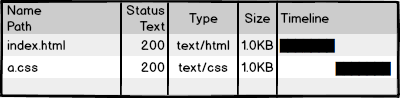
Ensuite, nous visitons la page, voyons le résultat et vérifions la requête réseau : 200 ! Pas mal, trop parfait ! Alors, le développement est terminé... fini ?
Attendez, ce n'est pas encore fini ! Pour les grandes entreprises, le trafic démesuré et les métriques de performance rendront le front-end tout sauf « amusant ».
Regardez la requête pour a.css. Si elle est chargée à chaque fois qu'un utilisateur visite la page, cela n'affecte-t-il pas les performances et ne gaspille-t-il pas de la bande passante ? Nous espérons que ce serait comme ceci :
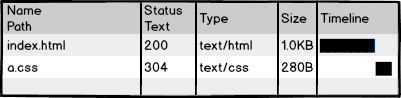
Utilisez 304 pour laisser le navigateur utiliser le cache local. Mais est-ce suffisant ? Non ! 304 s'appelle la mise en cache négociée ; il faut quand même communiquer une fois avec le serveur. Notre niveau d'optimisation est dingue, nous devons donc complètement éliminer cette requête, pour obtenir ceci :
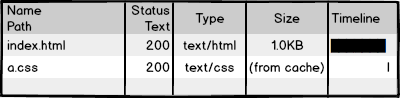
Forcez le navigateur à utiliser le cache local (cache-control/expires), sans communication avec le serveur. OK, l'optimisation côté requête a atteint un niveau dingue, mais voici la question : si vous ne laissez pas le navigateur envoyer de requêtes de ressources, comment le cache se met-il à jour ?
Bien, je crois que quelqu'un a pensé à une solution :En mettant à jour les chemins des ressources référencées dans la page, le navigateur est amené à abandonner volontairement le cache et à charger les nouvelles ressources.Comme ceci :
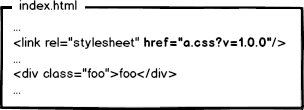
À la prochaine version, on change les adresses des liens vers de nouvelles versions, et les ressources sont mises à jour, non ? OK, le problème est résolu ?! Bien sûr que non. La folie des grandes entreprises frappe encore. Réfléchissez à ceci :
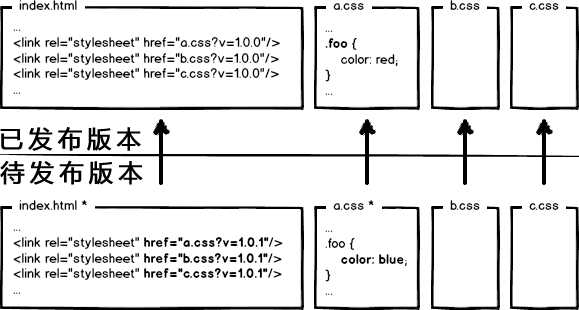
La page référence 3 fichiers CSS, mais une certaine version n'a modifié que a.css. Si toutes les versions des liens sont mises à jour, les caches de b.css et c.css seront aussi invalidés. Ne serait-ce pas encore du gaspillage ?!
En repassant en mode fou, on voit facilement que pour résoudre ce problème, les changements d'URL doivent être liés au contenu du fichier. Autrement dit, ce n'est que lorsque le contenu du fichier change que l'URL correspondante change, ce qui permet d'obtenir un contrôle précis du cache au niveau du fichier.
Qu'est-ce qui est lié au contenu du fichier ? On pense naturellement à utiliser un algorithme d'empreinte de données pour calculer les empreintes des fichiers. Comme les empreintes correspondent un à un au contenu du fichier, nous avons maintenant une base pour un contrôle du cache précis au niveau de chaque fichier. OK, modifions les URL pour inclure les empreintes :
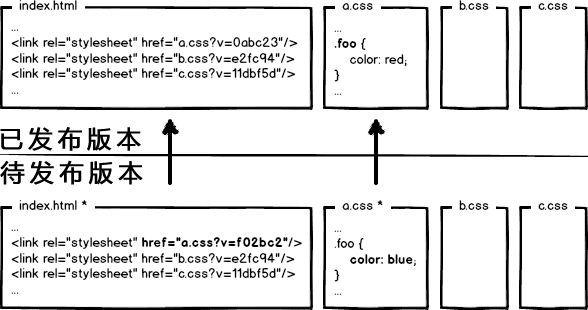
Cette fois, lorsqu'un fichier est modifié, seule l'URL correspondant à ce fichier est mise à jour. Cela semble parfait à ce stade. Vous pensez que c'est suffisant ? Les grandes entreprises vous disent : Trop jeune, trop simple !
Soupir~~~~, laissez-moi reprendre mon souffle.
Pour améliorer encore les performances du site web, les entreprises Internet modernes déploient les ressources statiques et les pages web dynamiques dans des clusters séparés. Les ressources statiques sont déployées sur des nœuds CDN, et les ressources référencées dans les pages web deviennent aussi des chemins de déploiement correspondants :
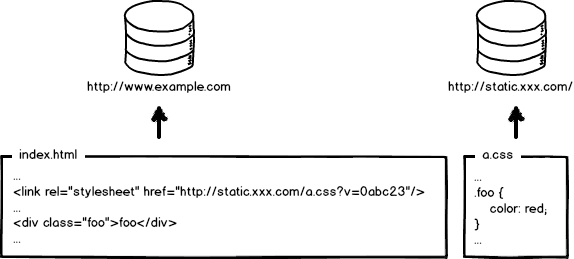
OK, quand je dois mettre à jour les ressources statiques, je mets aussi à jour les références dans le HTML, non ? Comme ceci :
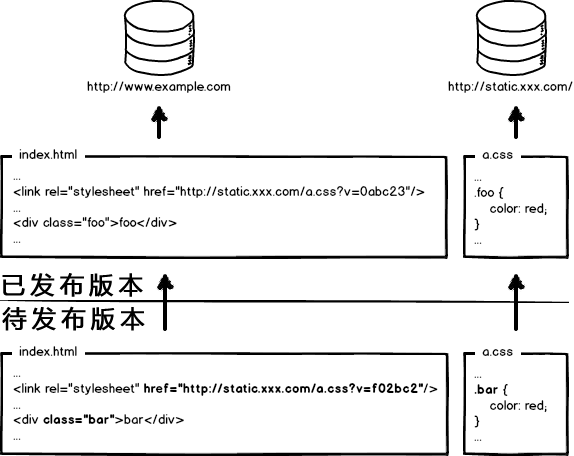
Cette version a modifié à la fois la structure de la page et les styles, et a également mis à jour les adresses URL des ressources statiques. Il est maintenant temps de déployer le code. Cher développeur front-end, dites-moi : faut-il déployer d'abord les pages, ou d'abord les ressources statiques ?
Deploy the pages first, then deploy the resources: Dans l'intervalle de temps entre les deux déploiements, si un utilisateur visite la page, il chargera les anciennes ressources dans la nouvelle structure de page et mettra en cache cette ancienne version comme la nouvelle version. Par conséquent, l'utilisateur voit une page avec des styles cassés. À moins qu'il n'actualise manuellement, la page continuera de fonctionner incorrectement jusqu'à l'expiration du cache des ressources.Deploy the resources first, then deploy the pages: Pendant l'intervalle de déploiement, les utilisateurs disposant de caches locaux d'anciennes ressources visitent le site. Comme la page demandée est l'ancienne version et que les références aux ressources n'ont pas changé, le navigateur utilise directement le cache local, donc la page s'affiche normalement. Mais les utilisateurs sans cache local ou avec un cache expiré verront l'ancienne page charger de nouvelles ressources, provoquant des erreurs d'exécution de la page. Une fois le déploiement de la page terminé, ces utilisateurs reviendront à la normale lors de leur prochaine visite. Bon, toute la masse d'analyse ci-dessus signifie : déployer l'un ou l'autre en premier ne fonctionnera pas ! Les deux causeront de la confusion sur la page pendant le déploiement. Par conséquent, pour les projets à faible trafic, vous pouvez faire un peu souffrir le développeur, déployer secrètement au milieu de la nuit, mettre d'abord les ressources statiques en ligne, puis déployer les pages, ce qui semble poser moins de problèmes.
Cependant, les grandes entreprises sont complètement dingues ; il n'existe pas de « période de pointe basse absolue », seulement une « période de pointe basse relative ». Donc, pour un service stable, nous devons continuer à viser l'ultime !
Ce problème bizarre provient de la publication de ressources par écrasement. Écraser des ressources déjà publiées avec des ressources à publier provoque ce problème. Le résoudre est simple : mettre en œuvre une publication sans écrasement.
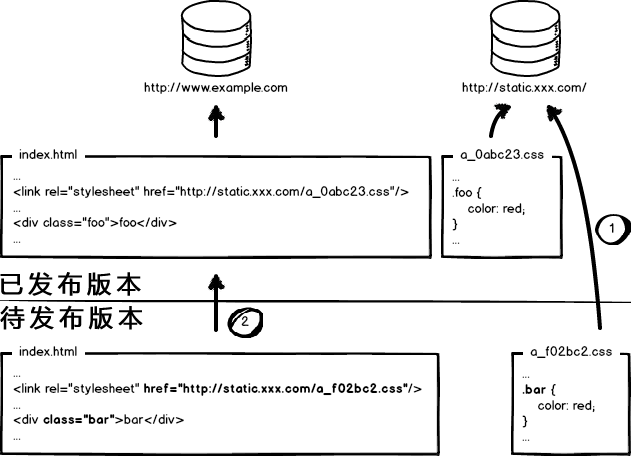
Regardez la figure ci-dessus. Utilisez les informations de digest du fichier pour renommer les fichiers de ressources, et placez les informations de digest dans le chemin de publication du fichier de ressources. Ainsi, les ressources dont le contenu a été modifié deviennent de nouveaux fichiers publiés en ligne, sans écraser les fichiers de ressources existants. Lors du déploiement, déployez d'abord entièrement les ressources statiques, puis déployez les pages en mode grayscale, et tout le problème est résolu de manière assez parfaite.
Par conséquent, la solution d'optimisation des ressources statiques des grandes entreprises doit essentiellement mettre en œuvre ces éléments :
- Configurer un cache local à très long terme — économiser de la bande passante, améliorer les performances
- Utiliser les digests de contenu comme base des mises à jour du cache — contrôle précis du cache
- Déploiement CDN des ressources statiques — optimiser les requêtes réseau
- Modifier les chemins de publication des ressources pour mettre en œuvre une publication sans écrasement — des mises à niveau fluides
Faire l'ensemble complet donne une solution de contrôle du cache des ressources statiques relativement complète. Notez aussi que le contrôle du cache des ressources statiques exige quetous les endroits où des ressources statiques sont chargées dans le front-end soient traités de cette manière. Oui, tous ! Sans parler de JS et CSS, cela doit aussi inclure les chemins de ressources référencés dans les fichiers JS et CSS. Comme des informations de digest sont impliquées, les informations de digest des ressources référencées modifient aussi le contenu du fichier qui contient la référence lui-même, créant des changements de digest en cascade. Un schéma approximatif serait :
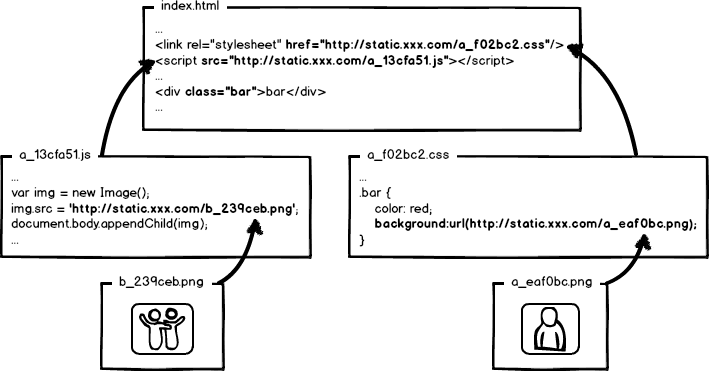
OK, nous avons rapidement découvert les problèmes d'optimisation et de déploiement que rencontre l'ingénierie front-end avec la mise en cache des ressources statiques. Maintenant, un nouveau problème se pose : comment diable les ingénieurs sont-ils censés écrire du code comme ça !!!
Pour expliquer l'approche combinée de l'optimisation et de l'ingénierie, tout un tas de problèmes d'ingénierie vont surgir, comme le développement modulaire, le chargement des ressources, la fusion des requêtes, les frameworks front-end, etc. Ce qui précède n'est que le début ; la solution est l'essentiel, mais il y a bien trop à dire. Je développerai cela lentement quand j'aurai le temps.
En bref, l'optimisation des performances front-end est définitivement un problème d'ingénierie !
Ce qui précède n'est pas qu'une simple imagination de ma part. Vous pouvez observer les pages de Baidu ou de Facebook ainsi que le code source de leurs ressources statiques, examiner la gestion de leurs chemins de référence de ressources, et le contrôle du cache des ressources statiques dans les requêtes réseau. Une fois de plus, j'admire le niveau de construction d'ingénierie front-end de Facebook ; je suis en admiration.
Je suggère que les ingénieurs front-end accordent plus d'attention au domaine de l'ingénierie front-end. Certains peuvent penser que leurs produits sont petits et n'ont pas besoin d'être aussi fous, mais il est très probable qu'un jour vous deviez apporter de tels changements. D'ailleurs, si nous pouvons faire les choses plus parfaitement, pourquoi ne pas le faire ?
De plus, ne pensez pas que ce sont des problèmes que les ingénieurs d'exploitation ou back-end doivent résoudre. Si on les laisse à d'autres rôles,Tout le monde a tendance à refiler aux autres les problèmes dont il ne se soucie pas., alors le processus de développement des ingénieurs front-end sera grandement restreint. Cette situation n'est pas rare, même dans certaines grandes entreprises !
Source : http://www.zhihu.com/question/20790576/answer/32602154