El ordenamiento por mezcla es un algoritmo de ordenamiento eficiente basado en la operación de fusión. Este algoritmo es una aplicación muy típica del método de divide y vencerás (Divide and Conquer).
Primero consideremos cómo fusionar dos secuencias ordenadas. Esto es muy simple: basta con comparar el primer número de las dos secuencias, tomar el menor y luego eliminar ese número de la secuencia correspondiente. Luego se vuelve a comparar. Si una de las secuencias queda vacía, simplemente se extraen los datos de la otra secuencia en orden.
Se puede ver que la eficiencia de fusionar secuencias ordenadas es relativamente alta, pudiendo alcanzar O(n).
Una vez resuelto el problema de fusionar secuencias ordenadas, veamos el ordenamiento por mezcla. Su idea básica es dividir el array en dos grupos A y B. Si los datos dentro de cada grupo están ordenados, entonces es muy conveniente ordenar estos dos grupos. ¿Cómo lograr que los datos dentro de estos dos grupos estén ordenados?
Se puede dividir cada grupo A y B en dos subgrupos. Y así sucesivamente. Cuando un subgrupo dividido tiene un solo dato, se puede considerar que ese subgrupo ya está ordenado internamente, y luego basta con fusionar los dos subgrupos adyacentes. De esta manera, primero se descompone recursivamente la secuencia y luego se fusionan las secuencias, completando así el ordenamiento por mezcla.
La eficiencia del ordenamiento por mezcla es relativamente alta. Suponiendo que la longitud de la secuencia es N, se necesitan logN pasos en total para dividir la secuencia en subsecuencias pequeñas. Cada paso es un proceso de fusión de secuencias ordenadas, y su complejidad temporal se puede registrar como O(N), por lo que en total es O(N*logN). Debido a que el ordenamiento por mezcla opera siempre sobre datos adyacentes, también es relativamente eficiente entre los métodos de ordenamiento de O(N*logN) (ordenamiento rápido, ordenamiento por mezcla, ordenamiento de Shell, ordenamiento por montículos).
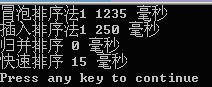
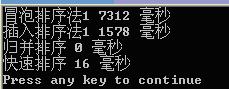
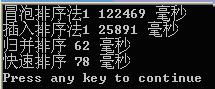
En mi computadora, se compararon el ordenamiento de burbuja, el ordenamiento por inserción directa, el ordenamiento por mezcla y el uso directo de la función qsort() del sistema (todos en versión Release).Prueba con 20000 datos aleatorios:
Prueba con 50000 datos aleatorios:
Prueba adicional con 200000 datos aleatorios:
Nota: algunos libros asignan un array temporal al fusionar secuencias ordenadas en mergearray(), pero demasiadas operaciones new consumen mucho tiempo. Por lo tanto, se hizo un pequeño cambio: solo se crea un array temporal con new en MergeSort(). Las operaciones posteriores comparten este único array temporal.
Autor: MoreWindows
Original: https://blog.csdn.net/morewindows/article/details/6678165