Le tri fusion est un algorithme de tri efficace basé sur des opérations de fusion. Cet algorithme est une application très typique de l'approche Diviser pour régner.
Considérons d'abord comment fusionner deux séquences ordonnées. C'est très simple : il suffit de comparer les premiers nombres des deux séquences, de prendre d'abord le plus petit, et de supprimer ce nombre de la séquence correspondante après l'avoir pris. Ensuite, comparez à nouveau ; si une séquence est vide, il suffit de retirer un par un les données de l'autre séquence.
On peut voir que la fusion de séquences ordonnées est relativement efficace et peut atteindre O(n).
Après avoir résolu le problème ci-dessus de la fusion de séquences ordonnées, examinons le tri fusion. Son idée de base est de diviser le tableau en deux groupes, A et B. Si les données de chaque groupe sont ordonnées, alors ces deux groupes de données peuvent être triés facilement. Comment faire pour que les données de ces deux groupes soient ordonnées ?
Vous pouvez en outre diviser les groupes A et B en deux groupes chacun. Et ainsi de suite. Lorsqu'un sous-groupe divisé ne contient qu'un seul élément de données, le sous-groupe peut être considéré comme déjà trié, puis fusionnez les deux sous-groupes adjacents. De cette façon, le tri par fusion est réalisé en décomposant d'abord récursivement la séquence, puis en fusionnant les séquences.
L'efficacité du tri par fusion est relativement élevée. Soit N la longueur de la séquence. Il faut au total logN étapes pour diviser la séquence en petites séquences. Chaque étape est un processus de fusion de séquences ordonnées, et la complexité temporelle peut être notée O(N), donc le total est O(N*logN). Comme le tri par fusion opère sur des données adjacentes à chaque fois, parmi plusieurs méthodes de tri en O(N*logN) (tri rapide, tri par fusion, tri de Shell, tri par tas), le tri par fusion est également relativement efficace.
Sur mon ordinateur, j'ai comparé le tri à bulles, le tri par insertion directe, le tri par fusion et l'utilisation directe du qsort() du système (tous en version Release).Test avec 20,000 éléments de données aléatoires :
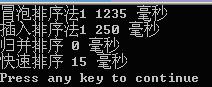
Test avec 50,000 éléments de données aléatoires :
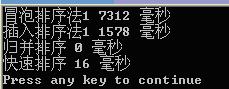
Puis testez avec 200,000 éléments de données aléatoires :
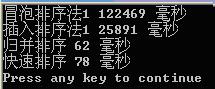
Remarque : certains livres allouent un tableau temporaire dans mergearray() lors de la fusion de séquences ordonnées, mais trop d'opérations new sont très coûteuses en temps. Une petite modification a donc été apportée. Un seul tableau temporaire est alloué avec new dans MergeSort(). Toutes les opérations suivantes partagent ce tableau temporaire.
Auteur : MoreWindows
Original : https://blog.csdn.net/morewindows/article/details/6678165