Je m'appelle Andrey Karpov. J'ai étudié des centaines d'erreurs causées par le « copier-coller ». On peut affirmer que les programmeurs font souvent des erreurs dans le dernier bloc d'une grande section de code. Aucun livre de programmation ne semble avoir traité ce phénomène, j'ai donc décidé d'en parler moi-même. Je l'appelle l'« effet de la dernière ligne ».
L'effet de la dernière ligne
Lorsqu'ils programment, les programmeurs doivent souvent écrire une série de structures similaires. Saisir ligne par ligne est ennuyeux et inefficace. C'est pourquoi ils utilisent la technique du « copier-coller » : un morceau de code est copié et collé plusieurs fois, puis modifié. Tout le monde connaît l'inconvénient : il est facile d'oublier de modifier quelque chose après le collage, ce qui finit par engendrer des bogues. Malheureusement, il n'y a souvent pas de meilleure solution.
Alors, quel schéma ai-je découvert ? J'ai constaté que les erreurs se produisent souvent dans le dernier bloc de code collé.
Voici un bref exemple :
inline Vector3int32& operator+=(const Vector3int32& other) {
  x += other.x;
  y += other.y;
  z += other.y;
  return *this;
}
Remarquez cette ligne : « z += other.y; ». Le programmeur a oublié de remplacer 'y' par 'z'.
Vous pourriez penser qu'il s'agit d'un exemple hypothétique, mais il provient en réalité d'une vraie application. Ensuite, je vais vous convaincre qu'il s'agit d'une erreur fréquente et courante. Les programmeurs commettent souvent cette erreur à la fin d'une série d'opérations similaires.
J'ai entendu dire que les grimpeurs chutent souvent dans les dernières dizaines de mètres. Ce n'est pas parce qu'ils sont fatigués, mais précisément parce qu'ils sont surexcités par la fin imminente ; ils imaginent la joie du succès, deviennent négligents et finissent par glisser. Je suppose que les programmeurs sont pareils.
Maintenant, regardons un ensemble de données.
Après avoir étudié la base de données, j'ai isolé 84 fragments de code générés par la technique du copier-coller. Dans 41 d'entre eux, l'erreur s'est produite dans un bloc collé intermédiaire. Par exemple :
strncmp(argv[argidx], "CAT=", 4) &&
strncmp(argv[argidx], "DECOY=", 6) &&
strncmp(argv[argidx], "THREADS=", 6) &&
strncmp(argv[argidx], "MINPROB=", 8)) {
La longueur de la chaîne « THREADS= » est de 8 caractères, et non 6.
Dans les 43 autres fragments de code, l'erreur s'est produite dans le dernier bloc collé.
Bien sûr, 43 n'est pas beaucoup plus grand que 41. Mais notez qu'un programme peut avoir de nombreux blocs de code similaires, donc des erreurs peuvent se produire dans le premier, le deuxième, le cinquième, ou même le dixième bloc. Par conséquent, dans les autres blocs, nous avons une répartition relativement uniforme, tandis que le dernier bloc présente un pic.
En moyenne, le nombre total de blocs de code similaires est de 5.
Ainsi, 41 erreurs sont uniformément réparties parmi les 4 premiers blocs de code, avec une moyenne de 10 erreurs par bloc.
Cependant, le dernier bloc contient 43 erreurs !
Le diagramme de répartition ci-dessous met en évidence ce phénomène :
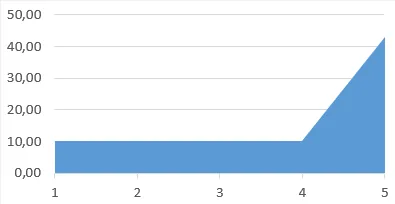
Schéma d'aperçu de la répartition des erreurs dans cinq segments de code similaires
Par conséquent, nous pouvons résumer une règle :
La probabilité de commettre une erreur dans le dernier bloc de code collé est 4 fois celle des autres blocs de code.
Cette règle n'est peut-être pas universelle. Ce n'est qu'une découverte intéressante, et sa valeur pratique est de vous rappeler de rester vigilant lorsque vous écrivez le dernier bloc.
Exemple :
Maintenant, je vais prouver que ce n'est pas seulement mon imagination débordante, mais une véritable tendance. Regardez les exemples suivants.
Bien sûr, je ne vais pas lister tous les exemples, seulement des exemples simples et représentatifs.
Source Engine SDK
inline void Init( float ix=0, float iy=0,
                  float iz=0, float iw = 0 )
{
  SetX( ix );
  SetY( iy );
  SetZ( iz );
  SetZ( iw );
}
La dernière ligne devrait être SetW().
Chromium
if (access & FILE_WRITE_ATTRIBUTES)
  output.append(ASCIIToUTF16("\tFILE_WRITE_ATTRIBUTES\n"));
if (access & FILE_WRITE_DATA)
  output.append(ASCIIToUTF16("\tFILE_WRITE_DATA\n"));
if (access & FILE_WRITE_EA)
  output.append(ASCIIToUTF16("\tFILE_WRITE_EA\n"));
if (access & FILE_WRITE_EA)
  output.append(ASCIIToUTF16("\tFILE_WRITE_EA\n"));
break;
Les deux dernières lignes sont identiques.
ReactOS
if (*ScanString == L'\"' ||
    *ScanString == L'^' ||
    *ScanString == L'\"')
Multi Theft Auto
class CWaterPolySAInterface
{
public:
    WORD m_wVertexIDs[3];
};
CWaterPoly* CWaterManagerSA::CreateQuad (....)
{
  ....
  pInterface->m_wVertexIDs [ 0 ] = pV1->GetID ();
  pInterface->m_wVertexIDs [ 1 ] = pV2->GetID ();
  pInterface->m_wVertexIDs [ 2 ] = pV3->GetID ();
  pInterface->m_wVertexIDs [ 3 ] = pV4->GetID ();
  ....
}
La dernière ligne redondante provient d'un copier-coller habituel. La taille du tableau est de 3.
Source Engine SDK
intens.x=OrSIMD(AndSIMD(BackgroundColor.x,no_hit_mask),
                AndNotSIMD(no_hit_mask,intens.x));
intens.y=OrSIMD(AndSIMD(BackgroundColor.y,no_hit_mask),
                AndNotSIMD(no_hit_mask,intens.y));
intens.z=OrSIMD(AndSIMD(BackgroundColor.y,no_hit_mask),
                AndNotSIMD(no_hit_mask,intens.z));
Le programmeur a oublié de remplacer "BackgroundColor.y" par "BackgroundColor.z" dans la dernière ligne.
Trans-Proteomic Pipeline
void setPepMaxProb(....)
{
  ....
  double max4 = 0.0;
  double max5 = 0.0;
  double max6 = 0.0;
  double max7 = 0.0;
  ....
  if ( pep3 ) { ... if ( use_joint_probs && prob > max3 ) ... }
  ....
  if ( pep4 ) { ... if ( use_joint_probs && prob > max4 ) ... }
  ....
  if ( pep5 ) { ... if ( use_joint_probs && prob > max5 ) ... }
  ....
  if ( pep6 ) { ... if ( use_joint_probs && prob > max6 ) ... }
  ....
  if ( pep7 ) { ... if ( use_joint_probs && prob > max6 ) ... }
  ....
}
Le programmeur a oublié de remplacer "prob > max6" par "prob > max7" dans la dernière condition.
SeqAn
inline typename Value<Pipe>::Type const & operator*() {
  tmp.i1 = *in.in1;
  tmp.i2 = *in.in2;
  tmp.i3 = *in.in2;
  return tmp;
}
SlimDX
for( int i = 0; i < 2; i++ )
{
  sliders[i] = joystate.rglSlider[i];
  asliders[i] = joystate.rglASlider[i];
  vsliders[i] = joystate.rglVSlider[i];
  fsliders[i] = joystate.rglVSlider[i];
}
La dernière ligne devrait utiliser rglFSlider.
Qt
if (repetition == QStringLiteral("repeat") ||
    repetition.isEmpty()) {
  pattern->patternRepeatX = true;
  pattern->patternRepeatY = true;
} else if (repetition == QStringLiteral("repeat-x")) {
  pattern->patternRepeatX = true;
} else if (repetition == QStringLiteral("repeat-y")) {
  pattern->patternRepeatY = true;
} else if (repetition == QStringLiteral("no-repeat")) {
  pattern->patternRepeatY = false;
  pattern->patternRepeatY = false;
} else {
  //TODO: exception: SYNTAX_ERR
}
Il manque 'patternRepeatX' dans le dernier bloc. Le code correct devrait être :
pattern->patternRepeatX = false;
pattern->patternRepeatY = false;
ReactOS
const int istride = sizeof(tmp[0]) / sizeof(tmp[0][0][0]);
const int jstride = sizeof(tmp[0][0]) / sizeof(tmp[0][0][0]);
const int mistride = sizeof(mag[0]) / sizeof(mag[0][0]);
const int mjstride = sizeof(mag[0][0]) / sizeof(mag[0][0]);
'mjstride' est toujours égal à 1. La dernière ligne devrait être :
const int mjstride = sizeof(mag[0][0]) / sizeof(mag[0][0][0]);
Mozilla Firefox
if (protocol.EqualsIgnoreCase("http") ||
    protocol.EqualsIgnoreCase("https") ||
    protocol.EqualsIgnoreCase("news") ||
    protocol.EqualsIgnoreCase("ftp") ||          <<<---
    protocol.EqualsIgnoreCase("file") ||
    protocol.EqualsIgnoreCase("javascript") ||
    protocol.EqualsIgnoreCase("ftp")) {          <<<---
Le "ftp" final est suspect ; il a déjà été comparé auparavant.
Quake-III-Arena
if (fabs(dir[0]) > test->radius ||
    fabs(dir[1]) > test->radius ||
    fabs(dir[1]) > test->radius)
Le programmeur a oublié de vérifier la valeur de dir
Clang
return (ContainerBegLine <= ContaineeBegLine &&
        ContainerEndLine <= ContaineeEndLine &&
        (ContainerBegLine != ContaineeBegLine ||
         SM.getExpansionColumnNumber(ContainerRBeg) <=
         SM.getExpansionColumnNumber(ContaineeRBeg)) &&
        (ContainerEndLine != ContaineeEndLine ||
         SM.getExpansionColumnNumber(ContainerREnd) >=
         SM.getExpansionColumnNumber(ContainerREnd)));
Dans le dernier bloc, l'expression "SM.getExpansionColumnNumber(ContainerREnd)" est comparée avec elle-même.
MongoDB
bool operator==(const MemberCfg& r) const {
  ....
  return _id==r._id && votes == r.votes &&
         h == r.h && priority == r.priority &&
         arbiterOnly == r.arbiterOnly &&
         slaveDelay == r.slaveDelay &&
         hidden == r.hidden &&
         buildIndexes == buildIndexes;
}
Le programmeur a oublié le 'r' dans la dernière ligne.
Unreal Engine 4
static bool PositionIsInside(....)
{
  return
    Position.X >= Control.Center.X - BoxSize.X * 0.5f &&
    Position.X <= Control.Center.X + BoxSize.X * 0.5f &&
    Position.Y >= Control.Center.Y - BoxSize.Y * 0.5f &&
    Position.Y >= Control.Center.Y - BoxSize.Y * 0.5f;
}
Dans la dernière ligne, le programmeur a oublié deux choses. Premièrement, ">=" devrait être remplacé par "<=", et deuxièmement, le signe moins devrait être remplacé par un signe plus.
Qt
qreal x = ctx->callData->args[0].toNumber();
qreal y = ctx->callData->args[1].toNumber();
qreal w = ctx->callData->args[2].toNumber();
qreal h = ctx->callData->args[3].toNumber();
if (!qIsFinite(x) || !qIsFinite(y) ||
    !qIsFinite(w) || !qIsFinite(w))
Dans le dernier qlsFinite, l'argument passé devrait être 'h'.
OpenSSL
if (!strncmp(vstart, "ASCII", 5))
  arg->format = ASN1_GEN_FORMAT_ASCII;
else if (!strncmp(vstart, "UTF8", 4))
  arg->format = ASN1_GEN_FORMAT_UTF8;
else if (!strncmp(vstart, "HEX", 3))
  arg->format = ASN1_GEN_FORMAT_HEX;
else if (!strncmp(vstart, "BITLIST", 3))
  arg->format = ASN1_GEN_FORMAT_BITLIST;
La chaîne "BITLIST" a une longueur de 7, pas 3.
Arrêtons-nous ici. Les exemples que j'ai donnés suffisent à faire passer le message, non ?
Conclusion
Cet article vous indique que la technique du copier-coller a probablement une probabilité d'erreur 4 fois plus élevée dans le dernier bloc de code collé que dans les autres blocs.
Cela relève de la psychologie humaine, et non des compétences techniques. L'article montre que même des programmeurs expérimentés dans des projets comme Clang ou Qt commettent ce genre d'erreur.
J'espère que cette découverte du phénomène sera utile aux programmeurs, et peut-être les incitera-t-elle à étudier notre base de données de bogues. Je pense que cela aidera à trouver de nouveaux schémas dans ces erreurs et à synthétiser de nouvelles recommandations de programmation.
Cet article est reproduit depuis : http://www.vaikan.com/the-last-line-effect/