Il y a eu quelques articles présentant l'évolution des architectures de grands sites web, comme ceux sur LiveJournal et eBay, qui méritent vraiment d'être consultés. Cependant, j'ai l'impression qu'ils se concentraient davantage sur les résultats de chaque évolution plutôt que d'expliquer en détail pourquoi une telle évolution était nécessaire. De plus, j'ai récemment remarqué que de nombreux étudiants ont du mal à comprendre pourquoi un site web a besoin de technologies aussi complexes, ce qui m'a donné l'idée d'écrire cet article. Cet article décrira un processus d'évolution architecturale relativement typique et l'ensemble des connaissances requises lorsqu'un site web ordinaire devient un grand site web, dans l'espoir de donner aux étudiants qui souhaitent travailler dans l'industrie Internet un concept préliminaire. Veuillez également faire davantage de suggestions sur les inexactitudes de l'article, afin que cet article puisse vraiment servir de point de départ à la discussion.
Évolution de l'architecture, étape 1 : séparer physiquement le serveur web et la base de données
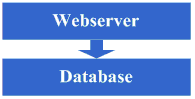
Au tout début, en raison de certaines idées, un site web a été mis en place sur Internet. À ce moment-là, même la machine hôte avait peut-être été louée. Cependant, comme cet article se concentre uniquement sur l'évolution de l'architecture, supposons qu'une machine hôte soit déjà hébergée et qu'il existe une certaine quantité de bande passante. À ce stade, parce que le site web présente certaines caractéristiques, il attire quelques visiteurs. Peu à peu, vous constatez que la pression sur le système devient de plus en plus élevée et que la vitesse de réponse devient de plus en plus lente. Ce qui est plus évident à ce moment-là, c'est que la base de données et l'application s'influencent mutuellement. Lorsque l'application a des problèmes, la base de données est aussi susceptible d'en avoir, et lorsque la base de données a des problèmes, l'application est aussi susceptible d'en avoir. On entre alors dans la première étape de l'évolution : séparer physiquement l'application et la base de données sur deux machines. À ce moment-là, il n'y a pas de nouvelle exigence technique, mais vous constatez que c'est effectivement efficace. Le système retrouve sa vitesse de réponse précédente, prend en charge un trafic plus élevé et ne subit plus l'influence mutuelle entre la base de données et l'application.
Jetez un œil au diagramme du système après avoir terminé cette étape :
Cette étape implique les systèmes de connaissances suivants :
Cette étape d'évolution de l'architecture n'impose pratiquement aucune exigence au système de connaissances techniques.
Étape 2 de l'évolution de l'architecture : ajouter un cache de pages
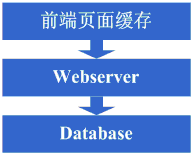
Les bons moments ne durent pas longtemps. À mesure que de plus en plus de personnes visitent le site, vous constatez que la vitesse de réponse commence à ralentir de nouveau. Après avoir enquêté sur la cause, vous découvrez qu'il y a trop d'opérations accédant à la base de données, ce qui provoque une concurrence féroce pour les connexions à la base de données, et donc la réponse ralentit. Cependant, le nombre de connexions à la base de données ne peut pas être défini trop élevé ; sinon, la machine de base de données subira une forte pression. Par conséquent, vous envisagez d'utiliser un mécanisme de mise en cache pour réduire la concurrence pour les ressources de connexion à la base de données et la pression de lecture sur la base de données. À ce stade, vous pourriez d'abord choisir d'utiliser des mécanismes comme squid pour mettre en cache les pages relativement statiques du système (par exemple, les pages qui ne sont mises à jour que tous les un ou deux jours). Bien sûr, vous pourriez aussi utiliser une solution pour statifier les pages. De cette façon, sans modifier le programme, cela peut efficacement réduire la pression sur le serveur web et réduire la concurrence pour les ressources de connexion à la base de données. OK, donc vous commencez à utiliser squid pour mettre en cache les pages relativement statiques.
Jetez un œil au diagramme du système après avoir terminé cette étape :
Cette étape implique les systèmes de connaissances suivants :
Technologies de mise en cache des pages côté front-end, telles que squid. Pour bien l'utiliser, vous devez également bien comprendre l'implémentation de squid et les algorithmes d'invalidation du cache.
Étape 3 de l'évolution de l'architecture : ajouter la mise en cache de fragments de page
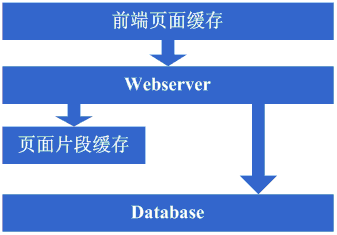
Après avoir ajouté squid pour la mise en cache, la vitesse globale du système s'est effectivement améliorée, et la pression sur le serveur web a également commencé à diminuer. Cependant, à mesure que le nombre de visites augmentait, le système a recommencé à ralentir. Ayant goûté aux avantages de la mise en cache dynamique comme squid, vous avez commencé à vous demander si les parties relativement statiques de ces pages dynamiques pouvaient également être mises en cache. Par conséquent, vous avez envisagé d'adopter une stratégie de mise en cache de fragments de page similaire à ESI. OK, donc vous avez commencé à utiliser ESI pour mettre en cache les parties de fragments relativement statiques des pages dynamiques.
Jetez un œil au diagramme du système après avoir terminé cette étape :
Cette étape implique les systèmes de connaissances suivants :
Technologies de mise en cache de fragments de page, telles que ESI. Pour bien les utiliser, vous devez également maîtriser l'implémentation d'ESI, etc.
Étape 4 de l'évolution de l'architecture : cache de données
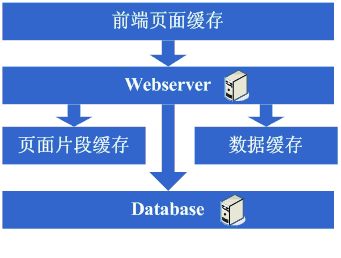
Après avoir utilisé des technologies comme ESI pour améliorer encore l'efficacité de la mise en cache du système, la pression sur le système a effectivement encore diminué. Mais à nouveau, à mesure que le nombre de visites augmentait, le système a commencé à ralentir. Après enquête, vous pourriez découvrir qu'il y a certains endroits dans le système qui récupèrent de manière répétée des informations de données, comme l'obtention d'informations utilisateur. À ce stade, vous commencez à vous demander si ces informations de données peuvent également être mises en cache. Vous mettez donc ces données en cache dans la mémoire locale. Une fois les modifications terminées, cela répond pleinement aux attentes : la vitesse de réponse du système se rétablit, et la pression sur la base de données est de nouveau considérablement réduite.
Jetez un œil au diagramme du système après avoir terminé cette étape :
Cette étape implique les systèmes de connaissances suivants :
Les technologies de mise en cache, y compris les structures de données comme Map, les algorithmes de cache, les mécanismes d'implémentation du framework choisi lui-même, etc.
Étape 5 de l'évolution de l'architecture : Ajouter un serveur web
Les bons moments ne durent pas longtemps. Vous constatez qu'à mesure que le volume de visites du système augmente à nouveau, la pression sur la machine serveur web monte à un niveau relativement élevé pendant les heures de pointe. À ce stade, vous commencez à envisager d'ajouter un serveur web. C'est aussi pour résoudre en même temps le problème de disponibilité, afin d'éviter la situation où le système devient inutilisable si un seul serveur web tombe en panne. Après avoir pris en compte ces problèmes, vous décidez d'ajouter un serveur web. Lors de l'ajout d'un serveur web, vous rencontrerez certains problèmes, typiquement :
1. Comment répartir les visites entre ces deux machines. À ce stade, les solutions couramment envisagées sont la solution d'équilibrage de charge intégrée d'Apache, ou des solutions logicielles d'équilibrage de charge comme LVS.
2. Comment maintenir synchronisées les informations d'état, telles que les sessions utilisateur. À ce stade, les solutions à envisager incluent l'écriture dans une base de données, l'écriture dans le stockage, les cookies, ou des mécanismes de synchronisation des informations de session.
3. Comment maintenir synchronisées les informations de cache de données, comme les données utilisateur précédemment mises en cache. À ce stade, les mécanismes couramment envisagés incluent la synchronisation de cache ou la mise en cache distribuée.
4. Comment maintenir le fonctionnement normal de fonctions telles que le téléversement de fichiers. À ce stade, le mécanisme couramment envisagé consiste à utiliser un système de fichiers partagé ou un stockage partagé.
Après avoir résolu ces problèmes, le serveur web est finalement passé à deux machines, et le système a finalement retrouvé sa vitesse précédente.
Jetez un œil au diagramme du système après avoir terminé cette étape :
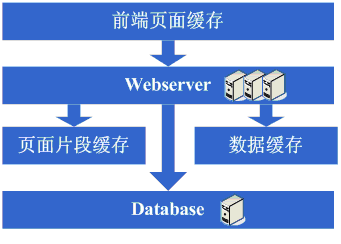
Cette étape implique les systèmes de connaissances suivants :
Technologies d'équilibrage de charge (y compris, mais sans s'y limiter, l'équilibrage de charge matériel, l'équilibrage de charge logiciel, les algorithmes d'équilibrage de charge, les protocoles de transfert Linux, les détails d'implémentation des technologies choisies, etc.), technologies actif/veille (y compris, mais sans s'y limiter, l'usurpation ARP, le heartbeat Linux, etc.), technologies de synchronisation d'informations d'état ou de cache (y compris, mais sans s'y limiter, la technologie Cookie, le protocole UDP, la diffusion d'informations d'état, les détails d'implémentation de la technologie de synchronisation de cache choisie, etc.), technologies de fichiers partagés (y compris, mais sans s'y limiter, NFS, etc.), technologies de stockage (y compris, mais sans s'y limiter, les périphériques de stockage, etc.).
Étape 6 de l'évolution de l'architecture : partitionnement de base de données
Après avoir profité d'une période de bonheur avec une croissance rapide du trafic système, vous constatez que le système ralentit à nouveau. Quelle est la situation cette fois-ci ? Après enquête, vous découvrez que pour des opérations telles que les écritures et les mises à jour de base de données, la concurrence pour certaines ressources de connexion à la base de données est très féroce, ce qui ralentit le système. Que faire maintenant ? Les options disponibles à ce stade incluent le clustering de bases de données et la stratégie de partitionnement de base de données. En matière de clustering, certaines bases de données sont mal prises en charge, de sorte que le partitionnement de base de données devient une stratégie plus courante. Le partitionnement de base de données implique également que les programmes d'origine doivent être modifiés. Après une série de modifications pour mettre en œuvre le partitionnement, le résultat est bon : l'objectif est atteint, et le système récupère, voire devient plus rapide qu'avant.
Jetez un œil au diagramme du système après avoir terminé cette étape :
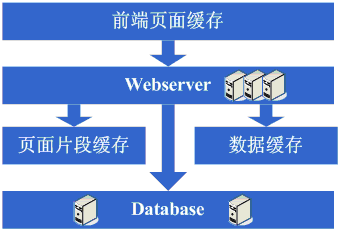
Cette étape implique les systèmes de connaissances suivants :
Cette étape nécessite principalement une division raisonnable au niveau métier pour réaliser le sharding de base de données ; il n'y a pas d'autres exigences concernant les détails techniques spécifiques.
Mais en même temps, à mesure que le volume de données augmente et que le sharding de base de données progresse, la conception, l'optimisation et la maintenance de la base de données doivent être mieux réalisées. Par conséquent, de hautes exigences sont toujours imposées aux technologies dans ces domaines.
Étape 7 de l'évolution de l'architecture : sharding de table, DAL et cache distribué
À mesure que le système continue de fonctionner, le volume de données commence à croître considérablement. À ce stade, vous constatez que les requêtes sont encore quelque peu lentes après le sharding de base de données, vous commencez donc à travailler sur le sharding de table en suivant la même idée que le sharding de base de données. Bien sûr, cela nécessite inévitablement quelques modifications des programmes. Peut-être réalisez-vous à ce moment-là que le fait que l'application elle-même se charge des règles de sharding de base de données et de table est quelque peu compliqué. Cela donne l'idée d'ajouter un framework générique pour mettre en œuvre l'accès aux données pour le sharding de base de données et de table ; dans l'architecture d'eBay, cela correspond à DAL. Ce processus d'évolution prend relativement longtemps. Bien sûr, il est également possible que ce framework générique ne soit commencé qu'après l'achèvement du sharding de table. Pendant ce temps, à ce stade, vous pourriez constater que la précédente solution de synchronisation de cache pose problème, car le volume de données est trop important, ce qui fait qu'il n'est plus possible de stocker les caches localement puis de les synchroniser. Vous devez adopter une solution de cache distribué. Ainsi, après un autre cycle d'investigation et de lutte, vous finissez par déplacer une grande quantité de cache de données vers le cache distribué.
Jetez un œil au diagramme du système après avoir terminé cette étape :
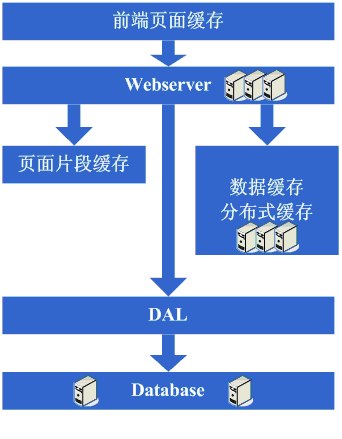
Cette étape implique les systèmes de connaissances suivants :
Le sharding de table relève également davantage d'une division au niveau métier ; techniquement, il implique des algorithmes de hachage dynamique, des algorithmes de hachage cohérent, etc.
DAL implique de nombreuses technologies complexes, telles que la gestion des connexions à la base de données (délais d’attente, exceptions), le contrôle des opérations sur la base de données (délais d’attente, exceptions), l’encapsulation des règles de sharding des bases de données et des tables, etc.
Étape 8 de l’évolution de l’architecture : ajouter davantage de serveurs web
Après avoir terminé le travail de sharding des bases de données et des tables, la pression sur la base de données est retombée à un niveau relativement faible, et vous recommencez à vivre une vie heureuse, en regardant le nombre de visites augmenter chaque jour. Puis, un jour, vous découvrez soudain que l’accès au système commence à ralentir de nouveau. À ce moment-là, vous vérifiez d’abord la base de données, et la pression est tout à fait normale. Ensuite, vous vérifiez le serveur web et constatez qu’Apache bloque de nombreuses requêtes, tandis que le serveur d’applications reste relativement rapide pour chaque requête. Il semble que le nombre de requêtes soit trop élevé, ce qui provoque une mise en file d’attente et des temps de réponse plus lents. C’est plus facile à gérer. De manière générale, à ce stade, vous avez aussi un peu d’argent, alors vous ajoutez quelques serveurs web. Lors de l’ajout de serveurs web, plusieurs défis peuvent survenir :
1. Lorsque l’équilibrage de charge logiciel Apache ou l’équilibrage de charge logiciel LVS ne peut plus gérer la planification d’énormes volumes d’accès web (connexions de requêtes, connexions réseau, etc.), à ce stade, si le budget le permet, l’approche adoptée consiste à acheter des équilibreurs de charge matériels, tels que F5, Netsclar, Athelon, etc. Si le budget ne le permet pas, l’approche adoptée consiste à classer logiquement les applications dans une certaine mesure, puis à les répartir entre différents clusters d’équilibrage de charge logiciel.
2. Certaines solutions existantes, comme la synchronisation des informations d’état et le partage de fichiers, peuvent devenir des goulots d’étranglement et doivent être améliorées. Peut-être qu’à ce stade, des systèmes de fichiers distribués répondant aux besoins métier du site web seront développés selon les besoins.
Après avoir terminé ces tâches, nous entrons dans une ère de scalabilité infinie apparemment parfaite. Lorsque le trafic du site web augmente, la solution consiste à ajouter continuellement des serveurs web.
Jetez un œil au diagramme système une fois cette étape terminée :
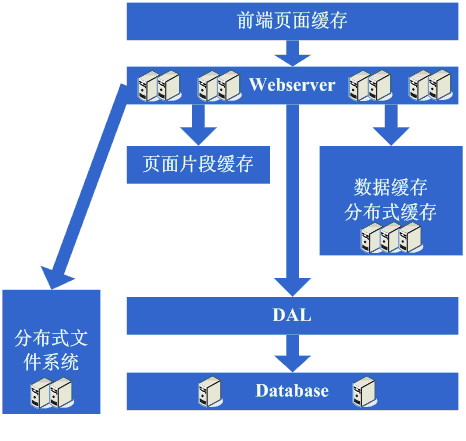
Cette étape implique les systèmes de connaissances suivants :
À cette étape, avec la croissance continue du nombre de machines, la croissance continue du volume de données et des exigences de plus en plus élevées en matière de disponibilité du système, une compréhension plus approfondie des technologies adoptées est nécessaire, et davantage de produits personnalisés doivent être développés en fonction des besoins du site web.
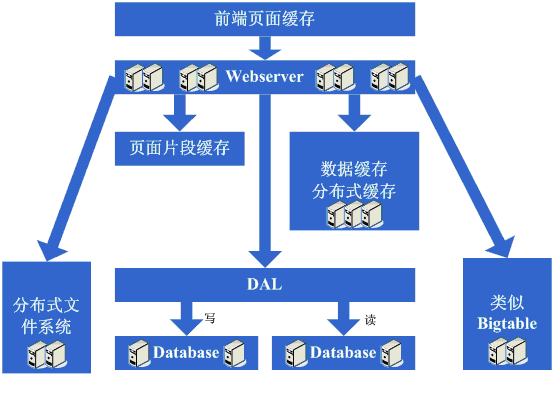
Étape 9 de l'évolution de l'architecture : séparation lecture-écriture des données et solutions de stockage à faible coût
Soudain, un jour, nous constatons que cette ère parfaite touche elle aussi à sa fin. Le cauchemar de la base de données réapparaît sous nos yeux. Parce que trop de serveurs web ont été ajoutés, les ressources de connexion à la base de données sont encore insuffisantes, et à ce stade la base de données a déjà été partitionnée en plusieurs bases de données et tables. En analysant la situation de pression sur la base de données, on peut découvrir que le ratio lecture-écriture de la base de données est très élevé. À ce moment-là, la solution de séparation lecture-écriture des données vient généralement à l'esprit. Bien sûr, cette solution n'est pas facile à mettre en œuvre. En outre, on peut découvrir que stocker certaines données dans la base de données est quelque peu gaspilleur, ou occupe trop de ressources de base de données. Par conséquent, l'évolution de l'architecture qui pourrait prendre forme à ce stade consiste à mettre en œuvre la séparation lecture-écriture des données, tout en développant également des solutions de stockage à moindre coût, telles que BigTable.
Jetez un œil au diagramme système une fois cette étape terminée :
Cette étape implique les systèmes de connaissances suivants :
La séparation lecture-écriture des données exige une maîtrise et une compréhension approfondies de la réplication de base de données, des mécanismes de secours et d'autres stratégies, ainsi que la capacité de les mettre en œuvre de manière indépendante.
Les solutions de stockage à faible coût exigent une maîtrise et une compréhension approfondies du stockage de fichiers de l'OS, ainsi qu'une maîtrise approfondie de la manière dont le langage adopté implémente la gestion des fichiers.
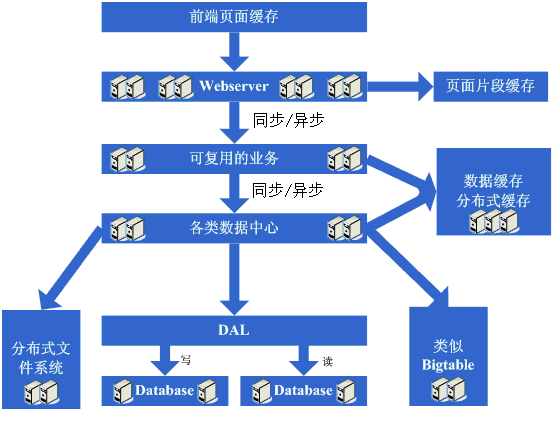
Évolution de l'architecture, étape 10 : entrée dans l'ère des applications distribuées à grande échelle et dans l'ère rêvée des clusters de serveurs à faible coût
Après ce processus long et douloureux, l'ère parfaite arrive enfin de nouveau. Ajouter continuellement des serveurs web peut supporter un trafic de plus en plus élevé. Pour les grands sites web, l'importance de la popularité ne fait aucun doute. À mesure que la popularité augmente, diverses exigences fonctionnelles commencent également à croître de façon explosive. À ce stade, on découvre soudain que l'application web initialement déployée sur les serveurs web est devenue très énorme. Lorsque plusieurs équipes commencent à la modifier, c'est assez peu pratique, et la réutilisabilité est assez mauvaise. Fondamentalement, chaque équipe fait plus ou moins un travail répétitif, et le déploiement et la maintenance sont également assez pénibles, car copier et démarrer l'énorme package applicatif sur N machines consomme un temps considérable, et les problèmes ne sont pas faciles à diagnostiquer lorsqu'ils surviennent. Une situation encore pire est qu'un bug dans une application peut rendre tout le site indisponible. Il y a aussi d'autres facteurs tels que la difficulté de l'optimisation (parce que les applications déployées sur les machines doivent tout faire, ce qui rend une optimisation ciblée tout simplement impossible). Sur la base de cette analyse, une décision ferme est prise de découper le système par responsabilité, et ainsi naît une application distribuée à grande échelle. Habituellement, cette étape prend un temps considérable parce qu'elle rencontre de nombreux défis :
1. Après la découpe en une architecture distribuée, il est nécessaire de fournir un framework de communication performant et stable, et il doit prendre en charge plusieurs méthodes différentes de communication et d'invocation à distance.
2. La découpe d'une énorme application prend beaucoup de temps, ce qui nécessite une organisation métier et une maîtrise des dépendances du système, etc.
3. Comment exploiter et maintenir correctement (gestion des dépendances, gestion de l'état de santé, suivi des erreurs, optimisation, surveillance et alertes, etc.) cette énorme application distribuée.
Après cette étape, l'architecture du système entre dans une phase relativement stable. En même temps, il devient possible d'utiliser un grand nombre de machines à faible coût pour prendre en charge le trafic et le volume de données considérables. En combinant cette architecture avec l'expérience acquise au cours de ces nombreux processus d'évolution, diverses autres méthodes sont adoptées pour prendre en charge un trafic de plus en plus élevé.
Jetez un œil au diagramme système une fois cette étape terminée :
Cette étape implique les systèmes de connaissances suivants :
Cette étape implique un grand nombre de systèmes de connaissances. Elle exige une compréhension approfondie et une maîtrise de la communication, de l'invocation distante, des mécanismes de messagerie, etc. Elle exige une compréhension claire de la théorie, du niveau matériel, du niveau du système d'exploitation, ainsi que de la mise en œuvre du langage adopté.
L'exploitation et la maintenance impliquent également un grand nombre de systèmes de connaissances. Dans la plupart des cas, il est nécessaire de maîtriser le calcul parallèle distribué, le reporting, les technologies de supervision, les stratégies de règles, etc.
Ce n'est certes pas très laborieux d'en parler. Le processus d'évolution classique de toute l'architecture d'un site web est assez semblable à ce qui est décrit ci-dessus. Bien sûr, les solutions adoptées à chaque étape et les étapes d'évolution peuvent différer. De plus, en raison des différentes activités des sites web, il y aura des besoins technologiques professionnels différents. Ce blog explique le processus d'évolution davantage d'un point de vue architectural. Bien sûr, beaucoup de technologies ne sont pas mentionnées ici, telles que le clustering de bases de données, la fouille de données, la recherche, etc. Mais dans le processus d'évolution réel, des éléments comme la mise à niveau des configurations matérielles, des environnements réseau, la transformation des systèmes d'exploitation, la mise en miroir CDN, etc., sont également utilisés pour prendre en charge un trafic plus important. Par conséquent, il y aura de nombreuses différences dans le processus de développement réel. De plus, un grand site web doit réaliser bien plus que ce qui est listé ci-dessus, notamment la sécurité, l'exploitation, les opérations commerciales, les services, le stockage, etc. Il n'est vraiment pas facile de bien construire un grand site web. Cet article est plutôt écrit dans l'espoir de susciter davantage de présentations de l'évolution de l'architecture des grands sites web.
URL de l'article original : http://www.blogjava.net/BlueDavy/archive/2008/09/03/226749.html