Были статьи, рассказывающие об эволюции архитектур крупных веб-сайтов, например о LiveJournal и eBay, которые заслуживают того, чтобы на них ссылаться. Однако, как мне кажется, они больше сосредоточены на результатах каждой эволюции, а не на подробном объяснении того, почему такая эволюция была необходима. Кроме того, недавно я заметил, что многим студентам трудно понять, почему веб-сайту нужны такие сложные технологии, и это привело к идее написать эту статью. В этой статье будет описан относительно типичный процесс эволюции архитектуры и совокупность знаний, необходимых по мере превращения обычного веб-сайта в крупный веб-сайт, в надежде дать студентам, которые хотят работать в интернет-индустрии, предварительное представление. Также, пожалуйста, предлагайте больше замечаний о неточностях в статье, чтобы эта статья действительно могла служить отправной точкой для обсуждения.
Этап 1 эволюции архитектуры: физически разделить веб-сервер и базу данных
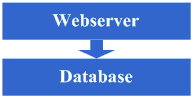
В самом начале, исходя из некоторых идей, в Интернете был создан веб-сайт. В то время даже хост-машина, возможно, была арендована. Однако, поскольку эта статья посвящена только эволюции архитектуры, предположим, что хост-машина уже размещена и есть определённая пропускная способность. На этом этапе, поскольку сайт обладает определёнными особенностями, он привлекает некоторых посетителей. Постепенно вы замечаете, что нагрузка на систему становится всё выше, а скорость отклика — всё медленнее. В это время более очевидно, что база данных и приложение влияют друг на друга. Когда возникают проблемы с приложением, база данных также склонна к проблемам, а когда проблемы с базой данных, приложение тоже склонно к проблемам. Так начинается первый этап эволюции: физически разделить приложение и базу данных на две машины. На этот раз новых технических требований нет, но вы обнаруживаете, что это действительно эффективно. Система возвращается к прежней скорости отклика, поддерживает более высокий трафик и больше не страдает от взаимного влияния базы данных и приложения.
Взгляните на схему системы после выполнения этого шага:
Этот шаг включает следующие системы знаний:
Этот шаг эволюции архитектуры практически не предъявляет требований к системе технических знаний.
Этап 2 эволюции архитектуры: добавление кэша страниц
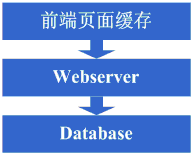
Хорошие времена быстро заканчиваются. Поскольку всё больше и больше людей посещают систему, вы обнаруживаете, что скорость отклика снова начинает падать. Выяснив причину, вы понимаете, что слишком много операций обращается к базе данных, вызывая острую конкуренцию за подключения к базе данных, поэтому отклик замедляется. Однако количество подключений к базе данных нельзя задавать слишком большим; иначе машина с базой данных будет испытывать высокую нагрузку. Поэтому вы рассматриваете использование механизма кэширования, чтобы снизить конкуренцию за ресурсы подключений к базе данных и нагрузку на чтение базы данных. На этом этапе вы можете сначала выбрать использование таких механизмов, как squid, для кэширования относительно статических страниц в системе (например, страниц, которые обновляются только раз в день или два). Конечно, вы также можете использовать решение для статизации страниц. Таким образом, без изменения программы это может эффективно снизить давление на webserver и уменьшить конкуренцию за ресурсы подключений к базе данных. OK, итак, вы начинаете использовать squid для кэширования относительно статических страниц.
Взгляните на схему системы после выполнения этого шага:
Этот шаг включает следующие системы знаний:
Технологии кэширования страниц на фронтенде, такие как squid. Чтобы хорошо их использовать, вам также нужно глубоко понимать реализацию squid и алгоритмы инвалидации кэша.
Этап 3 эволюции архитектуры: добавление кэширования фрагментов страниц
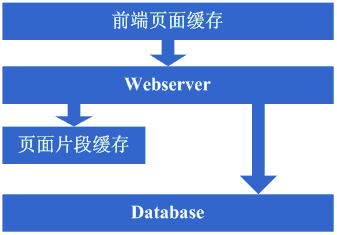
После добавления squid для кэширования общая скорость системы действительно улучшилась, и давление на webserver также начало снижаться. Однако по мере роста числа посещений система снова начала замедляться. Вкусив преимущества динамического кэширования, такого как squid, вы начали задумываться, нельзя ли также кэшировать относительно статические части тех динамических страниц. Поэтому вы рассмотрели возможность применения стратегии кэширования фрагментов страниц, аналогичной ESI. OK, итак, вы начали использовать ESI для кэширования относительно статических фрагментов динамических страниц.
Взгляните на схему системы после выполнения этого шага:
Этот шаг включает следующие системы знаний:
Технологии кэширования фрагментов страниц, такие как ESI. Чтобы хорошо их использовать, вам также нужно освоить реализацию ESI и т. д.
Этап 4 эволюции архитектуры: кэш данных
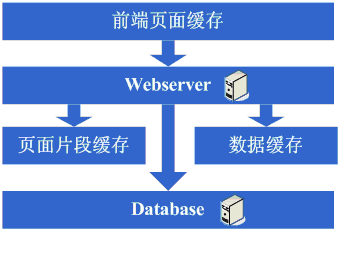
После использования таких технологий, как ESI, чтобы дополнительно повысить эффективность кэширования системы, нагрузка на систему действительно снизилась ещё больше. Но снова, по мере роста числа посещений, система начала замедляться. При исследовании вы можете обнаружить, что в системе есть места, где данные запрашиваются повторно, например получение информации о пользователе. В этот момент вы начинаете задумываться, можно ли также кэшировать эти данные. Поэтому вы кэшируете эти данные в локальной памяти. После завершения изменений всё полностью соответствует ожиданиям: скорость отклика системы восстанавливается, а нагрузка на базу данных снова значительно снижается.
Взгляните на схему системы после выполнения этого шага:
Этот шаг включает следующие системы знаний:
Технологии кэширования, включая структуры данных вроде Map, алгоритмы кэширования, механизмы реализации выбранного фреймворка и т. д.
Этап 5 эволюции архитектуры: добавить веб-сервер
Хорошие времена недолговечны. Вы обнаруживаете, что по мере очередного роста объёма посещений нагрузка на машину с веб-сервером в часы пик поднимается до довольно высокого уровня. В этот момент вы начинаете рассматривать добавление веб-сервера. Это также позволяет одновременно решить проблему доступности, чтобы избежать ситуации, когда система становится недоступной при выходе из строя одного веб-сервера. Рассмотрев эти вопросы, вы решаете добавить веб-сервер. При добавлении веб-сервера вы столкнётесь с некоторыми проблемами, обычно:
1. Как распределять посещения между этими двумя машинами. В этом случае обычно рассматриваемые решения — встроенное решение балансировки нагрузки Apache или программные решения балансировки нагрузки вроде LVS.
2. Как синхронизировать информацию о состоянии, например пользовательские сессии. В этом случае к рассматриваемым решениям относятся запись в базу данных, запись в хранилище, cookies или механизмы синхронизации информации о сессиях.
3. Как синхронизировать информацию кэша данных, например ранее кэшированные пользовательские данные. В этом случае обычно рассматриваемые механизмы включают синхронизацию кэша или распределённое кэширование.
4. Как обеспечить нормальную работу таких функций, как загрузка файлов. В этом случае обычно рассматриваемым механизмом является использование общей файловой системы или хранилища.
После решения этих проблем веб-сервер в конечном итоге был увеличен до двух машин, и система наконец вернулась к своей прежней скорости.
Взгляните на схему системы после выполнения этого шага:
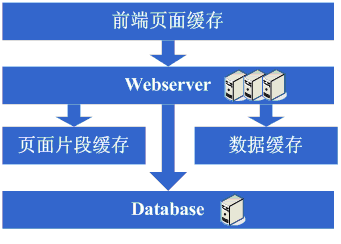
Этот шаг включает следующие системы знаний:
Технологии балансировки нагрузки (включая, но не ограничиваясь аппаратной балансировкой нагрузки, программной балансировкой нагрузки, алгоритмами балансировки нагрузки, протоколами пересылки Linux, деталями реализации выбранных технологий и т. д.), технологии активного резервирования (включая, но не ограничиваясь ARP-спуфингом, Linux heartbeat и т. д.), технологии синхронизации информации о состоянии или кэша (включая, но не ограничиваясь технологией Cookie, протоколом UDP, широковещательной передачей информации о состоянии, деталями реализации выбранной технологии синхронизации кэша и т. д.), технологии совместного использования файлов (включая, но не ограничиваясь NFS и т. д.), технологии хранения (включая, но не ограничиваясь устройствами хранения и т. д.).
Этап 6 эволюции архитектуры: шардирование базы данных
После периода счастья, вызванного быстрым ростом трафика системы, вы обнаруживаете, что система снова замедляется. Что происходит на этот раз? В ходе расследования вы обнаруживаете, что для таких операций, как запись и обновление базы данных, конкуренция за некоторые ресурсы подключения к базе данных очень высока, из-за чего система замедляется. Что делать теперь? Доступные на данный момент варианты включают кластеризацию базы данных и стратегию шардирования базы данных. Что касается кластеризации, некоторые базы данных поддерживают её недостаточно хорошо, поэтому шардирование базы данных становится более распространённой стратегией. Шардирование базы данных также означает, что исходные программы нужно модифицировать. После цикла модификаций для реализации шардирования результат оказывается хорошим: цель достигнута, и система восстанавливается или даже становится быстрее, чем раньше.
Взгляните на схему системы после выполнения этого шага:
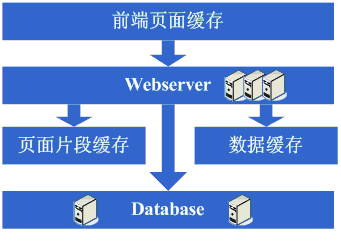
Этот шаг включает следующие системы знаний:
На этом шаге в основном требуется разумное разделение на уровне бизнеса для выполнения шардирования базы данных; других требований к конкретным техническим деталям нет.
Но в то же время, по мере роста объёма данных и продвижения шардирования базы данных, проектирование, настройка и сопровождение базы данных должны выполняться лучше. Поэтому к технологиям в этих областях по-прежнему предъявляются высокие требования.
Эволюция архитектуры, шаг 7: шардирование таблиц, DAL и распределённый кэш
По мере продолжения работы системы объём данных начинает существенно расти. В этот момент вы обнаруживаете, что после шардирования базы данных запросы по-прежнему работают недостаточно быстро, поэтому вы начинаете заниматься шардированием таблиц, следуя той же идее, что и при шардировании базы данных. Конечно, это неизбежно требует некоторых изменений в программах. Возможно, в этот момент вы осознаёте, что заставлять само приложение заботиться о правилах шардирования базы данных и таблиц несколько сложно. Отсюда возникает идея добавить универсальный фреймворк для реализации доступа к данным при шардировании базы данных и таблиц; в архитектуре eBay этому соответствует DAL. Этот процесс эволюции занимает довольно много времени. Конечно, также возможно, что разработка этого универсального фреймворка начнётся только после завершения шардирования таблиц. Тем временем на этом этапе вы можете обнаружить, что предыдущее решение синхронизации кэша имеет проблемы, поскольку объём данных слишком велик, из-за чего больше невозможно хранить кэши локально и затем синхронизировать их. Вам нужно перейти на решение с распределённым кэшем. Итак, после ещё одного раунда исследований и борьбы вы наконец переносите большой объём кэша данных в распределённый кэш.
Взгляните на схему системы после выполнения этого шага:
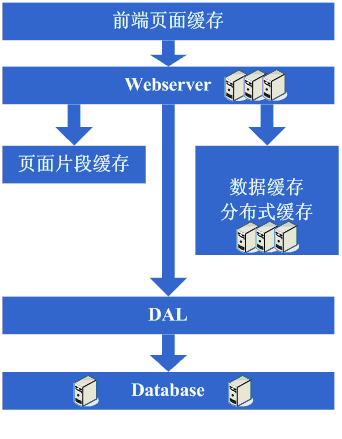
Этот шаг включает следующие системы знаний:
Шардирование таблиц также в большей степени касается разделения на уровне бизнеса; технически оно включает алгоритмы динамического хэширования, алгоритмы согласованного хэширования и т. д.
DAL включает множество сложных технологий, таких как управление подключениями к базе данных (тайм-ауты, исключения), управление операциями с базой данных (тайм-ауты, исключения), инкапсуляция правил шардинга базы данных и таблиц и т. д.
Этап 8 эволюции архитектуры: добавление дополнительных веб-серверов
После завершения работ по шардингу базы данных и таблиц нагрузка на базу данных упала до относительно низкого уровня, и вы снова начинаете жить счастливой жизнью, наблюдая, как количество посещений ежедневно растёт. Но однажды вы внезапно обнаруживаете, что доступ к системе снова начинает замедляться. В этот момент вы сначала проверяете базу данных, и нагрузка полностью в норме. Затем вы проверяете веб-сервер и обнаруживаете, что Apache блокирует множество запросов, тогда как сервер приложений по-прежнему довольно быстро обрабатывает каждый запрос. Похоже, количество запросов слишком велико, что вызывает очередь и более медленное время отклика. С этим справиться проще. Вообще говоря, на этом этапе у вас также есть немного денег, поэтому вы добавляете несколько веб-серверов. В процессе добавления веб-серверов может возникнуть несколько проблем:
1. Когда программная балансировка нагрузки Apache или программная балансировка нагрузки LVS больше не справляются с планированием огромных объёмов веб-доступа (соединений запросов, сетевого трафика и т. д.), в этот момент, если бюджет позволяет, применяется подход с покупкой аппаратных балансировщиков нагрузки, таких как F5, Netsclar, Athelon и т. д. Если бюджет не позволяет, применяется подход с определённой логической классификацией приложений и последующим распределением их по разным кластерам программной балансировки нагрузки.
2. Некоторые существующие решения, такие как синхронизация информации о состоянии и совместное использование файлов, могут стать узкими местами и нуждаться в улучшении. Возможно, на этом этапе будут по мере необходимости разработаны распределённые файловые системы, отвечающие бизнес-потребностям веб-сайта.
После выполнения этих задач мы вступаем в эпоху кажущейся идеальной бесконечной масштабируемости. Когда трафик сайта растёт, решение — постоянно добавлять веб-серверы.
Взгляните на схему системы после завершения этого этапа:
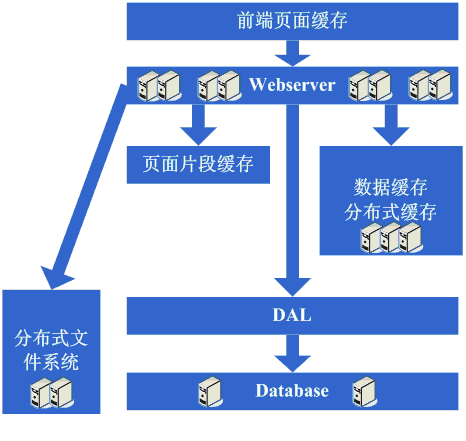
Этот шаг включает следующие системы знаний:
На этом этапе, с постоянным ростом числа машин, постоянным ростом объёма данных и всё более высокими требованиями к доступности системы, требуется более глубокое понимание применяемых технологий, и нужно разрабатывать больше кастомизированных продуктов исходя из потребностей сайта.
Эволюция архитектуры, шаг 9: разделение чтения и записи данных и решения для недорогого хранения
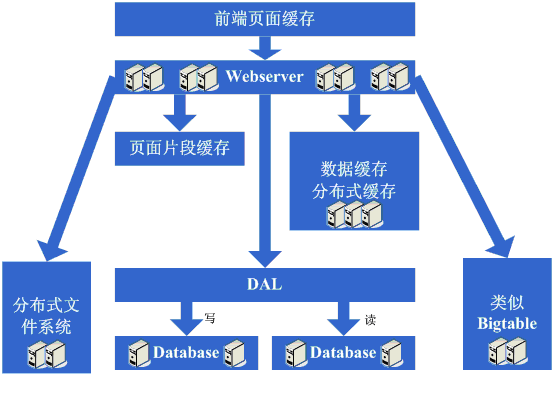
Внезапно в один прекрасный день мы обнаруживаем, что эта идеальная эпоха тоже подходит к концу. Кошмар базы данных снова предстаёт перед нашими глазами. Поскольку было добавлено слишком много веб-серверов, ресурсов для подключения к базе данных по-прежнему не хватает, а к этому моменту база данных уже была разделена на несколько баз данных и таблиц. При анализе ситуации с нагрузкой на базу данных может выясниться, что соотношение чтения и записи в базе данных очень высокое. В этот момент обычно приходит на ум решение о разделении чтения и записи данных. Конечно, это решение нелегко реализовать. Кроме того, может выясниться, что хранить некоторые данные в базе данных несколько расточительно или что они занимают слишком много ресурсов базы данных. Поэтому эволюция архитектуры, которая может сформироваться на этом этапе, заключается в реализации разделения чтения и записи данных, а также в разработке некоторых более дешёвых решений для хранения, таких как BigTable.
Взгляните на схему системы после завершения этого этапа:
Этот шаг включает следующие системы знаний:
Разделение чтения и записи данных требует глубокого владения и понимания стратегий репликации, резервирования и других стратегий базы данных, а также способности самостоятельно их реализовывать.
Недорогие решения для хранения требуют глубокого владения и понимания файлового хранения в ОС, а также глубокого владения тем, как выбранный язык реализует работу с файлами.
Этап 10 эволюции архитектуры: вступление в эру крупномасштабных распределённых приложений и эру мечты о недорогих серверных кластерах
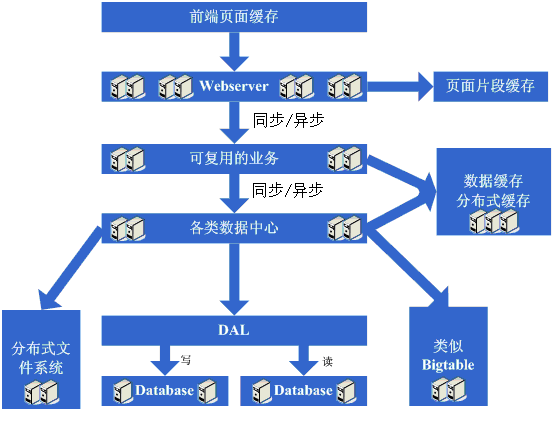
После этого долгого и болезненного процесса идеальная эра наконец наступает снова. Непрерывно добавляя веб-серверы, можно поддерживать всё более высокий трафик. Для крупных веб-сайтов важность популярности не вызывает сомнений. По мере роста популярности различные функциональные требования также начинают взрывно расти. В этот момент вдруг обнаруживается, что веб-приложение, изначально развёрнутое на веб-серверах, стало очень огромным. Когда несколько команд начинают его изменять, это довольно неудобно, а повторное использование довольно плохое. По сути, каждая команда выполняет более или менее повторяющуюся работу, а развёртывание и сопровождение также довольно хлопотны, потому что копирование и запуск огромного пакета приложения на N машинах требует значительного времени, а при возникновении проблем их нелегко диагностировать. Ещё одна худшая ситуация — ошибка в одном приложении может привести к недоступности всего сайта. Есть и другие факторы, такие как сложность настройки (потому что приложения, развёрнутые на машинах, должны делать всё, что делает целевую настройку просто невозможной). Основываясь на этом анализе, принимается твёрдое решение разделить систему по зонам ответственности, и таким образом рождается крупномасштабное распределённое приложение. Обычно этот шаг занимает значительное время, поскольку встречается много проблем:
1. После разделения на распределённую архитектуру необходимо предоставить высокопроизводительный, стабильный коммуникационный фреймворк, и он должен поддерживать несколько различных способов связи и удалённого вызова.
2. Разделение огромного приложения занимает много времени, требует организации бизнеса и управления зависимостями системы и т. д.
3. Как правильно эксплуатировать и сопровождать (управление зависимостями, управление состоянием работоспособности, отслеживание ошибок, настройка, мониторинг и оповещения и т. д.) это огромное распределённое приложение.
После этого этапа системная архитектура вступает в относительно стабильную стадию. В то же время становится возможным использовать большое количество недорогих машин для поддержки огромного трафика и объёма данных. Сочетая эту архитектуру с опытом, полученным в ходе множества процессов эволюции, применяются различные другие методы для поддержки всё более высокого трафика.
Взгляните на схему системы после завершения этого этапа:
Этот шаг включает следующие системы знаний:
Этот этап затрагивает множество областей знаний. Он требует глубокого понимания и владения коммуникацией, удалённым вызовом, механизмами обмена сообщениями и т. д. Он требует ясного понимания на теоретическом уровне, на уровне аппаратного обеспечения, на уровне операционной системы, а также реализации используемого языка.
Эксплуатация и обслуживание также затрагивают множество областей знаний. В большинстве случаев необходимо владеть распределёнными параллельными вычислениями, отчётностью, технологиями мониторинга, стратегиями на основе правил и т. д.
Говорить об этом действительно не очень трудоёмко. Классический процесс эволюции всей архитектуры веб-сайта довольно похож на описанный выше. Конечно, решения, применяемые на каждом шаге, и этапы эволюции могут различаться. Кроме того, из-за различий в бизнесе сайтов возникают разные профессиональные технологические потребности. Этот блог объясняет процесс эволюции скорее с архитектурной точки зрения. Конечно, здесь не упомянуто много технологий, таких как кластеризация баз данных, интеллектуальный анализ данных, поиск и т. д. Но в реальном процессе эволюции также используются такие вещи, как обновление аппаратной конфигурации, сетевой среды, преобразование операционной системы, зеркалирование CDN и т. д., чтобы поддерживать больший трафик. Поэтому в реальном процессе разработки будет много различий. Более того, крупному веб-сайту нужно достичь гораздо большего, чем перечислено выше, включая безопасность, эксплуатацию, бизнес-операции, сервисы, хранение и т. д. Построить хороший крупный веб-сайт действительно непросто. Эта статья написана скорее в надежде вызвать больше рассказов об эволюции архитектуры крупных веб-сайтов.
URL оригинального поста: http://www.blogjava.net/BlueDavy/archive/2008/09/03/226749.html