Es gab einige Artikel, die die Evolution großer Website-Architekturen vorstellen, etwa über LiveJournal und eBay, die durchaus lesenswert sind. Allerdings hatte ich das Gefühl, dass sie sich eher auf die Ergebnisse der jeweiligen Evolution konzentrieren, anstatt detailliert zu erklären, warum eine solche Evolution nötig war. Darüber hinaus ist mir kürzlich aufgefallen, dass viele Studierende nur schwer verstehen, warum eine Website solch komplexe Technologie benötigt, was zu der Idee führte, diesen Artikel zu schreiben. Dieser Artikel beschreibt einen relativ typischen Architekturevolutionsprozess und den Wissensbestand, der erforderlich ist, wenn eine gewöhnliche Website zu einer großen Website heranwächst, in der Hoffnung, Studierenden, die in der Internetbranche arbeiten möchten, ein erstes Konzept zu vermitteln. Bitte machen Sie auch weitere Anmerkungen zu Ungenauigkeiten im Artikel, damit dieser Artikel wirklich als Ausgangspunkt für eine Diskussion dienen kann.
Architektur-Evolution Schritt 1: Webserver und Datenbank physisch trennen
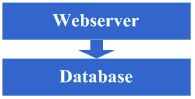
Ganz am Anfang wurde aufgrund einiger Ideen eine Website im Internet eingerichtet. Zu diesem Zeitpunkt war vielleicht sogar der Host-Rechner gemietet. Da sich dieser Artikel jedoch nur auf die Evolution der Architektur konzentriert, gehen wir davon aus, dass bereits ein Host-Rechner gehostet wird und eine gewisse Bandbreite vorhanden ist. An diesem Punkt zieht die Website aufgrund bestimmter Merkmale einige Besucher an. Allmählich stellen Sie fest, dass der Systemdruck immer höher und die Antwortgeschwindigkeit immer langsamer wird. Was zu diesem Zeitpunkt deutlicher wird, ist, dass sich Datenbank und Anwendung gegenseitig beeinflussen. Wenn die Anwendung Probleme hat, neigt auch die Datenbank zu Problemen, und wenn die Datenbank Probleme hat, neigt auch die Anwendung zu Problemen. So tritt sie in die erste Stufe der Evolution ein: Anwendung und Datenbank physisch auf zwei Maschinen trennen. Zu diesem Zeitpunkt gibt es keine neuen technischen Anforderungen, aber Sie stellen fest, dass es tatsächlich effektiv ist. Das System kehrt zu seiner früheren Antwortgeschwindigkeit zurück, unterstützt höheren Datenverkehr und leidet nicht mehr unter der gegenseitigen Beeinflussung zwischen Datenbank und Anwendung.
Werfen Sie einen Blick auf das Systemdiagramm nach Abschluss dieses Schritts:
Dieser Schritt umfasst die folgenden Wissenssysteme:
Dieser Architektur-Evolutionsschritt stellt im Grunde keine Anforderungen an das technische Wissenssystem.
Architektur-Evolution Schritt 2: Page-Cache hinzufügen
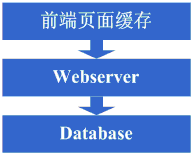
Gute Zeiten währen nicht lange. Als immer mehr Leute zugreifen, stellst du fest, dass die Antwortgeschwindigkeit wieder nachlässt. Nach der Ursachenanalyse findest du heraus, dass zu viele Operationen auf die Datenbank zugreifen, was zu starkem Wettbewerb um Datenbankverbindungen führt, sodass die Antwort langsamer wird. Allerdings darf die Anzahl der Datenbankverbindungen nicht zu hoch eingestellt werden; andernfalls steht die Datenbankmaschine unter hohem Druck. Deshalb erwägst du, einen Caching-Mechanismus zu verwenden, um den Wettbewerb um Datenbankverbindungsressourcen und den Lesedruck auf die Datenbank zu verringern. Zu diesem Zeitpunkt könntest du zunächst Mechanismen wie squid wählen, um relativ statische Seiten im System zu cachen (zum Beispiel Seiten, die nur alle ein oder zwei Tage aktualisiert werden). Natürlich könntest du auch eine Lösung verwenden, um die Seiten statisch zu machen. Auf diese Weise kann ohne Änderung des Programms der Druck auf den Webserver wirksam verringert und der Wettbewerb um Datenbankverbindungsressourcen reduziert werden. OK, also beginnst du, squid zum Cachen relativ statischer Seiten zu verwenden.
Werfen Sie einen Blick auf das Systemdiagramm nach Abschluss dieses Schritts:
Dieser Schritt umfasst die folgenden Wissenssysteme:
Front-End-Seitencaching-Technologien wie squid. Um sie gut zu nutzen, musst du auch die Implementierung von squid und seine Cache-Invalidierungsalgorithmen genau verstehen.
Architektur-Evolution Schritt 3: Seitenfragment-Caching hinzufügen
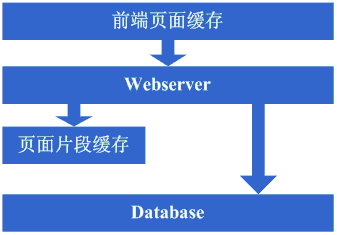
Nachdem du squid zum Cachen hinzugefügt hast, verbesserte sich die Gesamtgeschwindigkeit des Systems tatsächlich, und der Druck auf den Webserver begann ebenfalls zu sinken. Als jedoch die Zugriffszahlen stiegen, wurde das System wieder langsamer. Da du die Vorteile von dynamischem Caching wie squid kennengelernt hast, begannst du dich zu fragen, ob auch die relativ statischen Teile dieser dynamischen Seiten gecacht werden könnten. Deshalb erwogst du, eine Seitenfragment-Caching-Strategie ähnlich wie ESI einzusetzen. OK, also begannst du, ESI zu verwenden, um die relativ statischen Fragmentteile dynamischer Seiten zu cachen.
Werfen Sie einen Blick auf das Systemdiagramm nach Abschluss dieses Schritts:
Dieser Schritt umfasst die folgenden Wissenssysteme:
Seitenfragment-Caching-Technologien wie ESI. Um sie gut zu nutzen, musst du auch die Implementierung von ESI usw. beherrschen.
Architektur-Evolution Schritt 4: Daten-Cache
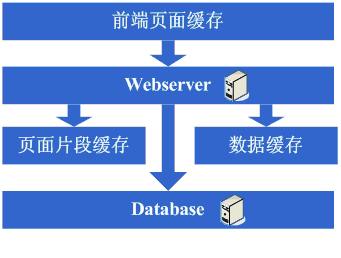
Nachdem Sie Technologien wie ESI verwendet haben, um die Cache-Effektivität des Systems weiter zu verbessern, sank der Druck auf das System weiter. Doch als die Anzahl der Zugriffe erneut zunahm, begann das System langsamer zu werden. Bei einer Untersuchung stellen Sie möglicherweise fest, dass es einige Stellen im System gibt, die wiederholt Dateninformationen abrufen, z. B. das Abrufen von Benutzerinformationen. An diesem Punkt beginnen Sie zu überlegen, ob diese Dateninformationen ebenfalls zwischengespeichert werden können. Also speichern Sie diese Daten im lokalen Speicher zwischen. Nach Abschluss der Änderungen entspricht es voll und ganz den Erwartungen: Die Antwortgeschwindigkeit des Systems erholt sich, und der Druck auf die Datenbank wird erneut deutlich reduziert.
Werfen Sie einen Blick auf das Systemdiagramm nach Abschluss dieses Schritts:
Dieser Schritt umfasst die folgenden Wissenssysteme:
Caching-Technologien, einschließlich Datenstrukturen wie Map, Cache-Algorithmen, die Implementierungsmechanismen des gewählten Frameworks selbst usw.
Architektur-Evolution Schritt 5: Webserver hinzufügen
Gute Zeiten währen nicht lange. Sie stellen fest, dass mit der erneuten Zunahme des Zugriffsvolumens des Systems der Druck auf den Webserver-Rechner zu Spitzenzeiten auf ein relativ hohes Niveau steigt. An diesem Punkt beginnen Sie, über das Hinzufügen eines Webservers nachzudenken. Dies dient gleichzeitig auch der Lösung des Verfügbarkeitsproblems, um die Situation zu vermeiden, dass das System unbrauchbar wird, wenn ein einzelner Webserver ausfällt. Nach Abwägung dieser Probleme entscheiden Sie sich, einen Webserver hinzuzufügen. Beim Hinzufügen eines Webservers werden Sie auf einige Probleme stoßen, typischerweise:
1. Wie die Zugriffe auf diese beiden Maschinen verteilt werden. Zu diesem Zeitpunkt sind die üblicherweise in Betracht gezogenen Lösungen die in Apache integrierte Load-Balancing-Lösung oder Software-Load-Balancing-Lösungen wie LVS.
2. Wie Zustandsinformationen synchron gehalten werden, wie z. B. Benutzersitzungen. Zu diesem Zeitpunkt gehören zu den in Betracht zu ziehenden Lösungen das Schreiben in eine Datenbank, das Schreiben in einen Speicher, Cookies oder Mechanismen zur Synchronisierung von Sitzungsinformationen.
3. Wie Daten-Cache-Informationen synchron gehalten werden, wie z. B. die zuvor zwischengespeicherten Benutzerdaten. Zu diesem Zeitpunkt gehören zu den üblicherweise in Betracht gezogenen Mechanismen die Cache-Synchronisierung oder das verteilte Caching.
4. Wie man Funktionen wie Datei-Uploads normal funktionsfähig hält. Zu diesem Zeitpunkt ist der üblicherweise in Betracht gezogene Mechanismus die Verwendung eines gemeinsamen Dateisystems oder Speichers.
Nach der Lösung dieser Probleme wurde der Webserver schließlich auf zwei Maschinen erweitert, und das System erreichte schließlich wieder seine vorherige Geschwindigkeit.
Werfen Sie einen Blick auf das Systemdiagramm nach Abschluss dieses Schritts:
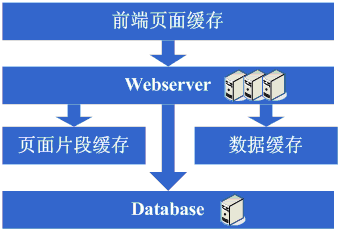
Dieser Schritt umfasst die folgenden Wissenssysteme:
Lastverteilungstechnologien (einschließlich, aber nicht beschränkt auf Hardware-Lastverteilung, Software-Lastverteilung, Lastverteilungsalgorithmen, Linux-Weiterleitungsprotokolle, Implementierungsdetails der gewählten Technologien usw.), Aktiv-Standby-Technologien (einschließlich, aber nicht beschränkt auf ARP-Spoofing, Linux-Heartbeat usw.), Technologien zur Synchronisierung von Zustandsinformationen oder Caches (einschließlich, aber nicht beschränkt auf Cookie-Technologie, UDP-Protokoll, Broadcasting von Zustandsinformationen, Implementierungsdetails der gewählten Cache-Synchronisierungstechnologie usw.), gemeinsame Dateitechnologien (einschließlich, aber nicht beschränkt auf NFS usw.), Speichertechnologien (einschließlich, aber nicht beschränkt auf Speichergeräte usw.).
Schritt 6 der Architekturentwicklung: Datenbank-Sharding
Nachdem Sie eine Zeit des Glücks mit rapidem Wachstum des Systemverkehrs genossen haben, stellen Sie fest, dass das System wieder langsamer wird. Was ist diesmal die Situation? Bei der Untersuchung stellen Sie fest, dass bei Vorgängen wie Datenbankschreibvorgängen und Aktualisierungen der Wettbewerb um einige Datenbankverbindungsressourcen sehr hart ist, was das System verlangsamt. Was nun tun? Die zu diesem Zeitpunkt verfügbaren Optionen umfassen Datenbank-Clustering und die Datenbank-Sharding-Strategie. Beim Clustering werden einige Datenbanken nicht gut unterstützt, daher wird Datenbank-Sharding zu einer gebräuchlicheren Strategie. Datenbank-Sharding bedeutet auch, dass die ursprünglichen Programme geändert werden müssen. Nach einer Runde von Änderungen zur Implementierung von Sharding stellt sich heraus, dass es gut funktioniert: Das Ziel ist erreicht, und das System erholt sich oder wird sogar schneller als zuvor.
Werfen Sie einen Blick auf das Systemdiagramm nach Abschluss dieses Schritts:
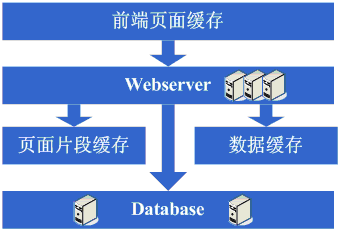
Dieser Schritt umfasst die folgenden Wissenssysteme:
Dieser Schritt erfordert hauptsächlich eine sinnvolle Aufteilung auf Geschäftsebene, um Datenbank-Sharding zu erreichen; es gibt keine weiteren Anforderungen an spezifische technische Details.
Gleichzeitig müssen jedoch mit steigendem Datenvolumen und fortschreitendem Datenbank-Sharding das Design, das Tuning und die Wartung der Datenbank besser umgesetzt werden. Daher werden weiterhin hohe Anforderungen an die Technologien in diesen Bereichen gestellt.
Architektur-Evolution Schritt 7: Tabellen-Sharding, DAL und verteilter Cache
Während das System weiterläuft, beginnt das Datenvolumen erheblich zu wachsen. Zu diesem Zeitpunkt stellen Sie fest, dass Abfragen nach dem Datenbank-Sharding immer noch etwas langsam sind, also beginnen Sie – nach derselben Idee wie beim Datenbank-Sharding – mit dem Tabellen-Sharding. Natürlich erfordert dies zwangsläufig einige Änderungen an den Programmen. Vielleicht erkennen Sie zu diesem Zeitpunkt, dass es etwas kompliziert ist, die Anwendung selbst für die Regeln des Datenbank- und Tabellen-Shardings verantwortlich zu machen. Daraus entsteht die Idee, ein generisches Framework hinzuzufügen, um den Datenzugriff für Datenbank- und Tabellen-Sharding zu implementieren; in der Architektur von eBay entspricht dies DAL. Dieser Evolutionsprozess dauert relativ lange. Natürlich ist es auch möglich, dass mit diesem generischen Framework erst nach Abschluss des Tabellen-Shardings begonnen wird. In dieser Phase stellen Sie möglicherweise fest, dass die bisherige Cache-Synchronisierungslösung Probleme aufweist, weil das Datenvolumen zu groß ist, sodass es nicht mehr möglich ist, Caches lokal zu speichern und dann zu synchronisieren. Sie müssen eine verteilte Cache-Lösung einführen. Nach einer weiteren Runde von Untersuchungen und Ringen verlagern Sie schließlich eine große Menge an Daten-Cache auf verteiltes Caching.
Werfen Sie einen Blick auf das Systemdiagramm nach Abschluss dieses Schritts:
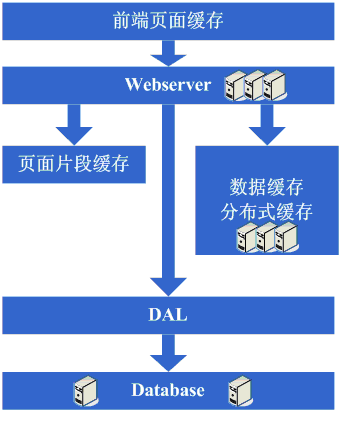
Dieser Schritt umfasst die folgenden Wissenssysteme:
Beim Tabellen-Sharding geht es ebenfalls eher um eine Aufteilung auf Geschäftsebene; technisch umfasst es dynamische Hash-Algorithmen, konsistente Hash-Algorithmen usw.
DAL umfasst viele komplexe Technologien, wie Datenbankverbindungsverwaltung (Timeouts, Ausnahmen), Datenbankoperationssteuerung (Timeouts, Ausnahmen), Kapselung von Regeln für Datenbank- und Tabellen-Sharding usw.
Architekturentwicklung Schritt 8: Mehr Webserver hinzufügen
Nach Abschluss der Arbeit am Datenbank- und Tabellen-Sharding ist der Druck auf die Datenbank auf ein relativ niedriges Niveau gesunken, und du beginnst wieder ein glückliches Leben zu führen, während du beobachtest, wie die Besucherzahlen täglich in die Höhe schnellen. Dann stellst du eines Tages plötzlich fest, dass der Zugriff auf das System wieder langsamer wird. Zu diesem Zeitpunkt prüfst du zuerst die Datenbank, und der Druck ist völlig normal. Dann prüfst du den Webserver und stellst fest, dass Apache viele Anfragen blockiert, während der Anwendungsserver für jede Anfrage noch relativ schnell ist. Es scheint, dass die Anzahl der Anfragen zu hoch ist, was zu Warteschlangen und langsameren Antwortzeiten führt. Das ist einfacher zu handhaben. Im Allgemeinen hast du zu diesem Zeitpunkt auch etwas Geld, also fügst du einige Webserver-Server hinzu. Während des Prozesses des Hinzufügens von Webserver-Servern können mehrere Herausforderungen auftreten:
1. Wenn Software-Load-Balancing mit Apache oder Software-Load-Balancing mit LVS die Planung riesiger Web-Zugriffsvolumen (Anfrageverbindungen, Netzwerkverkehr usw.) nicht mehr bewältigen kann, besteht die Vorgehensweise zu diesem Zeitpunkt, wenn das Budget es erlaubt, darin, Hardware-Load-Balancer wie F5, Netsclar, Athelon usw. zu kaufen. Wenn das Budget es nicht erlaubt, besteht die Vorgehensweise darin, Anwendungen bis zu einem gewissen Grad logisch zu klassifizieren und sie dann auf verschiedene Software-Load-Balancing-Cluster zu verteilen.
2. Einige bestehende Lösungen wie die Synchronisierung von Statusinformationen und Dateifreigabe können zu Engpässen werden und müssen verbessert werden. Vielleicht werden zu diesem Zeitpunkt je nach Bedarf verteilte Dateisysteme entwickelt, die den Geschäftsanforderungen der Website entsprechen.
Nach Abschluss dieser Aufgaben treten wir in eine Ära scheinbar perfekter unendlicher Skalierbarkeit ein. Wenn der Datenverkehr der Website zunimmt, besteht die Lösung darin, kontinuierlich Webserver hinzuzufügen.
Werfen Sie einen Blick auf das Systemdiagramm nach Abschluss dieses Schritts:
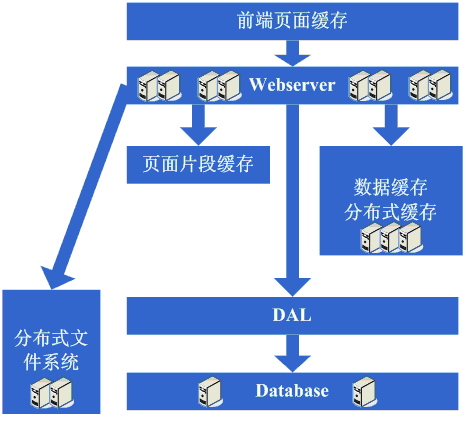
Dieser Schritt umfasst die folgenden Wissenssysteme:
In diesem Schritt ist angesichts des kontinuierlichen Wachstums der Maschinenzahl, des kontinuierlichen Wachstums des Datenvolumens und der immer höheren Anforderungen an die Systemverfügbarkeit ein tieferes Verständnis der eingesetzten Technologien erforderlich, und es müssen stärker maßgeschneiderte Produkte basierend auf den Anforderungen der Website entwickelt werden.
Architekturevolution Schritt 9: Daten-Lese-/Schreib-Trennung und kostengünstige Speicherlösungen
Plötzlich stellen wir eines Tages fest, dass auch diese perfekte Ära zu Ende geht. Der Datenbank-Albtraum erscheint wieder vor unseren Augen. Weil zu viele Webserver hinzugefügt wurden, sind die Datenbankverbindungsressourcen immer noch unzureichend, und zu diesem Zeitpunkt wurde die Datenbank bereits in mehrere Datenbanken und Tabellen aufgeteilt. Bei der Analyse der Datenbanklast kann festgestellt werden, dass das Lese-/Schreibverhältnis der Datenbank sehr hoch ist. Zu diesem Zeitpunkt kommt einem normalerweise die Lösung der Daten-Lese-/Schreib-Trennung in den Sinn. Natürlich ist diese Lösung nicht einfach umzusetzen. Darüber hinaus kann festgestellt werden, dass das Speichern einiger Daten in der Datenbank etwas verschwenderisch ist oder zu viele Datenbankressourcen beansprucht. Daher besteht die Architekturevolution, die sich in dieser Phase möglicherweise herausbildet, darin, eine Daten-Lese-/Schreib-Trennung zu implementieren und gleichzeitig einige kostengünstigere Speicherlösungen zu entwickeln, wie z. B. BigTable.
Werfen Sie einen Blick auf das Systemdiagramm nach Abschluss dieses Schritts:
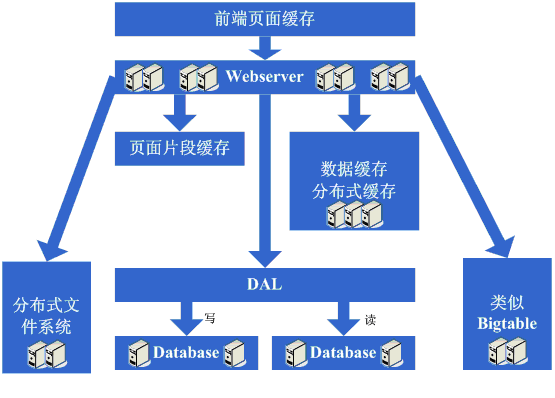
Dieser Schritt umfasst die folgenden Wissenssysteme:
Die Daten-Lese-/Schreib-Trennung erfordert eine tiefe Beherrschung und ein tiefes Verständnis von Datenbankreplikation, Standby und anderen Strategien sowie die Fähigkeit, sie unabhängig umzusetzen.
Kostengünstige Speicherlösungen erfordern eine tiefe Beherrschung und ein tiefes Verständnis der OS-Dateispeicherung und außerdem eine tiefe Beherrschung dessen, wie die eingesetzte Sprache die Dateiverarbeitung implementiert.
Evolution der Architektur Schritt 10: Eintritt in die Ära groß angelegter verteilter Anwendungen und die Traumära kostengünstiger Server-Cluster
Nach diesem langen und schmerzhaften Prozess kommt schließlich erneut die perfekte Ära. Durch kontinuierliches Hinzufügen von Webservern kann immer höherer Traffic bewältigt werden. Für große Websites steht die Bedeutung der Popularität außer Frage. Mit wachsender Popularität beginnen auch die verschiedenen funktionalen Anforderungen explosionsartig zu wachsen. An diesem Punkt wird plötzlich festgestellt, dass die ursprünglich auf Webservern bereitgestellte Webanwendung sehr riesig geworden ist. Wenn mehrere Teams beginnen, sie zu ändern, ist das ziemlich unpraktisch, und die Wiederverwendbarkeit ist ziemlich schlecht. Im Grunde verrichtet jedes Team mehr oder weniger repetitive Arbeit, und Bereitstellung und Wartung sind ebenfalls ziemlich mühsam, denn das Kopieren und Starten des riesigen Anwendungspakets auf N Maschinen verbraucht beträchtliche Zeit, und Probleme lassen sich bei ihrem Auftreten nicht leicht beheben. Eine weitere, noch schlimmere Situation ist, dass ein Fehler in einer Anwendung dazu führen kann, dass die gesamte Website nicht mehr verfügbar ist. Es gibt auch andere Faktoren wie die Schwierigkeit beim Tuning (weil die auf den Maschinen bereitgestellten Anwendungen alles erledigen müssen, was ein gezieltes Tuning schlicht unmöglich macht). Aufgrund dieser Analyse wird eine feste Entscheidung getroffen, das System nach Verantwortlichkeiten aufzuteilen, und so entsteht eine groß angelegte verteilte Anwendung. Normalerweise nimmt dieser Schritt beträchtliche Zeit in Anspruch, da er auf viele Herausforderungen stößt:
1. Nach der Aufteilung in eine verteilte Architektur muss ein leistungsfähiges, stabiles Kommunikationsframework bereitgestellt werden, und es muss mehrere verschiedene Kommunikations- und Remote-Aufrufmethoden unterstützen.
2. Die Aufteilung einer riesigen Anwendung dauert lange und erfordert die Organisation der Geschäftsbereiche sowie die Kontrolle der Systemabhängigkeiten usw.
3. Wie man diese riesige verteilte Anwendung ordnungsgemäß betreibt und wartet (Abhängigkeitsverwaltung, Verwaltung des Gesundheitszustands, Fehlerverfolgung, Tuning, Monitoring und Alarmierung usw.).
Nach diesem Schritt tritt die Systemarchitektur in eine relativ stabile Phase ein. Gleichzeitig wird es möglich, eine große Anzahl kostengünstiger Maschinen zu nutzen, um den enormen Verkehr und das Datenvolumen zu bewältigen. Durch die Kombination dieser Architektur mit den Erfahrungen aus diesen vielen Evolutionsprozessen werden verschiedene andere Methoden eingesetzt, um immer höheren Verkehr zu unterstützen.
Werfen Sie einen Blick auf das Systemdiagramm nach Abschluss dieses Schritts:
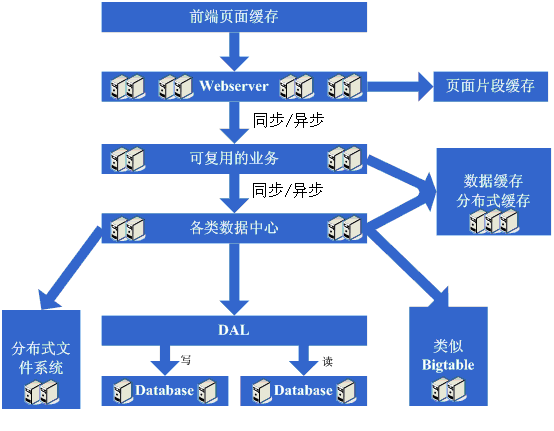
Dieser Schritt umfasst die folgenden Wissenssysteme:
Dieser Schritt umfasst eine Vielzahl von Wissenssystemen. Er erfordert tiefes Verständnis und Beherrschung von Kommunikation, Remote-Aufrufen, Nachrichtenmechanismen usw. Er erfordert ein klares Verständnis von der Theorie, der Hardware-Ebene, der Betriebssystem-Ebene sowie der Implementierung der verwendeten Sprache.
Betrieb und Wartung umfassen ebenfalls eine Vielzahl von Wissenssystemen. In den meisten Fällen ist es notwendig, verteiltes paralleles Rechnen, Berichterstellung, Überwachungstechnologien, Regelstrategien und so weiter zu beherrschen.
Es ist wirklich nicht sehr mühsam, darüber zu sprechen. Der klassische Evolutionsprozess der gesamten Website-Architektur ähnelt dem oben Beschriebenen ziemlich stark. Natürlich können die bei jedem Schritt gewählten Lösungen und die Evolutionsschritte variieren. Außerdem gibt es aufgrund unterschiedlicher Website-Geschäfte unterschiedliche fachliche Technologieanforderungen. Dieser Blog erklärt den Evolutionsprozess eher aus architektonischer Sicht. Natürlich werden hier viele Technologien nicht erwähnt, wie Datenbank-Clustering, Data Mining, Suche usw. Aber im realen Evolutionsprozess werden auch Dinge wie die Aufrüstung von Hardwarekonfigurationen, Netzwerkumgebungen, die Umstellung von Betriebssystemen, CDN-Spiegelung usw. eingesetzt, um größeren Traffic zu bewältigen. Daher wird es im realen Entwicklungsprozess viele Unterschiede geben. Außerdem muss eine große Website weit mehr erreichen als das oben Aufgeführte, einschließlich Sicherheit, Betrieb, Geschäftsbetrieb, Dienste, Speicher usw. Es ist wirklich nicht einfach, eine große Website gut aufzubauen. Dieser Artikel wurde eher in der Hoffnung geschrieben, mehr Einführungen zur Architekturevolution großer Websites anzuregen.
URL des Originalbeitrags: http://www.blogjava.net/BlueDavy/archive/2008/09/03/226749.html