Kürzlich habe ich Matlab verwendet, um Simulationsexperimente mit 3D-Daten verschiedener unterschiedlicher Modelle durchzuführen. Viele davon erfordern das Anpassen von 3D-Daten. Matlab wird mit einer Fitting-Toolbox (cftool) geliefert, die tatsächlich leistungsstark ist. Die Verwendung der Toolbox zur Datenanpassung erspart viel Mühe. Bei Originalmodellen mit ausreichend großen Datensätzen kann cftool die gewünschten Ergebnisse sehr genau anpassen. Natürlich sprechen wir nicht über Matlab. Dieser Artikel hat überhaupt nichts mit Matlab zu tun. ~~ Ich habe zu viel geredet; fangen wir jetzt an.
I. Datenprototyp
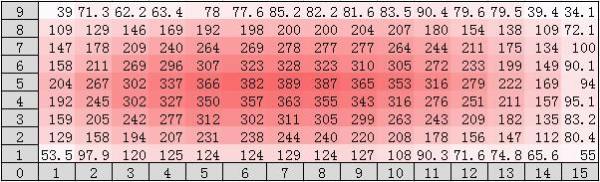
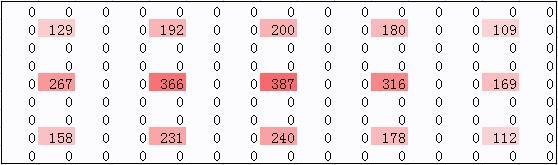
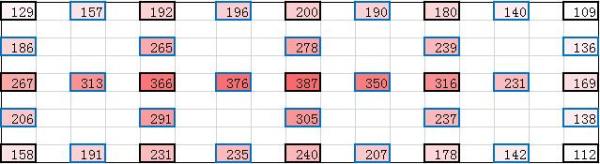
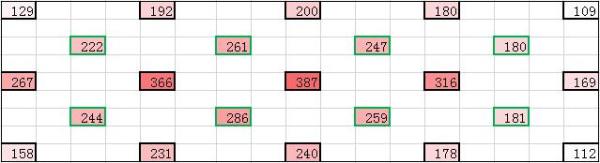
Zuerst importieren wir eine vollständige Datentabelle. Wir können sehen, dass dies eine y=9 x=15-Matrix ist, mit einer Größe von 9x15. Jedes Element der Matrix entspricht einem Wert z. Die zweite Abbildung zeigt die Daten, die wir aus den entsprechenden Positionen in der ersten Abbildung herausgepickt haben. Es ist eine gültige Matrix der Größe 3x5.
Auf diese Weise haben wir praktisch Daten mit einer Defektrate von etwa 90 % aus den Originaldaten erzeugt. Unsere anschließende Interpolationsanpassung zielt dann darauf ab, entsprechende Berechnungen auf diesen unvollständigen Daten durchzuführen.
II. Interpolationsanpassung
1. Konzepteinführung
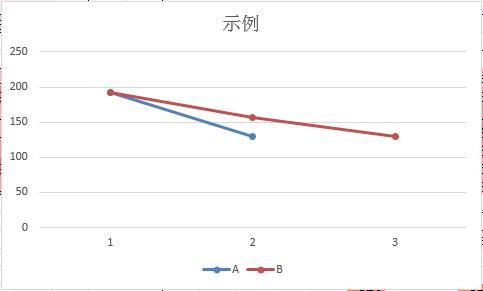
Gegeben sind zwei Zahlen (129, 192); Sie werden gebeten, linear einen Wert zwischen ihnen einzufügen. Tatsächlich gibt es viele Möglichkeiten einzufügen. Zum Beispiel linear in einer 2D-Ebene: B2 = (A1+A2)/2, oder linear im 3D-Raum; wir verwenden Folgendes.

A: 192 129
B :192 157 129
2. Anpassung erster Ordnung
Nach der obigen Konzepteinführung führen wir als Nächstes eine Interpolation erster Ordnung auf unseren unvollständigen Daten durch. Siehe die Formel unten.
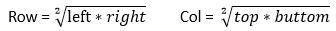
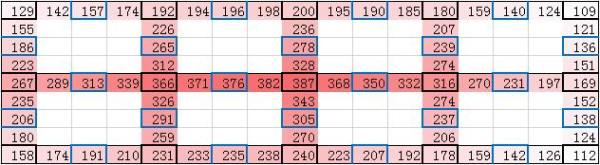
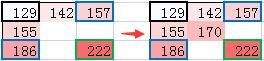
Die schwarzen Kästchen sind gültige Scheitelpunktdaten. Wir verwenden den Algorithmus, um jedes Paar von zwei Scheitelpunkten zu durchlaufen. Solange einer davon gültige Daten ist (schwarzes Kästchen; das ist sehr wichtig, sehr wichtig, sehr wichtig – wichtige Dinge muss man dreimal sagen), fügen wir einen Datenpunkt ein (blaue Kästchendaten). Zum Beispiel zwischen den zeilenbenachbarten Scheitelpunkten 129 und 192 157 einfügen; zwischen benachbarten Scheitelpunkten 129 und 267 186 einfügen. Die Ergebnisse sind in der folgenden Abbildung dargestellt.
Ist die Interpolation erster Ordnung abgeschlossen? Nein, schauen Sie sich die obigen Daten noch einmal an. Nach der ersten Einfügungsrunde müssen die neu hinzugefügten benachbarten Eckpunkte noch interpoliert werden. Da meine Datenmatrix nicht groß ist, kann ich nach der zweiten Einfügungsrunde keine benachbarten leeren Punkte mehr in meinen Daten finden. Wenn die Datenmatrix sehr groß ist, kann unser Code im Hinblick auf die Algorithmusimplementierung an diesem Punkt in rekursiver Form geschrieben werden, und er beginnt erst mit dem Poppen des Stapels, wenn alle Einfügungen abgeschlossen sind (die Wirkung ist wie folgt).
>3. Anpassung zweiter Ordnung
Unsere Anpassung zweiter Ordnung richtet sich vollständig nach den Ergebnissen der Anpassung erster Ordnung. Mein Entwurf zweiter Ordnung besteht darin, einen Datenpunkt im grünen Kasten durch vier gültige Eckpunkte zu interpolieren (schwarze Kästen sind gültige Eckpunkte; wichtige Dinge sagt man nur einmal). AD ist eine Diagonale, BC ist eine Diagonale. Beziehen Sie sich auf die folgende Formel.
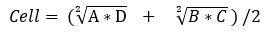
Hinweis: Nach dem Einfügen wird keine Anpassung erster Ordnung durchgeführt. Für die erste Ordnung ist die Unterstützung durch Daten aus den schwarzen Kästen erforderlich; zwei beliebige blaue oder grüne Datenpunkte benötigen sie nicht.
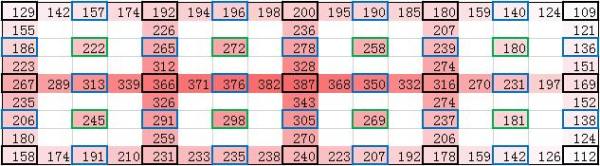
Aus Gründen eines besseren Aussehens habe ich den Inhalt erster Ordnung entfernt. Wenn das Ergebnis der Anpassung erster Ordnung nicht mein unten stehendes Modell ist, ist eine Modelltransformation erforderlich. Wie genau geht das? Denken Sie selbst darüber nach, oder hinterlassen Sie mir eine Nachricht (für den Kern, privater Chat).
4. Anpassung dritter Ordnung
Die Interpolation dritter Ordnung ist im Grunde dieselbe wie die Interpolation zweiter Ordnung. Der einzige Unterschied: Beliebige vier Eckpunkte (nicht auf schwarze Kästen beschränkt), einfügen gemäß der obigen Formel. Man erhält die zweite Abbildung.
5. Hilfspunkte löschen
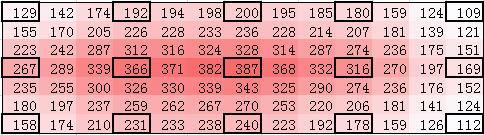
Abschließend möchte ich allen sagen, dass oben, mit Ausnahme der schwarzen Kästen, die gültige Daten sind, die Kästen der anderen Farben Hilfsdaten sind, ähnlich wie die Hilfslinien, die beim Lösen von Geometrieaufgaben gezeichnet werden. Löschen Sie sie jetzt. Beziehen Sie sich auf das Ergebnis nach dem Löschen unten.
6. Abweichung mit Datenprototyp vergleichen
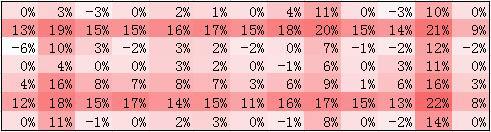
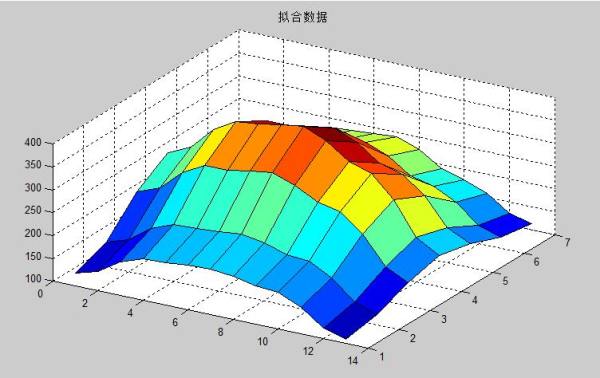
Die durchschnittliche Abweichung beträgt 7% und die maximale Abweichung beträgt 22%. Relativ gesehen ist die Anpassung ziemlich gut. Vergessen Sie nicht: Ich habe nur 10% der Daten und muss 90% der Daten anpassen.
7. Ergebnisausgabe
8. Zusammenfassung
95% der Zeit wird damit verbracht, über eine Lösung nachzudenken, und 5% der Zeit wird damit verbracht, die Lösung in Code umzusetzen. Können nach dem Lesen dieses Artikels Oberflächenanpassungen problemlos bewältigt werden?
(Dieser Algorithmus basiert auf symmetrischen, regelmäßigen Modellen; die Anpassungsfähigkeit an unregelmäßige Modelle wurde noch nicht getestet). Bitte hinterlassen Sie ein Like, bevor Sie gehen!
Autor: showlo
Link: https://zhuanlan.zhihu.com/p/24275757
Quelle: Zhihu