Récemment, j'ai utilisé Matlab pour réaliser des expériences de simulation sur des données 3D de divers modèles différents. Beaucoup d'entre elles nécessitent l'ajustement de données 3D. Matlab est livré avec une boîte à outils d'ajustement (cftool), qui est effectivement puissante. Utiliser la boîte à outils pour l'ajustement de données épargne bien des tracas. Pour des modèles d'origine avec des jeux de données suffisants, cftool peut ajuster de manière très précise les résultats que nous souhaitons. Bien sûr, nous ne parlons pas de Matlab. Cet article n'a rien à voir avec Matlab du tout. ~~ J'ai trop parlé ; commençons maintenant.
I. Prototype de données
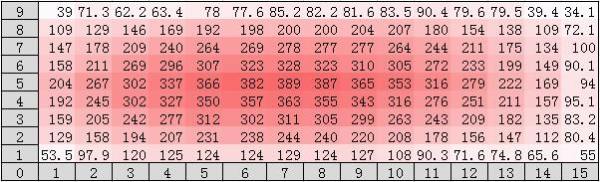
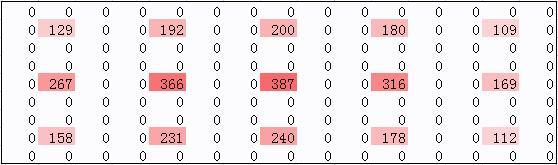
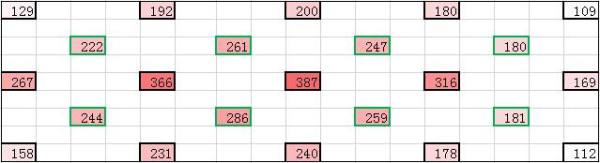
Tout d'abord, importez une table de données complète. Nous pouvons voir qu'il s'agit d'une matrice y=9 x=15, de taille 9x15. Chaque élément de la matrice correspond à une valeur z. La deuxième figure représente les données que nous avons extraites des positions correspondantes dans la première figure. Il s'agit d'une matrice valide de taille 3x5.
De cette manière, nous avons virtuellement créé des données présentant un taux de défaut pouvant atteindre environ 90 % à partir des données d'origine. Notre ajustement par interpolation ultérieur vise alors à effectuer les calculs correspondants sur ces données incomplètes.
II. Ajustement par interpolation
1. Introduction du concept
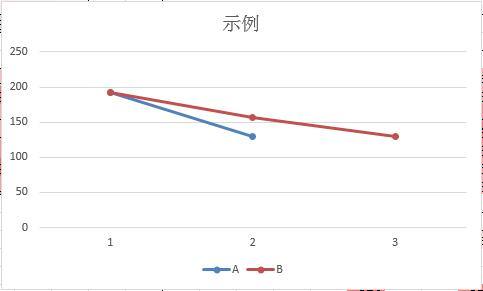
Étant donné deux nombres (129, 192), il vous est demandé d'insérer linéairement une valeur entre eux. En fait, il existe de nombreuses façons d'insérer. Par exemple, linéaire dans un plan 2D : B2 = (A1+A2)/2, ou linéaire dans l'espace 3D ; nous utilisons ce qui suit.

A: 192 129
B :192 157 129
2. Ajustement de premier ordre
Après l'introduction du concept ci-dessus, nous effectuons ensuite une interpolation de premier ordre sur nos données incomplètes. Reportez-vous à la formule ci-dessous.
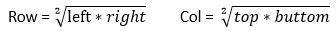
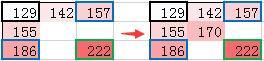
Les cases noires sont des données de sommet valides. Nous utilisons l'algorithme pour parcourir deux sommets quelconques. Tant que l'un d'eux est une donnée valide (case noire ; c'est très important, très important, très important — les choses importantes doivent être dites trois fois), insérer un point de données (données de la case bleue). Par exemple, entre les sommets adjacents en ligne 129 et 192, insérer 157 ; entre les sommets adjacents 129 et 267, insérer 186. Les résultats sont présentés dans la figure ci-dessous.
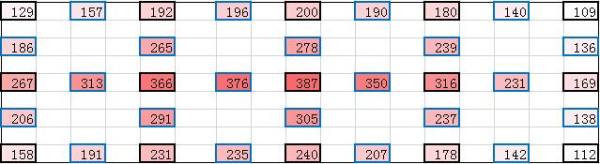
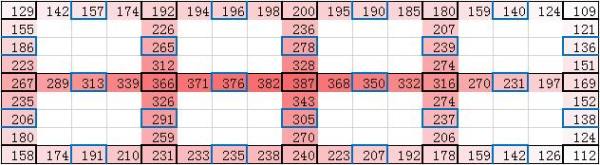
L'interpolation du premier ordre est-elle terminée ? Non, regardez à nouveau les données ci-dessus. Après la première série d'insertions, les sommets adjacents nouvellement ajoutés doivent encore être interpolés. Comme ma matrice de données n'est pas grande, après la deuxième série d'insertions, je ne peux plus trouver de points vides adjacents dans mes données. Si la matrice de données est très grande, du point de vue de l'implémentation de l'algorithme, à ce stade notre code peut être écrit sous forme récursive, et il ne commencera à dépiler la pile qu'une fois toutes les insertions terminées (l'effet est le suivant).
>3. Ajustement du second ordre
Notre ajustement du second ordre est entièrement ajusté sur la base des résultats de l'ajustement du premier ordre. Ma conception du second ordre consiste à interpoler un point de données encadré en vert via quatre sommets valides (les cases noires sont des sommets valides ; les choses importantes ne se disent qu'une fois). AD est une diagonale, BC est une diagonale. Reportez-vous à la formule suivante.
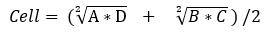
Remarque : après l'insertion, l'ajustement du premier ordre n'est pas effectué. Le premier ordre nécessite le support de données des cases noires ; deux points de données bleus ou verts quelconques n'en ont pas besoin.
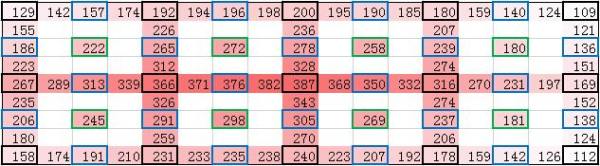
Pour une meilleure apparence, j'ai supprimé le contenu du premier ordre. Si le résultat de l'ajustement du premier ordre n'est pas mon modèle ci-dessous, une transformation de modèle est nécessaire. Comment procéder exactement ? Réfléchissez-y vous-même, ou laissez-moi un message (pour le cœur, en discussion privée).
4. Ajustement du troisième ordre
L'interpolation du troisième ordre est essentiellement identique à l'interpolation du second ordre. La seule différence : quatre sommets quelconques (pas limités aux cases noires), insérez selon la formule ci-dessus. Obtenez la deuxième figure.
5. Supprimer les points auxiliaires
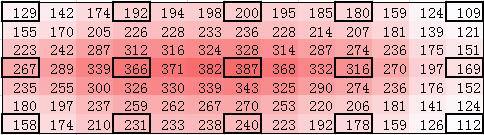
Enfin, laissez-moi vous dire à tous que ci-dessus, à l'exception des cases noires qui sont des données valides, les cases des autres couleurs sont des données auxiliaires, semblables aux lignes auxiliaires tracées lors de la résolution de problèmes de géométrie. Supprimez-les maintenant. Reportez-vous au résultat après suppression ci-dessous.
6. Comparer l'écart avec le prototype de données
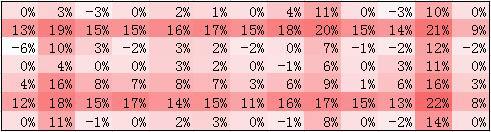
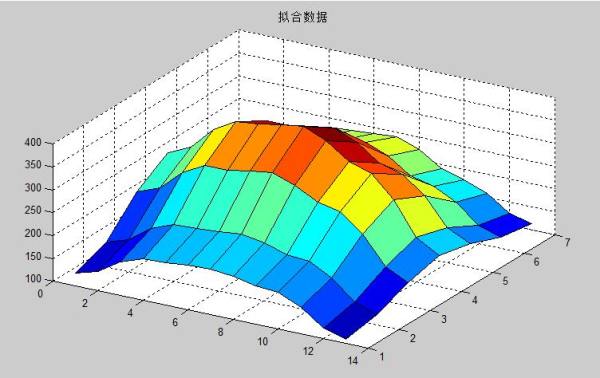
L'écart moyen est de 7% et l'écart maximal est de 22%. Relativement parlant, l'ajustement est plutôt bon. N'oubliez pas que je ne dispose que de 10% des données et que je dois ajuster 90% des données.
7. Sortie des résultats
8. Résumé
95% du temps est consacré à réfléchir à une solution, et 5% du temps à écrire la solution sous forme de code. Après avoir lu cet article, l'ajustement de surface peut-il être facilement traité ?
(Cet algorithme est basé sur des modèles symétriques et réguliers ; l'adaptabilité aux modèles irréguliers n'a pas encore été testée). Veuillez laisser un like avant de partir !
Auteur : showlo
Lien : https://zhuanlan.zhihu.com/p/24275757
Source : Zhihu