Недавно я использовал Matlab для проведения имитационных экспериментов с 3D-данными различных моделей. Для многих из них требуется аппроксимация 3D-данных. В Matlab есть встроенный инструмент аппроксимации (cftool), который действительно мощный. Использование этого инструмента для аппроксимации данных избавляет от множества хлопот. Для исходных моделей с достаточными наборами данных cftool может очень точно подогнать нужные нам результаты. Конечно, мы говорим не о Matlab. Эта статья вообще не имеет отношения к Matlab. ~~ Я слишком много говорил; давайте начнём.
I. Прототип данных
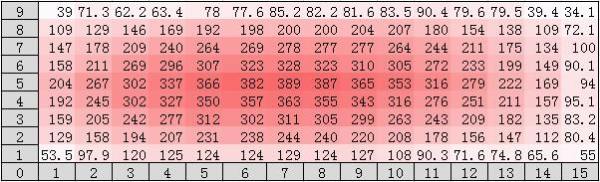
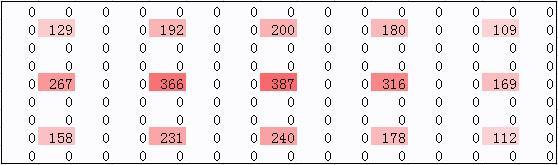
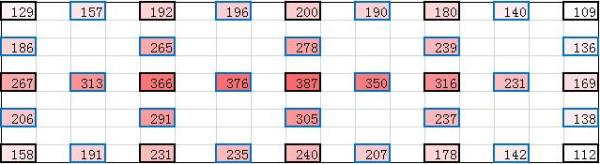
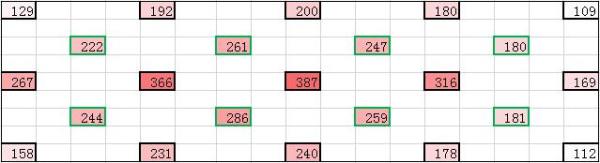
Сначала импортируем полную таблицу данных. Мы видим, что это матрица y=9 x=15 размером 9x15. Каждый элемент матрицы соответствует значению z. Второй рисунок — это данные, которые мы выбрали из соответствующих позиций на первом рисунке. Это допустимая матрица размером 3x5.
Таким образом, мы фактически создали из исходных данных данные с долей дефектов около 90%. Наша последующая интерполяционная аппроксимация направлена на выполнение соответствующих вычислений по этим неполным данным.
II. Интерполяционная аппроксимация
1. Введение в концепцию
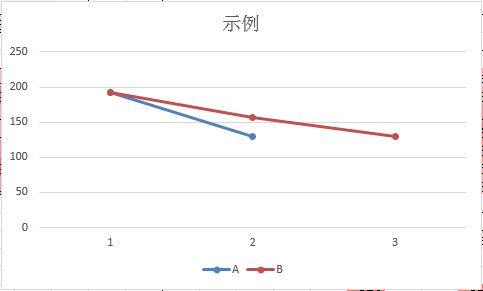
Даны два числа (129, 192); требуется линейно вставить значение между ними. На самом деле, есть много способов вставки. Например, линейно на 2D-плоскости: B2 = (A1+A2)/2, или линейно в 3D-пространстве; мы используем следующий.

A: 192 129
B :192 157 129
2. Аппроксимация первого порядка
После представленного выше введения в концепцию мы далее выполняем интерполяцию первого порядка для наших неполных данных. Обратитесь к формуле ниже.
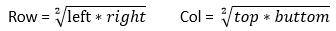
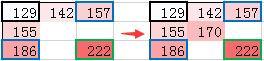
Чёрные квадраты — это допустимые данные вершин. Мы используем алгоритм для обхода любых двух вершин. Если хотя бы одна из них является допустимыми данными (чёрный квадрат; это очень важно, очень важно, очень важно — важные вещи нужно повторять три раза), вставляем точку данных (данные синего квадрата). Например, между соседними по строке вершинами 129 и 192 вставляем 157; между соседними вершинами 129 и 267 вставляем 186. Результаты показаны на рисунке ниже.
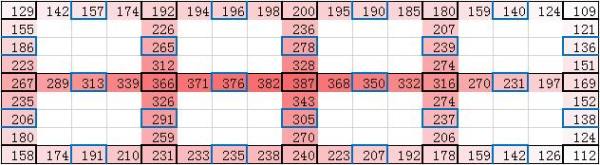
Интерполяция первого порядка завершена? Нет, посмотрите ещё раз на данные выше. После первого раунда вставки новым добавленным смежным вершинам всё ещё нужна интерполяция. Поскольку моя матрица данных невелика, после второго раунда вставки я уже не могу найти смежные пустые точки в своих данных. Если матрица данных очень большая, то с точки зрения реализации алгоритма на этом этапе наш код можно записать в рекурсивной форме, и он не начнёт разворачивать стек, пока все вставки не будут выполнены (эффект следующий).
>3. Аппроксимация второго порядка
Наша аппроксимация второго порядка полностью скорректирована на основе результатов аппроксимации первого порядка. Мой дизайн второго порядка состоит в том, чтобы интерполировать точку данных в зелёном квадрате через четыре действительные вершины (чёрные квадраты — это действительные вершины; важные вещи говорятся один раз). AD — диагональ, BC — диагональ. Обратитесь к следующей формуле.
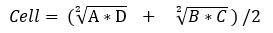
Примечание: после вставки аппроксимация первого порядка не выполняется. Первый порядок требует поддержки данных в чёрных квадратах; любые две синие или зелёные точки данных в ней не нуждаются.
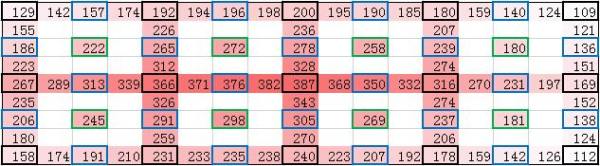
Для лучшего внешнего вида я удалил содержимое первого порядка. Если результат аппроксимации первого порядка не соответствует моей модели ниже, требуется преобразование модели. Как именно это сделать? Подумайте сами или оставьте мне сообщение (по главному — личное сообщение).
4. Аппроксимация третьего порядка
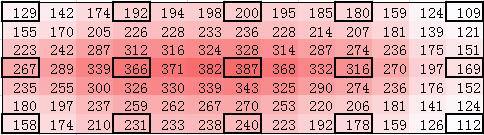
Интерполяция третьего порядка в основном такая же, как интерполяция второго порядка. Единственное отличие: любые четыре вершины (не ограничиваясь чёрными квадратами) вставляются по формуле выше. Получаем второй рисунок.
5. Удаление вспомогательных точек
Наконец, скажу всем, что выше, кроме чёрных квадратов, которые являются действительными данными, квадраты других цветов — это вспомогательные данные, аналогичные вспомогательным линиям, которые рисуют при решении геометрических задач. Теперь удалите их. Обратитесь к результату после удаления ниже.
6. Сравнение отклонения с прототипом данных
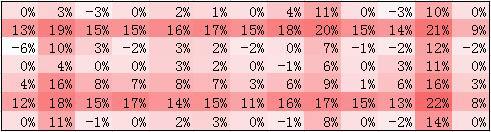
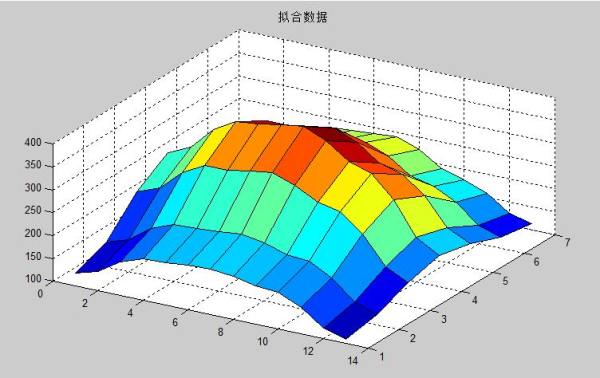
Среднее отклонение составляет 7%, а максимальное отклонение — 22%. Относительно говоря, подгонка довольно хорошая. Не забывайте, у меня есть только 10% данных, а нужно подогнать 90% данных.
7. Вывод результатов
8. Итоги
95% времени уходит на обдумывание решения, а 5% времени — на написание решения в виде кода. После прочтения этой статьи можно ли легко справиться с аппроксимацией поверхностей?
(Этот алгоритм основан на симметричных, регулярных моделях; адаптивность к нерегулярным моделям ещё не проверялась). Пожалуйста, поставьте лайк перед уходом!
Автор: showlo
Ссылка: https://zhuanlan.zhihu.com/p/24275757
Источник: Zhihu