Mit der weiten Verbreitung von Internetanwendungen sind Speicherung und Zugriff auf massenhafte Daten zu einem Engpass im Systemdesign geworden. Für eine groß angelegte Internetanwendung stellen Millionen oder sogar Hunderte Millionen PV pro Tag zweifellos eine beträchtliche Belastung für die Datenbank dar, was große Probleme für Systemstabilität und Skalierbarkeit verursacht.
I.LastverteilungTechnologie
Ein Lastverteilungs-Cluster besteht aus einer Gruppe unabhängiger Computersysteme, die über ein herkömmliches oder dediziertes Netzwerk verbunden und durch Router miteinander verknüpft sind. Die Knoten arbeiten zusammen, teilen die Last und gleichen die Belastung aus. Für den Client kann der gesamte Cluster als ein einzelner unabhängiger Server mit extrem hoher Leistung angesehen werden.
1. Implementierungsprinzip
Um Datenbank-Lastverteilungstechnologie zu implementieren, benötigt man zunächst einen Controller, der Verbindungen zur Datenbank steuern kann. Hier trennt er die direkte Verbindung zwischen der Datenbank und der Anwendung; alle Programme greifen auf diese Mittelschicht zu, und die Mittelschicht greift dann auf die Datenbank zu. Auf diese Weise können wir gezielt steuern, auf welche Datenbank zugegriffen wird, und außerdem effektive Lastverteilungsstrategien auf Grundlage der aktuellen Last der Datenbank einsetzen, um anzupassen, zu welcher Datenbank jede Verbindung geleitet wird.
2. Implementierung der Multi-Datenbank-Datensynchronisierung
Für die Lastverteilung ist das Wichtigste, dass die Daten auf allen Servern in Echtzeit synchronisiert werden. Dies ist für einen Cluster erforderlich, denn wenn Daten nicht in Echtzeit vorliegen oder nicht synchronisiert sind, unterscheiden sich die Daten, die ein Benutzer von einem Server liest, von den Daten, die von einem anderen Server gelesen werden, was nicht akzeptabel ist. Daher muss die Synchronisierung der Datenbankdaten implementiert werden. Auf diese Weise stehen bei Abfragen mehrere Ressourcen zur Verfügung, wodurch ein Ausgleich erreicht wird. Eine häufig verwendete Methode ist der Moebius for SQL Server Cluster. Der Moebius for SQL Server Cluster verwendet einen Ansatz, bei dem ein Kernprogramm in der Datenbank auf jedem Rechner läuft. Dieses Kernprogramm, genannt Moebius for SQL Server Middleware, überwacht hauptsächlich Änderungen an den Datenbankdaten und synchronisiert die geänderten Daten mit anderen Datenbanken. Der Client erhält eine Antwort erst, nachdem die Datensynchronisierung abgeschlossen ist. Der Synchronisierungsvorgang wird nebenläufig ausgeführt, sodass die Zeit für die Synchronisierung mit mehreren Datenbanken im Wesentlichen der Synchronisierung mit einer Datenbank entspricht. Darüber hinaus wird die Synchronisierung in einer Transaktionsumgebung durchgeführt, wodurch die Konsistenz mehrerer Datenkopien zu jedem Zeitpunkt gewährleistet wird. Gerade wegen der Innovation, die Moebius-Middleware in der Datenbank zu hosten, kennt die Middleware nicht nur Datenänderungen, sondern auch die SQL-Anweisungen, die die Änderungen verursacht haben. Basierend auf dem Typ der SQL-Anweisung wendet sie intelligent unterschiedliche Datensynchronisierungsstrategien an, um die Kosten der Datensynchronisierung zu minimieren.
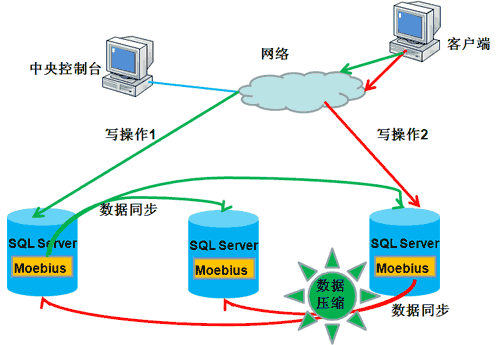
Wenn die Anzahl der Datenzeilen klein und der Dateninhalt nicht groß ist, synchronisieren Sie die Daten direkt.
Wenn die Anzahl der Datenzeilen klein ist, aber große Datentypen wie Text- oder Binärdaten enthält, komprimieren Sie die Daten zuerst und synchronisieren Sie sie dann, wodurch die Nutzung der Netzwerkbandbreite und die Übertragungszeit reduziert werden.
Wenn die Anzahl der Datenzeilen groß ist, ruft die Middleware die SQL-Anweisungen ab, die die Datenänderungen verursacht haben, parst dann die SQL-Anweisungen, analysiert ihre Ausführungspläne und Ausführungskosten und entscheidet, ob die Daten oder die SQL-Anweisungen mit anderen Datenbanken synchronisiert werden. Diese Situation ist sehr nützlich, wenn Tabellenstrukturen angepasst oder Daten stapelweise geändert werden.
3. Vorteile und Nachteile
(1) Hohe Skalierbarkeit: Wenn das System eine höhere Datenbankverarbeitungsgeschwindigkeit erfordert, kann es durch einfaches Hinzufügen von Datenbankservern erweitert werden.
(2) Wartbarkeit: Wenn ein Knoten ausfällt, erkennt das System den Fehler automatisch und überträgt die Anwendungen des fehlerhaften Knotens, wodurch der kontinuierliche Betrieb der Datenbank sichergestellt wird.
(3) Sicherheit: Da Daten mit mehreren Servern synchronisiert werden, kann eine Redundanz des Datenbestands erreicht werden, und die Sicherheit wird durch mehrere Datenkopien gewährleistet. Darüber hinaus wird die Datenbank erfolgreich im internen Netzwerk platziert, wodurch die Datenbanksicherheit besser geschützt wird.
(4) Benutzerfreundlichkeit: Sie ist für Anwendungen vollständig transparent; das Cluster gibt nur eine IP nach außen frei.
(1) Es kann die Last nicht entsprechend der Verarbeitungskapazität der Web-Server verteilen.
(2) Ein Ausfall des Lastverteilers (Controller) kann dazu führen, dass das gesamte Datenbanksystem lahmgelegt wird.
II. Datenbank-Lese-/Schreibtrennung
1. Implementierungsprinzip: Einfach ausgedrückt trennt die Lese-/Schreibtrennung Datenbank-Lese- und -Schreibvorgänge auf verschiedene Datenbankserver, was die Datenbanklast wirksam reduziert und auch die I/O-Last verringert. Die Primärdatenbank übernimmt Schreibvorgänge, und die sekundäre Datenbank übernimmt Lesevorgänge. Tatsächlich sind in vielen Systemen Lesevorgänge die Hauptoperationen. Wenn die Primärdatenbank Schreibvorgänge ausführt, müssen Daten mit der sekundären Datenbank synchronisiert werden, um die Datenintegrität wirksam sicherzustellen.
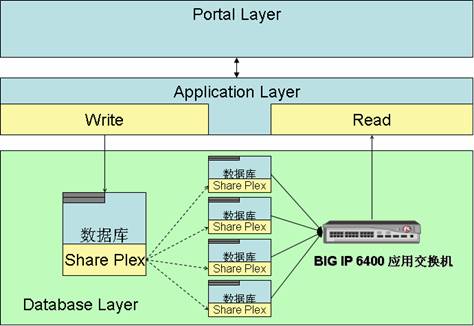
(eBays Lese-/Schreibverhältnis beträgt 260:1; eBay verwendet Lese-/Schreibtrennung.)
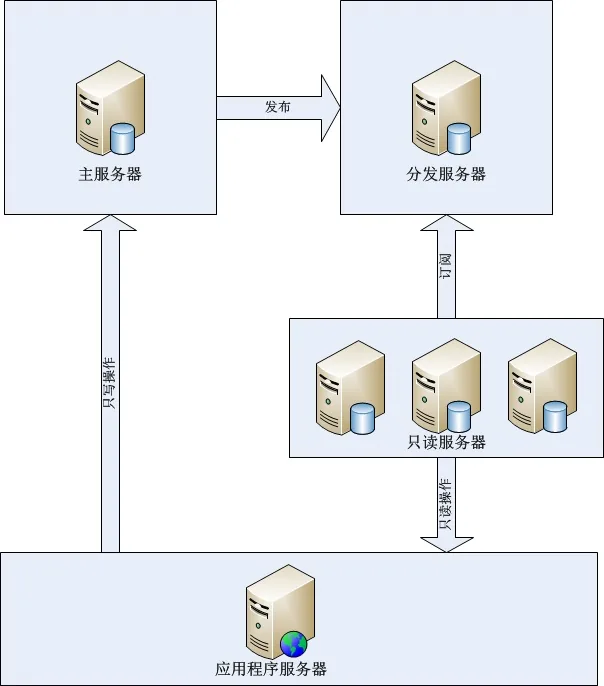
(Microsoft-Datenbankverteilung)
2. Implementierungsmethode: In MS SQL Server kann die Datenbankreplikation mithilfe von Veröffentlichungsdefinitionen implementiert werden, wodurch eine Trennung von Lesen und Schreiben erreicht wird. Replikation ist eine Technologie, die eine Datenmenge von einer Datenquelle auf mehrere Datenquellen kopiert, und ein effektiver Weg, eine Datenkopie auf mehreren Speicherorten zu veröffentlichen. Mithilfe der Replikationstechnologie können Benutzer eine Datenkopie auf mehreren Servern veröffentlichen. Die Replikationstechnologie stellt sicher, dass Daten an verschiedenen Orten automatisch aktualisiert und synchronisiert werden, wodurch Datenkonsistenz gewährleistet wird. Die SQL Server-Replikationstechnologie umfasst drei Typen: Momentaufnahme-Replikation, Transaktionsreplikation und Mergereplikation. SQL Server verwendet hauptsächlich Veröffentlichungen und Abonnements, um die Replikation abzuwickeln. Der Server, auf dem sich die Quelldaten befinden, ist der Publisher-Server, der für die Veröffentlichung von Daten verantwortlich ist. Der Publisher-Server kopiert alle Änderungen an den veröffentlichten Daten auf den Distributor-Server. Der Distributor-Server enthält eine Verteilungsdatenbank, empfängt alle Datenänderungen, speichert diese Änderungen und verteilt die Änderungen dann an die Subscriber-Server.
3. Vorteile und Nachteile
(1) Schlechte Echtzeitfähigkeit der Daten: Daten werden nicht in Echtzeit auf den schreibgeschützten Server synchronisiert. Nachdem Daten auf den Primärserver geschrieben wurden, können sie erst nach der nächsten Synchronisierung abgefragt werden.
(2) Schlechte Synchronisierungseffizienz bei großen Datenmengen: Wenn die Datenmenge in einer einzelnen Tabelle zu groß ist, wird die Einfüge- und Aktualisierungsleistung aufgrund von Indizierung, Festplatten-I/O und anderen Problemen schlecht.
(3) Gleichzeitige Verbindung mit mehreren (mindestens zwei) Datenbanken: Es müssen mindestens zwei Datenbanken verbunden werden, und die tatsächlichen Lese-/Schreibvorgänge werden im Programmcode ausgeführt, was leicht zu Verwirrung führen kann.
(4) Lesevorgänge bieten hohe Leistung, hohe Zuverlässigkeit und Skalierbarkeit: Da der schreibgeschützte Server keine Schreiboperationen ausführt, reduziert dies Leistungsprobleme wie Festplatten-I/O erheblich und verbessert die Effizienz deutlich. Lastverteilung kann für schreibgeschützte Server verwendet werden; die primäre Datenbank veröffentlicht an mehrere schreibgeschützte Server, um die Skalierbarkeit von Lesevorgängen zu erreichen.
III. Datenbank-Sharding (Verteilt)
Basierend auf bestimmten Bedingungen werden Daten, die in derselben Datenbank gespeichert sind, auf mehrere Datenbanken verteilt, um eine verteilte Speicherung zu erreichen. Routing-Regeln werden verwendet, um zu einer bestimmten Datenbank zu routen. Auf diese Weise erfolgt jeder Zugriff nicht auf einen einzelnen Server, sondern auf N Server, wodurch der Lastdruck auf eine einzelne Maschine verringert wird.
Vertikales (longitudinales) Sharding: Bezieht sich auf Sharding nach funktionalen Modulen, zum Beispiel die Aufteilung in Bestell-Datenbank, Produkt-Datenbank, Benutzer-Datenbank usw. Bei diesem Ansatz unterscheiden sich die Tabellenstrukturen zwischen mehreren Datenbanken.
Horizontales (laterales) Sharding: Daten aus derselben Tabelle werden in Blöcke aufgeteilt und in verschiedenen Datenbanken gespeichert. Die Tabellenstrukturen in diesen Datenbanken sind exakt gleich.
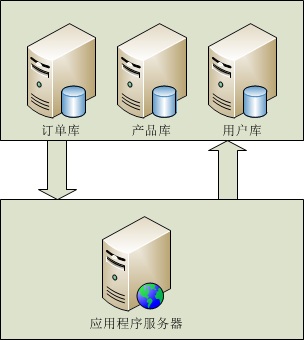
(Vertikales Sharding)
(Horizontales Sharding)
1. Implementierungsprinzip: Bei der Verwendung von vertikalem Sharding ist die Hauptüberlegung, ob der Anwendungstyp für diese Sharding-Methode geeignet ist. Wenn beispielsweise ein System in Geschäftssysteme mit klaren Grenzen aufgeteilt werden kann, wie ein Bestellsystem, ein Produktverwaltungssystem und ein Benutzerverwaltungssystem, kann vertikales Sharding den Datenbankdruck wirksam verteilen. Systeme mit unklaren Geschäftsmodulen und hoher Kopplung (Tabellenverknüpfungen) sind für diese Sharding-Methode nicht geeignet. Allerdings kann vertikales Sharding nicht alle Druckprobleme vollständig lösen. Wenn es beispielsweise eine Bestelltabelle mit 50 Millionen Zeilen gibt, ist der Druck auf die Bestelldatenbank während des Betriebs weiterhin hoch. Wenn wir eine neue Zeile in diese Tabelle einfügen müssen, wird die Datenbank nach Abschluss des Einfügens den Index für die Tabelle neu aufbauen. Der Systemaufwand für den Aufbau eines Index für 50 Millionen Zeilen kann nicht ignoriert werden. Umgekehrt, angenommen wir teilen diese Tabelle in 100 Tabellen auf, von table_001 bis table_100. Bei gleichmäßiger Verteilung von 50 Millionen Zeilen hätte jede Untertabelle nur 500.000 Zeilen. Zu diesem Zeitpunkt wird die Zeit für den Aufbau eines Index nach dem Einfügen von Daten in eine Tabelle mit nur 500.000 Zeilen um eine Größenordnung sinken, was die Laufzeiteffizienz der DB stark verbessert und die Parallelität der DB erhöht. Diese Art des Shardings ist horizontales Sharding.
2. Implementierungsmethoden: Vertikales Sharding ist relativ einfach zu implementieren; Sie müssen nur anhand von Tabellennamen auf verschiedene Datenbanken zugreifen. Es gibt viele Regeln für horizontales Sharding. Hier sind einige Punkte, die aus früherer Arbeit zusammengefasst wurden:
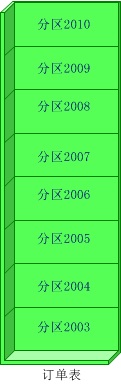
(1) Sequenzielles Sharding: Beispielsweise können Bestellungen nach Bestelldatum und Jahr aufgeteilt werden; Bestellungen aus 2003 gehen in db1, Bestellungen aus 2004 gehen in db2 und so weiter. Natürlich kann Sharding auch anhand von Primärschlüssel-Kriterien erfolgen.
Vorteile: Teilweise Migration ist möglich.
Nachteile: Ungleichmäßige Datenverteilung. Zum Beispiel könnten Bestellungen aus 2003 1 Million Zeilen haben, während Bestellungen aus 2008 5 Millionen Zeilen haben.
(2) Hash-Modulo-Sharding: Hashe user_id (oder, wenn user_id numerisch ist, verwende direkt den Wert von user_id) und wende dann eine bestimmte Zahl an. Wenn eine Anwendung beispielsweise eine Datenbank in vier Datenbanken aufteilen muss, verwenden wir die Zahl 4, um eine Modulo-Operation auf den Hash-Wert von user_id durchzuführen, also user_id % 4. Auf diese Weise gibt es für jede Operation vier mögliche Ergebnisse: Ergebnis 1 entspricht DB1; Ergebnis 2 entspricht DB2; Ergebnis 3 entspricht DB3; Ergebnis 0 entspricht DB4. Dadurch werden die Daten sehr gleichmäßig über die vier DBs verteilt.
Vorteile: Gleichmäßige Datenverteilung
Nachteile: Mühsame Datenmigration; Daten können nicht entsprechend der Maschinenleistung verteilt werden.
(3) Speichere die Datenbankkonfiguration in einer Authentifizierungsdatenbank.
Das heißt, erstelle eine DB, die separat die Zuordnung von user_id zu DB speichert. Bei jedem Zugriff auf eine Datenbank musst du zuerst diese Datenbank abfragen, um die konkrete DB-Information zu erhalten, und erst danach kannst du die erforderliche Abfrageoperation ausführen.
Vorteile: Hohe Flexibilität, Eins-zu-eins-Beziehung
Nachteile: Vor jeder Abfrage ist eine zusätzliche Abfrage erforderlich, was einen gewissen Leistungsverlust verursacht.
Quelle: http://www.codeceo.com/article/db-solutions.html