Avec l'adoption généralisée des applications Internet, le stockage et l'accès aux données massives sont devenus un goulot d'étranglement dans la conception des systèmes. Pour une application Internet à grande échelle, des millions, voire des centaines de millions de PV par jour imposent sans aucun doute une charge considérable à la base de données, ce qui pose d'importants problèmes pour la stabilité et l'évolutivité du système.
I.Équilibrage de chargeTechnologie
Un cluster d'équilibrage de charge est constitué d'un groupe de systèmes informatiques indépendants connectés via un réseau conventionnel ou dédié, reliés entre eux par des routeurs. Les nœuds coopèrent les uns avec les autres, partagent la charge et équilibrent la pression. Pour le client, l'ensemble du cluster peut être considéré comme un serveur unique et indépendant aux performances ultra-élevées.
1. Principe de mise en œuvre
Pour mettre en œuvre une technologie d'équilibrage de charge de base de données, vous avez d'abord besoin d'un contrôleur capable de contrôler les connexions à la base de données. Ici, il coupe la connexion directe entre la base de données et l'application ; tous les programmes accèdent à cette couche intermédiaire, et la couche intermédiaire accède ensuite à la base de données. De cette façon, nous pouvons contrôler spécifiquement quelle base de données est accédée, et également adopter des stratégies d'équilibrage efficaces en fonction de la charge actuelle de la base de données pour ajuster vers quelle base de données chaque connexion se dirige.
2. Mise en œuvre de la synchronisation des données multi-bases
Pour l'équilibrage de charge, le plus important est que les données sur tous les serveurs soient synchronisées en temps réel. C'est nécessaire pour un cluster, car si les données ne sont pas en temps réel ou ne sont pas synchronisées, les données qu'un utilisateur lit depuis un serveur différeront de celles lues depuis un autre serveur, ce qui est inacceptable. Par conséquent, la synchronisation des données de base de données doit être mise en œuvre. Ainsi, plusieurs ressources sont disponibles lors des requêtes, ce qui permet d'atteindre l'équilibre. Une méthode couramment utilisée est le cluster Moebius for SQL Server. Le cluster Moebius for SQL Server adopte une approche dans laquelle un programme principal réside dans la base de données de chaque machine. Ce programme principal, appelé intergiciel Moebius for SQL Server, surveille principalement les modifications des données de la base de données et synchronise les données modifiées vers les autres bases de données. Le client ne reçoit une réponse qu'après la fin de la synchronisation des données. Le processus de synchronisation est exécuté en parallèle, de sorte que le temps de synchronisation vers plusieurs bases de données est pratiquement le même que celui de synchronisation vers une seule base de données. De plus, la synchronisation est effectuée dans un environnement transactionnel, ce qui garantit la cohérence de plusieurs copies des données à tout moment. C'est précisément en raison de l'innovation consistant à héberger l'intergiciel Moebius dans la base de données que l'intergiciel connaît non seulement les modifications de données, mais aussi les instructions SQL qui ont provoqué ces modifications. En fonction du type d'instruction SQL, il adopte intelligemment différentes stratégies de synchronisation des données afin de minimiser le coût de la synchronisation des données.
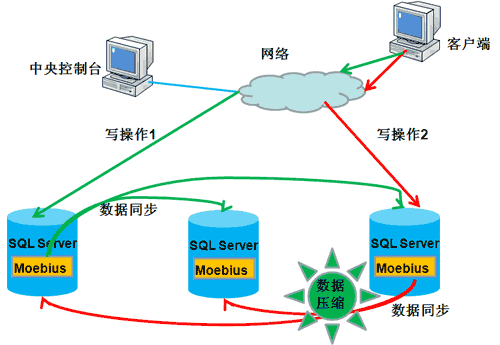
Si le nombre de lignes de données est faible et que le contenu des données n'est pas volumineux, synchronisez directement les données.
Si le nombre de lignes de données est faible mais que les données contiennent de grands types de données, tels que des données texte ou binaires, compressez d'abord les données, puis synchronisez-les, ce qui réduit l'utilisation de la bande passante réseau et le temps de transmission.
Si le nombre de lignes de données est important, le middleware obtient les instructions SQL qui ont provoqué les modifications de données, puis analyse les instructions SQL, analyse leurs plans d'exécution et leurs coûts d'exécution, et choisit s'il faut synchroniser les données ou synchroniser les instructions SQL vers d'autres bases de données. Cette situation est très utile lors de l'ajustement des structures de tables ou de la modification par lots des données.
3. Avantages et inconvénients
(1) Forte extensibilité : Lorsque le système exige une vitesse de traitement de base de données plus élevée, il peut être étendu en ajoutant simplement des serveurs de base de données.
(2) Maintenabilité : Lorsqu'un nœud tombe en panne, le système détecte automatiquement la panne et transfère les applications du nœud défaillant, assurant ainsi le fonctionnement continu de la base de données.
(3) Sécurité : Comme les données sont synchronisées sur plusieurs serveurs, la redondance de l'ensemble de données peut être obtenue, et la sécurité est assurée par plusieurs copies des données. En outre, il place avec succès la base de données sur le réseau interne, ce qui protège mieux la sécurité de la base de données.
(4) Facilité d'utilisation : Il est totalement transparent pour les applications ; le cluster n'expose qu'une seule IP.
(1) Il ne peut pas répartir la charge en fonction de la capacité de traitement des serveurs Web.
(2) Une défaillance du répartiteur de charge (contrôleur) peut paralyser l'ensemble du système de base de données.
II. Séparation lecture/écriture de la base de données
1. Principe de mise en œuvre : En termes simples, la séparation lecture/écriture sépare les opérations de lecture et d'écriture de la base de données sur différents serveurs de base de données, ce qui réduit efficacement la pression sur la base de données et réduit également la pression d'E/S. La base de données primaire gère les opérations d'écriture, et la base de données secondaire gère les opérations de lecture. En fait, dans de nombreux systèmes, les lectures sont les opérations principales. Lorsque la base de données primaire effectue des opérations d'écriture, les données doivent être synchronisées vers la base de données secondaire pour garantir efficacement l'intégrité des données.
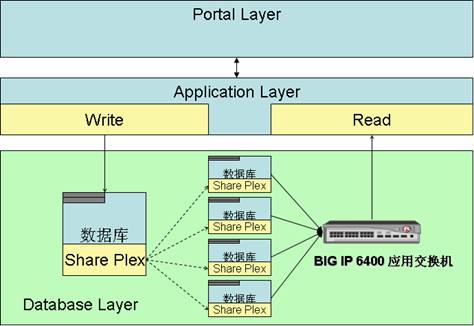
(Le rapport lecture/écriture d'eBay est de 260:1 ; eBay utilise la séparation lecture/écriture.)
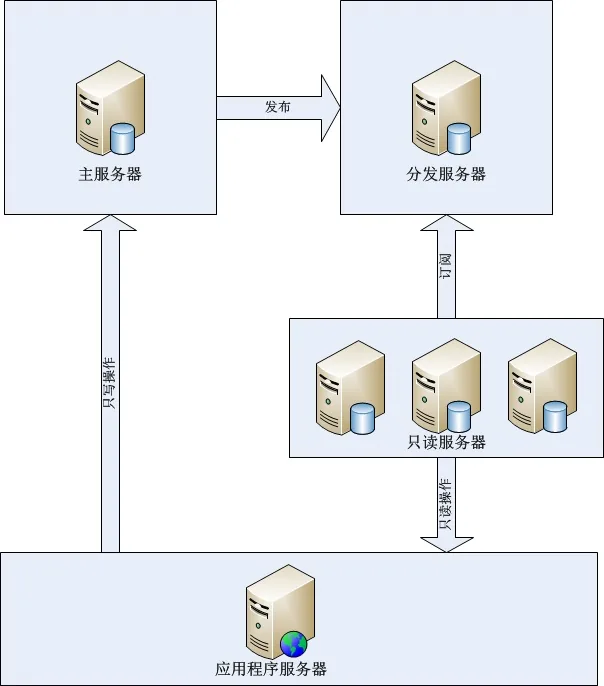
(Distribution de base de données Microsoft)
2. Méthode de mise en œuvre : dans MS SQL Server, la réplication de base de données peut être mise en œuvre en utilisant des définitions de publication, ce qui permet d’obtenir une séparation lecture-écriture. La réplication est une technologie qui copie un ensemble de données d’une source de données vers plusieurs sources de données, et constitue un moyen efficace de publier une copie des données sur plusieurs sites de stockage. Grâce à la technologie de réplication, les utilisateurs peuvent publier une copie des données sur plusieurs serveurs. La technologie de réplication garantit que les données situées à différents endroits sont automatiquement mises à jour et synchronisées, ce qui garantit la cohérence des données. La technologie de réplication SQL Server comporte trois types : la réplication d’instantané, la réplication transactionnelle et la réplication de fusion. SQL Server utilise principalement des publications et des abonnements pour gérer la réplication. Le serveur où résident les données source est le serveur de publication, qui est chargé de publier les données. Le serveur de publication copie toutes les modifications apportées aux données publiées vers le serveur de distribution. Le serveur de distribution contient une base de données de distribution, reçoit toutes les modifications de données, enregistre ces modifications, puis distribue les modifications aux serveurs d’abonnement.
3. Avantages et inconvénients
(1) Performances médiocres des données en temps réel : les données ne sont pas synchronisées en temps réel vers le serveur en lecture seule. Une fois les données écrites sur le serveur principal, elles ne peuvent être interrogées qu’après la synchronisation suivante.
(2) Efficacité de synchronisation médiocre avec de gros volumes de données : lorsque le volume de données d’une seule table est trop important, les performances d’insertion et de mise à jour deviennent médiocres en raison de l’indexation, des E/S disque et d’autres problèmes.
(3) Connexion simultanée à plusieurs (au moins deux) bases de données : au moins deux bases de données doivent être connectées, et les opérations réelles de lecture/écriture sont effectuées dans le code du programme, ce qui peut facilement prêter à confusion.
(4) Les lectures ont des performances élevées, une grande fiabilité et une bonne évolutivité : comme le serveur en lecture seule n’effectue aucune opération d’écriture, cela réduit considérablement les problèmes de performance tels que les E/S disque et améliore significativement l’efficacité. L’équilibrage de charge peut être utilisé pour les serveurs en lecture seule ; la base de données primaire publie vers plusieurs serveurs en lecture seule afin d’obtenir l’évolutivité des opérations de lecture.
III. Partitionnement de base de données (distribué)
En fonction de conditions spécifiques, les données stockées dans la même base de données sont réparties sur plusieurs bases de données afin d’obtenir un stockage distribué. Des règles de routage sont utilisées pour acheminer vers une base de données spécifique. Ainsi, chaque accès ne se fait pas vers un seul serveur mais vers N serveurs, ce qui réduit la pression de charge sur une seule machine.
Partitionnement vertical (longitudinal) : désigne le partitionnement par modules fonctionnels, par exemple la séparation en base de données des commandes, base de données des produits, base de données des utilisateurs, etc. Dans cette approche, les structures de tables diffèrent entre les multiples bases de données.
Partitionnement horizontal (latéral) : les données d’une même table sont divisées en blocs et stockées dans différentes bases de données. Les structures de tables dans ces bases de données sont exactement les mêmes.
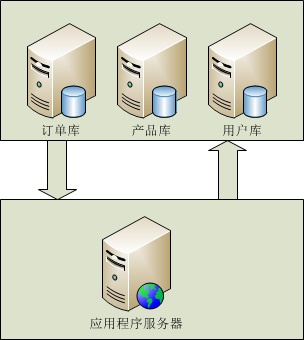
(Partitionnement vertical)
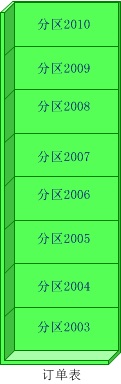
(Partitionnement horizontal)
1. Principe de mise en œuvre : lors de l'utilisation du partitionnement vertical, le principal critère est de savoir si le type d'application convient à cette méthode de partitionnement. Par exemple, si un système peut être divisé en systèmes métier aux frontières claires, tels qu'un système de commandes, un système de gestion de produits et un système de gestion des utilisateurs, le partitionnement vertical peut disperser efficacement la pression sur la base de données. Les systèmes dont les modules métier sont flous et fortement couplés (associations de tables) ne conviennent pas à cette méthode de partitionnement. Toutefois, le partitionnement vertical ne peut pas résoudre complètement tous les problèmes de pression. Par exemple, s'il existe une table de commandes de 50 millions de lignes, la pression sur la base de données des commandes reste élevée lors des opérations. Si nous devons insérer une nouvelle ligne dans cette table, après la fin de l'insertion, la base de données reconstruira l'index de la table. Le coût système de la construction d'un index pour 50 millions de lignes ne peut être ignoré. Inversement, supposons que nous divisions cette table en 100 tables, de table_001 à table_100. Avec 50 millions de lignes réparties uniformément, chaque sous-table n'aurait que 500,000 lignes. À ce stade, le temps de construction d'un index après l'insertion de données dans une table de seulement 500,000 lignes diminuera d'un ordre de grandeur, ce qui améliore grandement l'efficacité d'exécution de la BD et augmente sa concurrence. Ce type de partitionnement est le partitionnement horizontal.
2. Méthodes de mise en œuvre : le partitionnement vertical est relativement simple à mettre en œuvre ; il suffit d'accéder à différentes bases de données en fonction des noms de tables. Il existe de nombreuses règles pour le partitionnement horizontal. Voici quelques points résumés de travaux précédents :
(1) Partitionnement séquentiel : par exemple, les commandes peuvent être réparties par date de commande et par année ; les commandes de 2003 vont dans db1, les commandes de 2004 vont dans db2, et ainsi de suite. Bien sûr, le partitionnement peut également être basé sur des critères de clé primaire.
Avantages : la migration partielle est possible.
Inconvénients : répartition inégale des données. Par exemple, les commandes de 2003 peuvent comporter 1 million de lignes, tandis que les commandes de 2008 peuvent en comporter 5 millions.
(2) Sharding par modulo de hachage : hachez user_id (ou, si user_id est numérique, utilisez directement la valeur de user_id), puis utilisez un nombre spécifique. Par exemple, si une application doit diviser une base de données en quatre bases de données, nous utilisons le nombre 4 pour effectuer une opération de modulo sur la valeur de hachage de user_id, c'est-à-dire user_id % 4. De cette façon, chaque opération a quatre résultats possibles : le résultat 1 correspond à DB1 ; le résultat 2 correspond à DB2 ; le résultat 3 correspond à DB3 ; le résultat 0 correspond à DB4. Cela répartit les données de manière très uniforme sur les quatre bases de données.
Avantages : répartition uniforme des données
Inconvénients : migration des données fastidieuse ; impossible de répartir les données en fonction des performances de la machine.
(3) Enregistrer la configuration de la base de données dans une base de données d'authentification.
C'est-à-dire créer une base de données qui stocke individuellement la correspondance de user_id vers DB. Chaque fois que vous accédez à une base de données, vous devez d'abord interroger cette base de données pour obtenir les informations spécifiques sur la DB, et seulement ensuite pouvez-vous effectuer l'opération de requête nécessaire.
Avantages : grande flexibilité, relation un-à-un
Inconvénients : une requête supplémentaire est nécessaire avant chaque requête, ce qui entraîne une certaine perte de performance.
Source : http://www.codeceo.com/article/db-solutions.html