С широким распространением интернет-приложений хранение огромных объёмов данных и доступ к ним стали узким местом при проектировании систем. Для крупномасштабного интернет-приложения миллионы или даже сотни миллионов PV в день, несомненно, создают значительную нагрузку на базу данных, что вызывает серьёзные проблемы для стабильности и масштабируемости системы.
I.Балансировка нагрузкиТехнология
Кластер балансировки нагрузки состоит из группы независимых компьютерных систем, соединённых через обычную или выделенную сеть и связанных друг с другом маршрутизаторами. Узлы взаимодействуют друг с другом, разделяют нагрузку и балансируют давление. Для клиента весь кластер можно рассматривать как единый независимый сервер со сверхвысокой производительностью.
1. Принцип реализации
Чтобы реализовать технологию балансировки нагрузки базы данных, сначала нужен контроллер, который может управлять подключениями к базе данных. Здесь он разрывает прямое соединение между базой данных и приложением; все программы обращаются к этому промежуточному слою, а промежуточный слой затем обращается к базе данных. Таким образом, мы можем целенаправленно управлять тем, к какой базе данных происходит обращение, а также применять эффективные стратегии балансировки на основе текущей нагрузки базы данных, чтобы регулировать, к какой базе данных идёт каждое подключение.
2. Реализация синхронизации данных между несколькими базами данных
Для балансировки нагрузки самое важное — чтобы данные на всех серверах синхронизировались в реальном времени. Это необходимо для кластера, поскольку если данные не в реальном времени или не синхронизированы, данные, которые пользователь читает с одного сервера, будут отличаться от данных, читаемых с другого сервера, что недопустимо. Поэтому необходимо реализовать синхронизацию данных баз данных. Таким образом, при запросах доступно несколько ресурсов, что обеспечивает балансировку. Обычно используемый метод — кластер Moebius for SQL Server. Кластер Moebius for SQL Server использует подход, при котором основная программа размещается в базе данных на каждой машине. Эта основная программа, называемая промежуточным ПО Moebius for SQL Server, в основном отслеживает изменения данных в базе данных и синхронизирует изменённые данные с другими базами данных. Клиент получает ответ только после завершения синхронизации данных. Процесс синхронизации выполняется параллельно, поэтому время синхронизации с несколькими базами данных в основном такое же, как синхронизация с одной базой данных. Кроме того, синхронизация выполняется в транзакционной среде, что обеспечивает согласованность нескольких копий данных в любой момент. Именно благодаря инновации — размещению промежуточного ПО Moebius в базе данных — это ПО не только знает об изменениях данных, но и знает SQL-инструкции, вызвавшие изменения. В зависимости от типа SQL-инструкции оно интеллектуально применяет различные стратегии синхронизации данных, чтобы минимизировать затраты на синхронизацию данных.
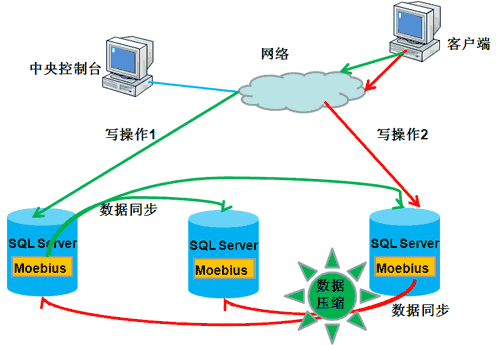
Если количество строк данных невелико и объём данных небольшой, синхронизируйте данные напрямую.
Если количество строк данных невелико, но включает крупные типы данных, например текстовые или бинарные данные, сначала сожмите данные, а затем синхронизируйте их, тем самым уменьшая использование пропускной способности сети и время передачи.
Если число строк данных велико, промежуточное ПО получает SQL-инструкции, вызвавшие изменения данных, затем разбирает SQL-инструкции, анализирует их планы выполнения и затраты на выполнение и выбирает, синхронизировать данные или синхронизировать SQL-инструкции с другими базами данных. Эта ситуация очень полезна при корректировке структур таблиц или массовом изменении данных.
3. Преимущества и недостатки
(1) Высокая масштабируемость: когда системе требуется более высокая скорость обработки базы данных, её можно расширить, просто добавив серверы баз данных.
(2) Обслуживаемость: при отказе узла система автоматически обнаруживает неисправность и переносит приложения отказавшего узла, обеспечивая непрерывную работу базы данных.
(3) Безопасность: поскольку данные синхронизируются с несколькими серверами, можно достичь избыточности набора данных, а безопасность обеспечивается за счёт нескольких копий данных. Кроме того, это успешно размещает базу данных во внутренней сети, лучше защищая безопасность базы данных.
(4) Простота использования: она полностью прозрачна для приложений; кластер предоставляет только один IP.
(1) Он не может распределять нагрузку в соответствии с вычислительной мощностью Web-серверов.
(2) Отказ балансировщика нагрузки (контроллера) может привести к параличу всей системы баз данных.
II. Разделение чтения/записи базы данных
1. Принцип реализации: проще говоря, разделение чтения/записи разделяет операции чтения и записи базы данных на разные серверы баз данных, что эффективно снижает нагрузку на базу данных, а также снижает нагрузку ввода-вывода. Основная база данных обрабатывает операции записи, а вторичная база данных обрабатывает операции чтения. Фактически, во многих системах чтение является основной операцией. Когда основная база данных выполняет операции записи, данные должны синхронизироваться со вторичной базой данных, чтобы эффективно обеспечить целостность данных.
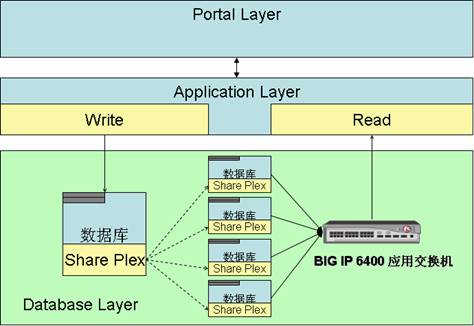
(Соотношение чтения и записи в eBay составляет 260:1; eBay использует разделение чтения/записи.)
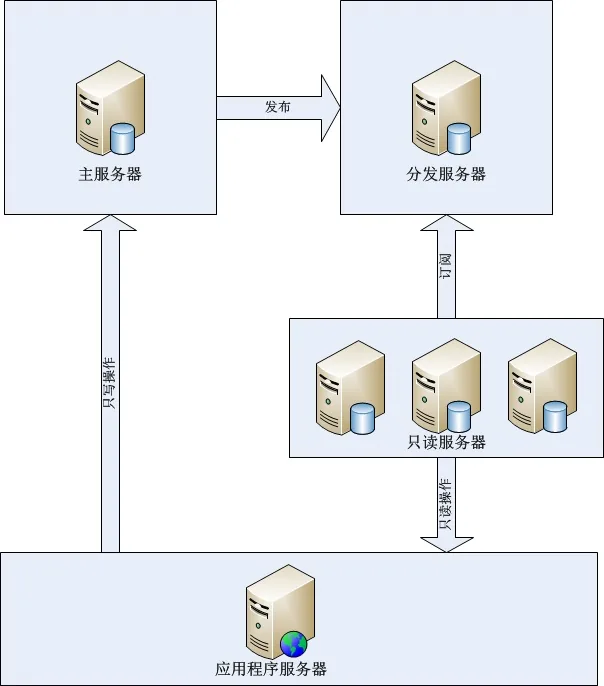
(Распределение баз данных Microsoft)
2. Способ реализации: в MS SQL Server репликацию базы данных можно реализовать с помощью определений публикаций, тем самым обеспечив разделение чтения и записи. Репликация — это технология, которая копирует набор данных из одного источника данных в несколько источников данных и является эффективным способом публикации одной копии данных на нескольких узлах хранения. Используя технологию репликации, пользователи могут опубликовать одну копию данных на нескольких серверах. Технология репликации гарантирует, что данные, расположенные в разных местах, автоматически обновляются и синхронизируются, таким образом обеспечивая согласованность данных. В технологии репликации SQL Server есть три типа: репликация моментальных снимков, транзакционная репликация и репликация слиянием. В SQL Server в основном используются публикации и подписки для обработки репликации. Сервер, на котором находятся исходные данные, является сервером-издателем, который отвечает за публикацию данных. Сервер-издатель копирует все изменения опубликованных данных на сервер-распространитель. Сервер-распространитель содержит базу данных распространителя, получает все изменения данных, сохраняет эти изменения, а затем распространяет изменения на серверы-подписчики.
3. Преимущества и недостатки
(1) Низкая оперативность данных в реальном времени: данные не синхронизируются с сервером только для чтения в реальном времени. После записи данных на основной сервер их можно запросить только после следующей синхронизации.
(2) Низкая эффективность синхронизации при больших объёмах данных: когда объём данных в одной таблице слишком велик, производительность вставки и обновления снижается из-за индексации, дискового ввода-вывода и других проблем.
(3) Одновременное подключение к нескольким (как минимум двум) базам данных: необходимо подключиться как минимум к двум базам данных, а фактические операции чтения/записи выполняются в программном коде, что легко может вызвать путаницу.
(4) Операции чтения обладают высокой производительностью, высокой надежностью и масштабируемостью: поскольку на сервере только для чтения отсутствуют операции записи, это значительно снижает такие проблемы производительности, как дисковый ввод-вывод, и существенно повышает эффективность. Для серверов только для чтения можно использовать балансировку нагрузки; первичная база данных публикует данные на несколько серверов только для чтения, чтобы обеспечить масштабируемость операций чтения.
III. Шардирование базы данных (распределенное)
На основе определенных условий данные, хранящиеся в одной базе данных, распределяются по нескольким базам данных для достижения распределенного хранения. Правила маршрутизации используются для маршрутизации к конкретной базе данных. Таким образом, каждое обращение происходит не к одному серверу, а к N серверам, что снижает нагрузку на одну машину.
Вертикальное (продольное) шардирование: означает шардирование по функциональным модулям, например разделение на базу данных заказов, базу данных товаров, базу данных пользователей и т. д. При таком подходе структуры таблиц различаются между несколькими базами данных.
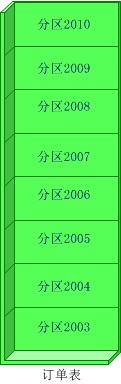
Горизонтальное (поперечное) шардирование: данные одной и той же таблицы разбиваются на блоки и хранятся в разных базах данных. Структуры таблиц в этих базах данных абсолютно одинаковы.
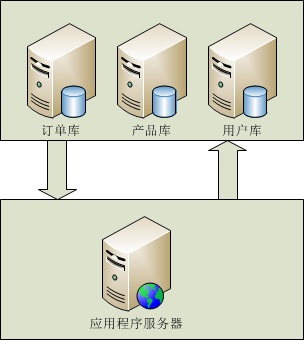
(Вертикальное шардирование)
(Горизонтальное шардирование)
1. Принцип реализации: при использовании вертикального шардирования главное — определить, подходит ли тип приложения для этого способа шардирования. Например, если систему можно разделить на бизнес-системы с четкими границами, такие как система заказов, система управления товарами и система управления пользователями, вертикальное шардирование может эффективно распределить нагрузку на базу данных. Системы с нечеткими бизнес-модулями и высокой связностью (ассоциациями таблиц) не подходят для этого способа шардирования. Однако вертикальное шардирование не может полностью решить все проблемы с нагрузкой. Например, если есть таблица заказов с 50 миллионами строк, нагрузка на базу данных заказов во время операций все еще остается высокой. Если нам нужно вставить новую строку в эту таблицу, после завершения вставки база данных перестроит индекс для таблицы. Системные накладные расходы на построение индекса для 50 миллионов строк нельзя игнорировать. И наоборот, предположим, мы разделим эту таблицу на 100 таблиц, от table_001 до table_100. Если 50 миллионов строк распределить равномерно, в каждой подтаблице будет только 500 000 строк. В этот момент время на построение индекса после вставки данных в таблицу всего с 500 000 строк уменьшится на порядок, что значительно повысит эффективность работы БД во время выполнения и увеличит конкурентность БД. Такой вид шардирования — это горизонтальное шардирование.
2. Способы реализации: вертикальное шардирование реализуется относительно просто; нужно лишь обращаться к разным базам данных в зависимости от имен таблиц. Для горизонтального шардирования существует много правил. Вот несколько моментов, обобщенных по опыту предыдущей работы:
(1) Последовательное шардирование: например, заказы можно разделять по дате заказа и году; заказы за 2003 год попадают в db1, заказы за 2004 год — в db2, и так далее. Конечно, шардирование также может выполняться по критериям первичного ключа.
Преимущества: возможна частичная миграция.
Недостатки: неравномерное распределение данных. Например, заказы за 2003 год могут содержать 1 миллион строк, а заказы за 2008 год — 5 миллионов строк.
(2) Шардинг по модулю хеша: хешируйте user_id (или, если user_id числовой, напрямую используйте значение user_id), затем используйте определённое число. Например, если приложению нужно разделить одну базу данных на четыре базы данных, мы используем число 4 для операции взятия по модулю от хеш-значения user_id, то есть user_id % 4. Таким образом, каждая операция имеет четыре возможных результата: результат 1 соответствует DB1; результат 2 соответствует DB2; результат 3 соответствует DB3; результат 0 соответствует DB4. Это позволяет очень равномерно распределить данные по четырём БД.
Преимущества: равномерное распределение данных
Недостатки: сложная миграция данных; невозможно распределять данные в соответствии с производительностью машин.
(3) Сохраните конфигурацию базы данных в базе данных аутентификации.
То есть создайте БД, которая отдельно хранит сопоставление user_id с БД. Каждый раз при доступе к базе данных необходимо сначала выполнить запрос к этой базе данных, чтобы получить информацию о конкретной БД, и только затем можно выполнить требуемую операцию запроса.
Преимущества: высокая гибкость, отношение «один к одному»
Недостатки: перед каждым запросом требуется дополнительный запрос, что приводит к определённой потере производительности.
Источник: http://www.codeceo.com/article/db-solutions.html