Inhaltsverzeichnis
- Ziel dieses Artikels
- So verwendest du dieses Tutorial
- Was genau ist ein regulärer Ausdruck?
- Erste Schritte
- Reguläre Ausdrücke testen
- Metazeichen
- Zeichen-Escapes
- Wiederholung
- Zeichenklassen
- Verzweigungsbedingungen
- Negation
- Gruppierung
- Rückverweise
- Zero-Width-Assertions
- Negative Zero-Width-Assertions
- Kommentare
- Greedy und Lazy
- Verarbeitungsoptionen
- Balancierte Gruppen / Rekursives Matching
- Was sonst noch nicht erwähnt wurde
Ziel dieses Artikels
In 30 Minuten verstehen Sie, was ein regulärer Ausdruck ist, und gewinnen ein grundlegendes Verständnis davon, sodass Sie ihn in Ihren eigenen Programmen oder Webseiten verwenden können.
So verwendest du dieses Tutorial
Lassen Sie sich von den komplexen Ausdrücken unten nicht einschüchtern. Folgen Sie mir einfach Schritt für Schritt, und Sie werden feststellen, dass reguläre Ausdrücke tatsächlich nicht so schwierig sind, wie man sich vorstellt. Natürlich ist es auch normal, wenn Sie nach dem Lesen dieses Tutorials feststellen, dass Sie zwar viel verstehen, sich aber kaum etwas merken können — ich denke, dass für jemanden, der noch nie mit regulären Ausdrücken in Berührung gekommen ist, die Wahrscheinlichkeit, sich nach dem Lesen dieses Tutorials an mehr als 80% der erwähnten Syntax zu erinnern, gleich null ist. Dies dient nur dazu, Ihnen die grundlegenden Prinzipien verständlich zu machen. Später müssen Sie mehr üben und häufiger anwenden, um reguläre Ausdrücke zu beherrschen.
Neben einem Einsteiger-Tutorial versucht dieser Artikel auch, ein Nachschlagewerk für die Syntax regulärer Ausdrücke zu werden, das im täglichen Arbeitsalltag verwendet werden kann. Nach der eigenen Erfahrung des Autors wurde dieses Ziel recht gut erreicht — sehen Sie, ich selbst habe mir nicht alles merken können, nicht wahr?
Was genau ist ein regulärer Ausdruck?
Beim Schreiben von Programmen oder Webseiten, die Zeichenketten verarbeiten, besteht oft die Notwendigkeit, Zeichenketten zu finden, die bestimmten komplexen Regeln entsprechen.Regulärer Ausdruckist ein Werkzeug, das verwendet wird, um diese Regeln zu beschreiben. Mit anderen Worten: Ein regulärer Ausdruck ist Code, der Textregeln aufzeichnet.
Sie haben wahrscheinlich schon die unter Windows/DOS zur Dateisuche verwendete Funktion verwendet:Wildcard, das heißt,*und?. Wenn Sie alle Word-Dokumente in einem Verzeichnis finden möchten, würden Sie suchen*.doc. Hier*würde als beliebige Zeichenkette interpretiert. Ähnlich wie Wildcards sind reguläre Ausdrücke ebenfalls Werkzeuge für den Textabgleich, außer dass sie im Vergleich zu Wildcards Ihre Anforderungen präziser beschreiben können – natürlich auf Kosten größerer Komplexität – zum Beispiel können Sie einen regulären Ausdruck schreiben, um zu findenalle Zeichenketten, die mit 0 beginnen, gefolgt von 2-3 Ziffern, dann einem Bindestrich "-", und schließlich 7 oder 8 Ziffern.(wie010-12345678oder0376-7654321).
Hinweis: Ein Zeichenist die grundlegendste Einheit, wenn Computersoftware Text verarbeitet. Es kann ein Buchstabe, eine Ziffer, ein Satzzeichen, ein Leerzeichen, ein Zeilenumbruchzeichen, ein chinesisches Schriftzeichen usw. sein.Zeichenketteist eine Folge von null oder mehr Zeichen.Textist auch Wörter, Zeichenketten. Zu sagen, dass eine Zeichenketteeinem bestimmten regulären Ausdruck entspricht, bedeutet normalerweise, dass ein Teil (oder mehrere Teile getrennt) dieser Zeichenkette die Bedingungen erfüllen kann, die durch den Ausdruck gegeben sind.
Erste Schritte
Der beste Weg, reguläre Ausdrücke zu lernen, ist, mit Beispielen zu beginnen. Nachdem Sie Beispiele verstanden haben, ändern Sie sie und experimentieren Sie selbst damit. Viele einfache Beispiele werden unten mit ausführlichen Erklärungen gegeben.
Angenommen, Sie suchen nachhiin einem englischen Roman, dann können Sie den regulären Ausdruckhi verwenden。
Dies ist fast der einfachste reguläre Ausdruck. Er kann genau eine Zeichenkette wie diese treffen:bestehend aus zwei Zeichen: Das erste Zeichen ist h, und das zweite ist i.. Normalerweise bieten Werkzeuge, die reguläre Ausdrücke verarbeiten, eine Option zum Ignorieren der Groß-/Kleinschreibung. Wenn diese Option ausgewählt ist, kann er übereinstimmen mithi,HI,Hi,hIjeden dieser vier Fälle.
Leider enthalten viele Wörterhidiese beiden aufeinanderfolgenden Zeichen, wie etwahim,history,highusw. Wenn man mithisucht, wird dashidarin ebenfalls gefunden. Wenn dugenau das Wort "hi" finden möchtest, sollten wir\bhi\b verwenden。
\bist ein spezieller Code, der durch reguläre Ausdrücke definiert wird (nun, manche Leute nennen ihnMetazeichen), und steht fürden Anfang oder das Ende eines Wortes, also die Wortgrenze.. Obwohl englische Wörter normalerweise durch Leerzeichen, Satzzeichen oder Zeilenumbrüche getrennt werden,\bpasst auf keines dieser worttrennenden Zeichen; espasst nur auf eine Position.。
Hinweis: Wenn du eine genauere Formulierung brauchst,\bpasst auf eine Position, sodass sein vorhergehendes Zeichen und sein nachfolgendes Zeichen nicht beide Wortzeichen sind (eines ist, eines ist nicht, oder eines existiert nicht).\w。
Wenn das, was du finden möchtest,"hi" ist, nicht weit dahinter, gefolgt von "Lucy", solltest du\bhi\b.*\bLucy\b verwenden。
Hier ist.ein weiteres Metazeichen, das aufjedes Zeichen außer Zeilenumbruchzeichen passt.。*ist ebenfalls ein Metazeichen, aber es repräsentiert weder ein Zeichen noch eine Position; vielmehr repräsentiert es eine Quantität — es legt fest, dass *der Inhalt davor kann beliebig oft wiederholt werden, damit der gesamte Ausdruck passt.. Daher,.*wenn sie zusammen verbunden werden, bedeutet daseine beliebige Anzahl von Zeichen, die keine Zeilenumbrüche enthalten.. Nun ist\bhi\b.*\bLucy\bdie Bedeutung ganz offensichtlich:Zuerst kommt das Wort "hi", dann eine beliebige Anzahl beliebiger Zeichen (aber keine Zeilenumbrüche), und schließlich das Wort "Lucy".。
Hinweis: Das Zeilenumbruchzeichen ist '\n', das Zeichen mit ASCII-Code 10 (hexadezimal 0x0A).
Wenn wir andere Metazeichen zusammen verwenden, können wir leistungsfähigere reguläre Ausdrücke konstruieren. Zum Beispiel das folgende Beispiel:
0\d\d-\d\d\d\d\d\d\d\dFinde eine Zeichenkette wie diese:die mit 0 beginnt, dann zwei Ziffern, dann einem Bindestrich "-", und schließlich 8 Ziffern.(Dies ist eine chinesische Telefonnummer. Natürlich kann dieses Beispiel nur den Fall abgleichen, in dem die Vorwahl 3 Ziffern hat).
Hier,\dist ein neues Metazeichen, das miteiner einzelnen Ziffer (0 oder 1 oder 2 oder ...) übereinstimmt.。-ist kein Metazeichen; es stimmt nur mit sich selbst überein — dem Bindestrich (oder Minuszeichen, oder Gedankenstrich, oder wie auch immer man es nennt).
Um so viel lästige Wiederholung zu vermeiden, können wir diesen Ausdruck auch so schreiben:0\d{2}-\d{8}. Hier bedeutet\dnach dem{2}({8}), dass das vorangehende\dmuss fortlaufend wiederholt und 2 Mal (8 Mal) abgeglichen werden.。
Reguläre Ausdrücke testen
Wenn du reguläre Ausdrücke nicht schwer zu lesen und zu schreiben findest, dann bist du entweder ein Genie oder nicht von dieser Erde. Die Syntax regulärer Ausdrücke ist ein Kopfzerbrechen, selbst für diejenigen, die sie häufig verwenden. Weil sie schwer zu lesen und zu schreiben und fehleranfällig sind, ist es notwendig, ein Werkzeug zum Testen regulärer Ausdrücke zu finden.
Einige Details regulärer Ausdrücke unterscheiden sich in verschiedenen Umgebungen. Hier sind zwei verfügbare Testwerkzeuge:
- RegexBuddy
- JavaScript-Tool zum Online-Testen regulärer Ausdrücke
Metazeichen
Jetzt kennst du bereits mehrere sehr nützliche Metazeichen, wie zum Beispiel\b,.,*, und\d. Es gibt weitere Metazeichen in regulären Ausdrücken, zum Beispiel\sstimmt mitjedem Leerraumzeichen überein, einschließlich Leerzeichen, Tabs (Tab), Zeilenumbrüchen, chinesischen Vollbreiten-Leerzeichen usw.。\wstimmt mitBuchstaben, Ziffern, Unterstrichen oder chinesischen Zeichen usw. überein.。
Hinweis: Die spezielle Behandlung chinesischer Zeichen/Schriftzeichen wird von der von .NET bereitgestellten Engine für reguläre Ausdrücke unterstützt. Für spezifische Situationen in anderen Umgebungen ziehen Sie bitte die relevante Dokumentation zu Rate.
Schauen wir uns unten weitere Beispiele an:
\ba\w*\bfindetWörter, die mit dem Buchstabenabeginnen – zuerst am Wortanfang (\b), dann der Buchstabea, dann beliebig viele Buchstaben oder Ziffern (\w*) und schließlich das Ende des Wortes (\b)。
Hinweis: Nun, sprechen wir darüber, was ein Wort in regulären Ausdrücken bedeutet: Es handelt sich um ein oder mehrere aufeinanderfolgende\w. Tatsächlich hat das wirklich wenig mit den Tausenden gleichnamigen Dingen zu tun, die Sie beim Englischlernen auswendig lernen mussten :)
\d+entspricht1 oder mehr aufeinanderfolgenden Ziffern. Hier+ist ein Metazeichen ähnlich wie*, der Unterschied besteht darin, dass*entsprichtbeliebig oft wiederholt (möglicherweise null Mal), während+mitübereinstimmt, ein oder mehrere Male wiederholt。
\b\w{6}\bentsprichteinem Wort mit genau 6 Zeichen。
| Code | Beschreibung |
|---|---|
| . | Entspricht jedem Zeichen außer einem Zeilenumbruch |
| \w | Entspricht einem Buchstaben, einer Ziffer, einem Unterstrich oder einem chinesischen Zeichen |
| \s | Entspricht jedem Whitespace-Zeichen |
| \d | Entspricht einer Ziffer |
| \b | Entspricht dem Anfang oder Ende eines Wortes |
| ^ | Entspricht dem Anfang einer Zeichenfolge |
| $ | Entspricht dem Ende einer Zeichenfolge |
Hinweis: Regex-Engines bieten normalerweise eine Methode, um zu "testen, ob eine angegebene Zeichenkette mit einem regulären Ausdruck übereinstimmt", wie RegExp.test() in JavaScript oder Regex.IsMatch() in .NET. Übereinstimmen bedeutet hier, ob es einen Teil der Zeichenkette gibt, der den Regeln des Ausdrucks entspricht. Wenn Sie nicht^und$, dann garantiert für\d{5,12}die Verwendung einer solchen Methode nur, dass die Zeichenkette5 bis 12 aufeinanderfolgende Ziffern enthält, anstatt dass die gesamte Zeichenkette 5 bis 12 Ziffern ist.
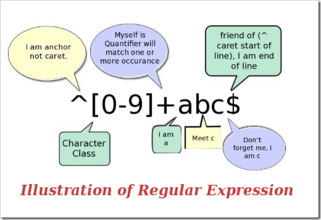
Das Metazeichen^(das Symbol auf derselben Taste wie die Zahl 6) und$stimmen beide mit einer Position überein, was\betwas ähnlich ist wie^Entspricht dem Anfang der Zeichenkette, die Sie suchen,$entspricht dem Ende. Diese beiden Codes sind sehr nützlich bei der Validierung von Eingaben; zum Beispiel, wenn eine Website verlangt, dass die von Ihnen eingegebene QQ-Nummer 5 bis 12 Ziffern lang ist, können Sie Folgendes verwenden:^\d{5,12}$。
Dieses{5,12}und das zuvor eingeführte{2}sind ähnlich, außer dass{2}mitgenau 2 Mal wiederholt übereinstimmt,{5,12}wohingegendie Anzahl der Wiederholungen muss mindestens 5 und höchstens 12 betragen, andernfalls stimmt es nicht überein.
Aufgrund der Verwendung von^und$muss die gesamte Eingabezeichenfolge\d{5,12}verwendet werden, um abzugleichen, das heißt, die gesamte Eingabemuss aus 5 bis 12 Ziffernbestehen, wenn also die eingegebene QQ-Nummer mit diesem Regex übereinstimmt, erfüllt sie die Anforderung.
Ähnlich wie bei der Option zum Ignorieren der Groß-/Kleinschreibung haben einige Regex-Verarbeitungswerkzeuge auch eine Mehrzeilenoption. Wenn diese Option ausgewählt ist, haben^und$die Bedeutung von, den Anfang und das Ende einer Zeile zu treffen。
Zeichen-Escapes
Wenn du nach einem Metazeichen selbst suchen möchtest, zum Beispiel nach.oder*, gibt es ein Problem: Du kannst sie nicht angeben, weil sie als etwas anderes interpretiert werden. Dann musst du verwenden\um die Sonderbedeutung dieser Zeichen aufzuheben. Daher sollten Sie\.und\*verwenden. Natürlich müssen Sie, um nach\selbst zu suchen, ebenfalls verwenden\\.
Zum Beispiel:deerchao\.netentsprichtdeerchao.net,C:\\WindowsentsprichtC:\Windows。
Wiederholung
Sie haben bereits die*,+,{2},{5,12}früheren Arten zum Abgleichen von Wiederholungen gesehen. Nachfolgend sind alle Quantifizierer in Regex aufgeführt (Codes, die die Quantität angeben, wie *, {5,12} usw.):
| Code/Syntax | Beschreibung |
|---|---|
| * | Null oder mehr Wiederholungen |
| + | Eine oder mehr Wiederholungen |
| ? | Null oder eine Wiederholung |
| {n} | Genau n-mal wiederholen |
| {n,} | n oder mehr Male wiederholen |
| {n,m} | Zwischen n und m Mal wiederholen |
Hier sind einige Beispiele für Wiederholungen:
Windows\d+entsprichtWindows gefolgt von einer oder mehreren Ziffern
^\w+entsprichtdem ersten Wort einer Zeile (oder dem ersten Wort der gesamten Zeichenkette; welche Bedeutung gilt, hängt von den Optionseinstellungen ab)
Zeichenklassen
Das Suchen nach Ziffern, Buchstaben oder Ziffern und Leerraum ist einfach, weil es bereits Metazeichen für diese Zeichensätze gibt, aber was sollten Sie tun, wenn Sie einen Zeichensatz ohne ein vordefiniertes Metazeichen abgleichen möchten (wie die Vokalbuchstaben a, e, i, o, u)?
Ganz einfach: Sie listen sie einfach in eckigen Klammern auf, wie[aeiou]entsprichteinem beliebigen der englischen Vokalbuchstaben,[.?!]entsprichteinem Satzzeichen (. oder ? oder !)。
Wir können auch leicht einen Zeichenbereich angeben, wie, like[0-9]die Bedeutung, die durch\ddargestellt wird, genau dieselbe ist:eine Ziffer; ähnlich[a-z0-9A-Z_]ist auch völlig äquivalent zu\w(wenn man nur Englisch betrachtet).
Hier ist ein komplexerer Ausdruck:\(?0\d{2}[) -]?\d{8}。
Hinweis: "(" und ")" sind ebenfalls Metazeichen; im späterenAbschnitt zur Gruppierungwird dies erwähnt, deshalb musst du hierEscaping verwenden。
Dieser Ausdruck kannmehrere Formate von Telefonnummernabgleichen, wie zum Beispiel(010)88886666, oder022-22334455, oder02912345678, usw. Analysieren wir ihn: Zuerst kommt ein maskiertes Zeichen\(, das 0- oder 1-mal vorkommen kann (?), dann ein0, gefolgt von 2 Ziffern (\d{2}), dann eines von)oder-oderLeerzeichen, das 1-mal oder gar nicht vorkommt (?), und schließlich 8 Ziffern (\d{8}).
Verzweigungsbedingungen
Leider kann der vorherige Ausdruck auch010)12345678oder(022-87654321solch ein "inkorrektes" Format abgleichen. Um dieses Problem zu lösen, müssen wirVerzweigungsbedingungen verwenden. Verzweigungsbedingungen in RegexVerzweigungsbedingungenbedeuten, dass es mehrere Regeln gibt, und wenn eine davon erfüllt ist, sollte dies als Übereinstimmung gelten. Die konkrete Methode ist,|zu verwenden, um die verschiedenen Regeln zu trennen. Verstehst du nicht? Egal, sieh dir das Beispiel an:
0\d{2}-\d{8}|0\d{3}-\d{7}Dieser Ausdruck kannzwei Arten von durch Bindestrich getrennten Telefonnummern abgleichen: Eine ist eine 3-stellige Vorwahl mit einer 8-stelligen Ortsnummer (wie 010-12345678), und eine ist eine 4-stellige Vorwahl mit einer 7-stelligen Ortsnummer (0376-2233445)。
\(?0\d{2}\)?[- ]?\d{8}|0\d{2}[- ]?\d{8}Dieser Ausdruckgleicht Telefonnummern mit einer 3-stelligen Vorwahl ab, wobei die Vorwahl in Klammern eingeschlossen sein kann oder nicht, und die Vorwahl und die Ortsnummer durch einen Bindestrich oder ein Leerzeichen getrennt sein können oder gar kein Trennzeichen haben. Du kannst versuchen, diesen Ausdruck zu erweitern, um mithilfe von Verzweigungsbedingungen auch 4-stellige Vorwahlen zu unterstützen.
\d{5}-\d{4}|\d{5}Dieser Ausdruck wird verwendet, um US-Postleitzahlen abzugleichen. Die Regel für US-ZIP-Codes lautet 5 Ziffern oder 9 Ziffern, die durch einen Bindestrich getrennt sind. Der Grund für dieses Beispiel ist, dass es ein Problem veranschaulicht:Bei der Verwendung von Verzweigungsbedingungen ist auf die Reihenfolge der Bedingungen zu achten. Wenn Sie es zu\d{5}|\d{5}-\d{4}ändern, dann wird es nur 5-stellige Postleitzahlen abgleichen (und die ersten 5 Ziffern von 9-stelligen Postleitzahlen). Der Grund dafür ist, dass beim Abgleichen von Verzweigungsbedingungen jede Bedingung von links nach rechts geprüft wird; wenn ein Zweig erfüllt ist, werden die anderen Bedingungen nicht berücksichtigt.
Gruppierung
Wir haben bereits erwähnt, wie man ein einzelnes Zeichen wiederholt (fügen Sie einfach einen Quantifizierer direkt nach dem Zeichen hinzu); aber was sollten Sie tun, wenn Sie mehrere Zeichen wiederholen möchten? Sie können Klammern verwenden, umeinen Teilausdruck anzugeben(aucheine Gruppe genannt), und dann können Sie die Anzahl der Wiederholungen für diesen Teilausdruck angeben, und Sie können auch andere Operationen an dem Teilausdruck durchführen (später beschrieben).
(\d{1,3}\.){3}\d{1,3}ist eineinfacher Ausdruck zum Abgleichen von IP-Adressen. Um diesen Ausdruck zu verstehen, analysieren Sie ihn in der folgenden Reihenfolge:\d{1,3}entspricht1 bis 3 Ziffern,(\d{1,3}\.){3}entsprichtdrei Ziffern plus ein englischer Punkt (das Ganze ist dieseGruppe), 3-mal wiederholt, und fügen Sie schließlicheine Zahl mit 1 bis 3 Ziffern hinzu(\d{1,3}).
Hinweis: Jede Zahl in einer IP-Adresse darf nicht größer als 255 sein. Oft werde ich gefragt, ob Zahlen mit führenden Nullen, wie 01.02.03.04, gültige IP-Adressen sind. Die Antwort ist: Ja, Zahlen in IP-Adressen können führende Nullen enthalten (führende Nullen).
Leider wird es auch256.300.888.999diese Art von unmöglicher IP-Adresse abgleichen. Wenn ein arithmetischer Vergleich verwendet werden könnte, ließe sich dieses Problem vielleicht einfach lösen, aber Regex bietet keine mathematische Funktionalität, daher können wir nur langwierige Gruppierung, Alternation und Zeichenklassen verwenden, um eine korrekte IP-Adresse zu beschreiben:((2[0-4]\d|25[0-5]|[01]?\d\d?)\.){3}(2[0-4]\d|25[0-5]|[01]?\d\d?)。
Der Schlüssel zum Verständnis dieses Ausdrucks ist das Verständnis von2[0-4]\d|25[0-5]|[01]?\d\d?. Ich werde hier nicht ins Detail gehen; Sie sollten in der Lage sein, seine Bedeutung selbst zu analysieren.
Negation
Manchmal müssen Sie nach Zeichen suchen, die nicht zu einer einfach definierten Zeichenklasse gehören. Wenn Sie beispielsweise ein beliebiges Zeichen außer Ziffern abgleichen möchten, müssen SieNegation verwenden:
| Code/Syntax | Beschreibung |
|---|---|
| \W | Trifft auf jedes Zeichen zu, das kein Buchstabe, keine Ziffer, kein Unterstrich und kein chinesisches Zeichen ist |
| \S | Finde ein beliebiges Zeichen, das kein Whitespace-Zeichen ist |
| \D | Finde ein beliebiges Nicht-Ziffer-Zeichen |
| \B | Finde eine Position, die nicht der Anfang oder das Ende eines Wortes ist |
| [^x] | Finde ein beliebiges Zeichen außer x |
| [^aeiou] | Finde ein beliebiges Zeichen außer den Buchstaben a, e, i, o, u |
Beispiel:\S+Findeeine Zeichenkette, die keine Whitespace-Zeichen enthält。
<a[^>]+>Findeeine in spitzen Klammern eingeschlossene Zeichenkette, die mit a beginnt。
Rückverweise
Nachdem Sie Klammern verwendet haben, um einen Teilausdruck anzugeben, kannder von diesem Teilausdruck gefundene Text(das heißt, der von dieser Gruppe erfasste Inhalt) im Ausdruck oder in anderen Programmen weiterverarbeitet werden. Standardmäßig hat jede Gruppe automatisch eineGruppennummer, und die Regel lautet: Von links nach rechts, wobei die linke Klammer der Gruppe als Markierung dient, hat die erste auftretende Gruppe die Gruppennummer 1, die zweite die 2 und so weiter.
Ähm... Eigentlich ist die Vergabe der Gruppennummern nicht so einfach, wie ich gerade gesagt habe:
- Gruppe 0 entspricht dem gesamten regulären Ausdruck.
- Tatsächlich umfasst der Prozess der Gruppennummernvergabe zwei Durchläufe von links nach rechts: Im ersten Durchlauf werden nur unbenannten Gruppen Nummern zugewiesen, und im zweiten Durchlauf werden nur benannten Gruppen Nummern zugewiesen -- daher haben alle benannten Gruppen größere Gruppennummern als unbenannte Gruppen.
- Sie können die(?:exp)Syntax wie folgt verwenden, um eine Gruppe von der Teilnahme an der Gruppennummernzuweisung auszuschließen.
Eine Rückreferenzwird verwendet, um wiederholt nach Text zu suchen, der von einer vorherigen Gruppe gefunden wurde. Zum Beispiel:\1repräsentiertden Text, der von Gruppe 1 gefunden wurde.Schwer zu verstehen? Sehen Sie sich das Beispiel an:
\b(\w+)\b\s+\1\bkann verwendet werden, umwiederholte Wörter abzugleichen,wiego go, oderkitty kitty. Dieser Ausdruck ist zuerstein Wort,das heißt,mehr als ein Buchstabe oder eine Ziffer zwischen dem Anfang und dem Ende eines Wortes(\b(\w+)\b), dieses Wort wird in die Gruppe mit der Nummer 1 aufgenommen, dannein oder mehrere Whitespace-Zeichen(\s+), und schließlichder Inhalt, der in Gruppe 1 erfasst wurde (das heißt, das zuvor gefundene Wort).(\1).
Sie können auch denGruppennamendes Teilausdrucks angeben. Um einen Gruppennamen für einen Teilausdruck anzugeben, verwenden Sie diese Syntax:(?<Word>\w+)(oder die spitzen Klammern durch'zu ersetzen ist ebenfalls in Ordnung:(?'Word'\w+)), dadurch wird\w+der Gruppenname von [etwas] alsWordangegeben. Um auf denerfasstenInhalt dieser Gruppe zurückzuverweisen, können Sie\k<Word>verwenden, sodass das vorherige Beispiel auch so geschrieben werden kann:\b(?<Word>\w+)\b\s+\k<Word>\b。
Bei der Verwendung von Klammern gibt es viele weitere Spezialsyntaxen. Die gebräuchlichsten sind unten aufgeführt:
| Kategorie | Code/Syntax | Beschreibung |
|---|---|---|
| Erfassung | (exp) | Stimmt mit exp überein und erfasst den Text in einer automatisch benannten Gruppe. |
| (?<name>exp) | Stimmt mit exp überein und erfasst den Text in einer Gruppe namens name; kann auch als (?'name'exp) geschrieben werden. | |
| (?:exp) | Stimmt mit exp überein, erfasst den übereinstimmenden Text nicht und weist dieser Gruppe keine Gruppennummer zu. | |
| Assertions mit Breite null | (?=exp) | Stimmt mit der Position vor exp überein. |
| (?<=exp) | Stimmt mit der Position nach exp überein. | |
| (?!exp) | Stimmt mit einer Position überein, auf die nicht exp folgt. | |
| (?<!exp) | Findet eine Position, an der das Davorstehende nicht exp ist. | |
| Kommentar | (?#comment) | Diese Art der Gruppierung hat keine Auswirkung auf die Verarbeitung regulärer Ausdrücke; sie dient dazu, Kommentare für Menschen zum Lesen bereitzustellen. |
Wir haben die ersten beiden Syntaxformen bereits besprochen. Die dritte(?:exp)ändert nicht, wie der reguläre Ausdruck verarbeitet wird; der von einer solchen Gruppe erfasste Inhaltwird nicht wie bei den ersten beiden in eine Gruppe übernommen und erhält auch keine Gruppennummer."Warum sollte ich das tun wollen?" -- Gute Frage, was denkst du?
Zero-Width-Assertions
Die nächsten vier werden verwendet, um Dinge vor oder nach bestimmtem Inhalt zu finden (aber ohne diesen Inhalt einzuschließen); das heißt, sie werden sozusagen\b,^,$verwendet, um eine Position anzugeben, und diese Position sollte eine bestimmte Bedingung erfüllen (also eine Assertion), daher heißen sie auchNullbreiten-Assertions.Am besten veranschaulicht man sie anhand von Beispielen:
Hinweis: Eine Assertion wird verwendet, um eine Tatsache zu deklarieren, die wahr sein sollte. In einem regulären Ausdruck wird der Abgleich nur fortgesetzt, wenn die Assertion wahr ist.
(?=exp)Auch genanntNullbreiten-Positive-Lookahead-Assertion, sieassertiert, dass nach ihrer eigenen Position der Ausdruck exp abgeglichen werden kann.Zum Beispiel,\b\w+(?=ing\b), findetden vorderen Teil von Wörtern, die auf ing enden (den Teil außer ing),wie zum Beispiel bei der Suche nachI'm singing while you're dancing., wird es übereinstimmen mitsingunddanc。
(?<=exp)Auch genanntNullbreiten-Positive-Lookbehind-Assertion, sieassertiert, dass vor ihrer eigenen Position der Ausdruck exp abgeglichen werden kann.Zum Beispiel,(?<=\bre)\w+\bpasst zudem hinteren Teil von Wörtern, die mit re beginnen (dem Teil außer re),, zum Beispiel, bei der Suche nachreading a book, passt es zuading。
Wenn Sie in einer langen Zahl alle drei Ziffern ein Komma einfügen möchten (natürlich von rechts beginnend), können Sie dies verwenden, um die Stellen zu finden, an denen Kommas davor und darin eingefügt werden müssen:((?<=\d)\d{3})+\b, angewendet auf1234567890das Ergebnis der Suche ist234567890。
Das folgende Beispiel verwendet beide dieser Assertionen gleichzeitig:(?<=\s)\d+(?=\s)Findetdurch Leerraum getrennte Ziffern (wiederum ohne den Leerraum)。
Negative Zero-Width-Assertions
Früher haben wir erwähnt, wie manZeichen findet, die kein bestimmtes Zeichen sind oder nicht in einer bestimmten Zeichenklasse sindMethode für Zeichen (Negation). Aber wenn wir nursicherstellen wollen, dass ein bestimmtes Zeichen nicht vorkommt, es aber nicht abgleichen wollenWas sollen wir tun? Zum Beispiel, wenn wir Wörter wie diese finden wollen -- sie enthalten den Buchstaben q, aber auf q folgt nicht der Buchstabe u, können wir Folgendes versuchen:
\b\w*q[^u]\w*\bFindeWörter, dieden Buchstaben q enthalten, auf den nicht der Buchstabe u folgt.Aber wenn du mehr testest (oder dein Verstand scharf genug ist, es direkt zu sehen), wirst du feststellen, dass, wenn q am Ende eines Wortes vorkommt, wieIraq,Benq, wird dieser Ausdruck fehlschlagen. Das liegt daran, dass[^u]immer auf ein Zeichen passen muss, also wenn q das letzte Zeichen eines Wortes ist, wird das folgende[^u]auf das Worttrennzeichen nach q passen (das könnte ein Leerzeichen, ein Punkt oder etwas anderes sein), und das folgende\w*\bwird mit dem nächsten Wort übereinstimmen, also\b\w*q[^u]\w*\bkann die gesamtenIrak-Kämpfe。negative Nullbreiten-Assertionkann dieses Problem lösen, weil sie nur eine Position trifft und nichtverbrauchenbeliebige Zeichen. Jetzt können wir dieses Problem so lösen:\b\w*q(?!u)\w*\b。
Negative Lookahead-Assertion mit Nullbreite(?!exp),stellt sicher, dass nach dieser Position der Ausdruck exp nicht übereinstimmen kann.Zum Beispiel:\d{3}(?!\d)Findedrei Ziffern, und auf diese drei Ziffern darf keine Ziffer folgen.;\b((?!abc)\w)+\bFindeWörter, die die zusammenhängende Zeichenkette abc nicht enthalten.。
Ähnlich können wir(?<!exp),Zero-Width-Negative-Lookbehind-Assertion verwenden, umzu behaupten, dass vor dieser Position der Ausdruck exp nicht übereinstimmen kann.:(?<![a-z])\d{7}Findesieben Ziffern, denen kein Kleinbuchstabe vorausgeht.。
Ein komplexeres Beispiel:(?<=<(\w+)>).*(?=<\/\1>)Findeden Inhalt innerhalb einfacher HTML-Tags, die keine Attribute enthalten.。(?<=<(\w+)>)gibt ein solchesPräfix an, nämlich:ein in spitze Klammern eingeschlossenes Wort(wie möglicherweise <b>), dann.*(eine beliebige Zeichenkette), und schließlich einSuffix(?=<\/\1>). Beachten Sie, dass im Suffix,\/, verwendet er das zuvor erwähnte Zeichen-Escaping;\1ist ein Rückverweis, der sich genau aufdie erste erfasste Gruppe bezieht,die durch den vorangehenden(\w+)Inhalt abgeglichen wird, wenn also das Präfix tatsächlich <b> ist, dann ist das Suffix </b>. Der gesamte Ausdruck stimmt mit dem Inhalt zwischen <b> und </b> überein (wiederum ohne das Präfix und das Suffix selbst).
Hinweis: Bitte analysieren Sie den Ausdruck im Detail(?<=<(\w+)>).*(?=<\/\1>); dieser Ausdruck zeigt am besten den wahren Zweck von Nullbreiten-Assertions.
Kommentare
Eine weitere Verwendung von Klammern ist das Einfügen von Kommentaren über die Syntax(?#comment). Zum Beispiel:2[0-4]\d(?#200-249)|25[0-5](?#250-255)|[01]?\d\d?(?#0-199)。
Wenn Sie Kommentare einfügen möchten, ist es am besten, die Option "Leerzeichen im Muster ignorieren" zu aktivieren, damit Sie beim Schreiben des Ausdrucks frei Leerzeichen, Tabulatoren und Zeilenumbrüche hinzufügen können, die jedoch in der tatsächlichen Verwendung alle ignoriert werden. Nach dem Aktivieren dieser Option wird der gesamte Text von # bis zum Ende dieser Zeile als Kommentar ignoriert. Zum Beispiel können wir einen vorherigen Ausdruck so schreiben:
      (?<=    # 断言要匹配的文本的前缀
      <(\w+)> # 查找尖括号括起来的字母或数字(即HTML/XML标签)
      )       # 前缀结束
      .*      # 匹配任意文本
      (?=     # 断言要匹配的文本的后缀
      <\/\1>  # 查找尖括号括起来的内容:前面是一个"/",后面是先前捕获的标签
      )       # 后缀结束
Greedy und Lazy
Wenn ein regulärer Ausdruck einen Quantifizierer enthält, der Wiederholung zulassen kann, besteht das übliche Verhalten darin (unter der Voraussetzung, dass der gesamte Ausdruck gematcht werden kann),so vieleZeichen wie möglich zu matchen. Nehmen Sie diesen Ausdruck als Beispiel:a.*b, wird esdie längste Zeichenkette matchen, die mit a beginnt und mit b endet.Wenn Sie es zum Suchen nachaababverwenden, wird es die gesamte Zeichenketteaabab matchen.. Dies nennt mangierigesMatching.
Manchmal benötigen wirLazy-Matching, das heißt, wir matchenso wenigeZeichen wie möglich. Die zuvor angegebenen Quantifizierer können in den Lazy-Matching-Modus umgewandelt werden, indem man ein Fragezeichen nach ihnen hinzufügt?. Auf diese Weise,.*?es bedeutet, eine beliebige Anzahl von Wiederholungen zu matchen, aber so wenige Wiederholungen wie möglich zu verwenden, während die gesamte Übereinstimmung dennoch erfolgreich sein kann. Schauen wir uns nun ein Beispiel der Lazy-Version an:
a.*?bFindedie kürzeste Zeichenkette, die mit a beginnt und mit b endet. Wenn du es aufaababanwendest, wird esaab (die ersten bis dritten Zeichen) findenundab (die vierten bis fünften Zeichen)。
Hinweis: Warum ist die erste Übereinstimmung aab (die ersten bis dritten Zeichen) statt ab (die zweiten bis dritten Zeichen)? Einfach ausgedrückt, weil reguläre Ausdrücke eine weitere Regel haben, die Vorrang vor der Lazy/Greedy-Regel hat: Die Übereinstimmung, die am frühesten beginnt, hat die höchste Priorität — Die Übereinstimmung, die am frühesten beginnt, gewinnt.
| Code/Syntax | Beschreibung |
|---|---|
| *? | Beliebig oft wiederholen, aber so wenige Male wie möglich |
| +? | Ein- oder mehrmals wiederholen, aber so wenige Male wie möglich |
| ?? | Null- oder einmal wiederholen, aber so wenige Male wie möglich |
| {n,m}? | n bis m Mal wiederholen, aber so wenige Male wie möglich |
| {n,}? | n oder mehr Mal wiederholen, aber so wenige Male wie möglich |
Verarbeitungsoptionen
Oben wurden mehrere Optionen vorgestellt, wie z. B. Ignorieren der Groß-/Kleinschreibung, Behandeln mehrerer Zeilen usw. Mit diesen Optionen kann die Art und Weise geändert werden, wie reguläre Ausdrücke verarbeitet werden. Im Folgenden sind gängige Optionen für reguläre Ausdrücke in .Net aufgeführt:
| Name | Beschreibung |
|---|---|
| IgnoreCase (Groß-/Kleinschreibung ignorieren) | Bei der Übereinstimmung wird nicht zwischen Groß- und Kleinschreibung unterschieden. |
| Multiline (Mehrzeilenmodus) | Ändern^und$die Bedeutung von `^` und `$`, sodass sie jeweils am Anfang und Ende jeder Zeile übereinstimmen, nicht nur am Anfang und Ende der gesamten Zeichenkette. (In diesem Modus ist$die genaue Bedeutung von `$`: Übereinstimmung mit der Position vor \n und der Position vor dem Ende der Zeichenkette.) |
| Singleline (Einzeilenmodus) | Ändern.Sie die Bedeutung von `.`, sodass es auf jedes Zeichen passt (einschließlich des Zeilenumbruchs \n). |
| IgnorePatternWhitespace (Leerraum ignorieren) | Ignorieren Sie nicht escapeten Leerraum im Ausdruck und aktivieren#Sie Kommentare, die mit `#` gekennzeichnet sind. |
| ExplicitCapture (explizite Erfassung) | Nur Gruppen erfassen, die explizit benannt wurden. |
Eine häufig gestellte Frage ist: Kann immer nur einer von Mehrzeilenmodus und Einzeilenmodus gleichzeitig verwendet werden? Die Antwort ist: Nein. Diese beiden Optionen haben nichts miteinander zu tun, außer dass ihre Namen ähnlich sind (was verwirrend ist).
Hinweis: In C# können Sieden Konstruktor Regex(String, RegexOptions)verwenden, um die Verarbeitungsoptionen für einen regulären Ausdruck festzulegen. Zum Beispiel: Regex regex = new Regex(@"\ba\w{6}\b", RegexOptions.IgnoreCase);
Balancierte Gruppen / Rekursives Matching
Hinweis: Die hier eingeführte Syntax für balancierte Gruppen wird vom .Net Framework unterstützt; andere Sprachen/Bibliotheken unterstützen diese Funktion möglicherweise nicht oder unterstützen sie, erfordern aber eine andere Syntax.
Manchmal müssen wir( 100 * ( 50 + 15 ) ) solche verschachtelbaren hierarchischen Strukturen abgleichen; in diesem Fall gleicht die bloße Verwendung von\(.+\)nur den Inhalt zwischen der am weitesten links stehenden linken Klammer und der am weitesten rechts stehenden rechten Klammer ab (hier diskutieren wir den gierigen Modus; der faule Modus hat ebenfalls das folgende Problem). Wenn die Anzahl der linken und rechten Klammern in der ursprünglichen Zeichenkette nicht gleich ist, zum Beispiel( 5 / ( 3 + 2 ) ) ), dann ist auch die Anzahl der beiden in unserem Übereinstimmungsergebnis nicht gleich. Gibt es eine Möglichkeit, den längsten Inhalt mit gepaarten Klammern in einer solchen Zeichenkette abzugleichen?
Um zu vermeiden, dass(und\(Ihr Gehirn völlig verwirren, verwenden wir spitze Klammern anstelle von runden Klammern. Nun besteht unser Problem darin, wie manxx <aa <bbb> <bbb> aa> yy erfasst.den längsten Inhalt mit gepaarten spitzen Klammern in einer solchen Zeichenkette?
Hier werden die folgenden Syntaxkonstrukte benötigt:
- (?'group')Benennen Sie den erfassten Inhalt als group und legen Sie ihn aufden Stapel (Stack)
- (?'-group')Nimmt den zuletzt erfassten Inhalt namens group, der auf den Stapel gelegt wurde, vom Stapel; wenn der Stapel ursprünglich leer war, schlägt die Übereinstimmung dieser Gruppe fehl
- (?(group)yes|no)Wenn sich ein Capture namens group auf dem Stapel befindet, setzen Sie den Abgleich mit dem Ausdruck im yes-Teil fort; andernfalls setzen Sie den Abgleich mit dem no-Teil fort
- (?!)Negative Lookahead-Assertion mit Nullbreite. Da kein Suffix-Ausdruck vorhanden ist, schlägt ein versuchter Abgleich immer fehl
Hinweis: Wenn Sie kein Programmierer sind (oder behaupten, ein Programmierer zu sein, aber nicht wissen, was ein Stack ist), dann verstehen Sie die drei obigen Syntaxkonstrukte so: Das erste schreibt eine „Gruppe“ an die Tafel, das zweite löscht eine „Gruppe“ von der Tafel, und das dritte prüft, ob noch eine „Gruppe“ an der Tafel steht; wenn ja, wird weiter der Ja-Teil abgeglichen, andernfalls der Nein-Teil.
Was wir tun müssen, ist: Jedes Mal, wenn wir auf eine öffnende Klammer stoßen, ein „Open“ auf den Stack legen; jedes Mal, wenn wir auf eine schließende Klammer stoßen, eines entfernen; am Ende prüfen, ob der Stack leer ist -- wenn er nicht leer ist, beweist das, dass es mehr öffnende als schließende Klammern gibt, und der Abgleich sollte fehlschlagen. Die Regex-Engine wird zurückverfolgen (Backtracking durchführen), indem sie einige Zeichen ganz am Anfang oder Ende aufgibt, um zu versuchen, den gesamten Ausdruck zur Übereinstimmung zu bringen.
<                         #最外层的左括号
    [^<>]*                #最外层的左括号后面的不是括号的内容
    (
        (
            (?'Open'<)    #碰到了左括号,在黑板上写一个"Open"
            [^<>]*        #匹配左括号后面的不是括号的内容
        )+
        (
            (?'-Open'>)   #碰到了右括号,擦掉一个"Open"
            [^<>]*        #匹配右括号后面不是括号的内容
        )+
    )*
    (?(Open)(?!))         #在遇到最外层的右括号前面,判断黑板上还有没有没擦掉的"Open";如果还有,则匹配失败

>                         #最外层的右括号
Eine der häufigsten Anwendungen von balancierten Gruppen ist das Abgleichen von HTML. Das folgende Beispiel kannverschachtelte <div>-Tags abgleichen:<div[^>]*>[^<>]*(((?'Open'<div[^>]*>)[^<>]*)+((?'-Open'</div>)[^<>]*)+)*(?(Open)(?!))</div>.
Was sonst noch nicht erwähnt wurde
Oben wurden viele Elemente zum Konstruieren regulärer Ausdrücke beschrieben, aber es gibt noch viele Dinge, die nicht erwähnt wurden. Unten folgt eine Liste der nicht erwähnten Elemente, einschließlich Syntax und einfacher Beschreibungen.
| Code/Syntax | Beschreibung |
|---|---|
| \a | Glockenzeichen (bei der Ausgabe lässt es den Computer einmal piepen) |
| \b | Üblicherweise eine Wortgrenze, aber wenn es in einer Zeichenklasse verwendet wird, steht es für Backspace |
| \t | Tabulatorzeichen, Tab |
| \r | Wagenrücklauf |
| \v | Vertikaltabulator |
| \f | Seitenvorschub |
| \n | Zeilenumbruchzeichen |
| \e | Escape |
| \0nn | Zeichen mit Oktalcode nn in ASCII |
| \xnn | Zeichen mit Hexadezimalcode nn in ASCII |
| \unnnn | Zeichen mit Hexadezimalcode nnnn in Unicode |
| \cN | ASCII-Steuerzeichen. Zum Beispiel steht \cC für Ctrl+C |
| \A | Anfang der Zeichenfolge (ähnlich wie ^, aber nicht durch die Mehrzeilenoption beeinflusst) |
| \Z | Ende der Zeichenfolge oder Zeilenende (nicht durch die Mehrzeilenoption beeinflusst) |
| \z | Ende der Zeichenfolge (ähnlich wie $, aber nicht durch die Mehrzeilenoption beeinflusst) |
| \G | Anfang der aktuellen Suche |
| \p{name} | Unicode-Zeichenklasse namens name, zum Beispiel \p{IsGreek} |
| (?>exp) | Gieriger Teilausdruck |
| (?<x>-<y>exp) | Balancierte Gruppe |
| (?im-nsx:exp) | Ändere die Verarbeitungsoptionen im Teilausdruck exp |
| (?im-nsx) | Ändere die Verarbeitungsoptionen für den Teil nach dem Ausdruck |
| (?(exp)yes|no) | Behandle exp als eine positive Lookahead-Assertion mit Nullbreite. Wenn sie an dieser Position übereinstimmen kann, verwende yes als Ausdruck für diese Gruppe; andernfalls verwende no |
| (?(exp)yes) | Wie oben, außer dass als no ein leerer Ausdruck verwendet wird |
| (?(name)yes|no) | Wenn die Gruppe mit dem Namen name Inhalt erfasst hat, verwende yes als Ausdruck; andernfalls verwende no |
| (?(name)yes) | Wie oben, außer dass als no ein leerer Ausdruck verwendet wird |
Weitere Tutorials
Für eine ausführlichere Anleitung siehe:Regulärer Ausdruck - Tutorial
Quelle: http://deerchao.net/tutorials/regex/regex.htm