Содержание
- Цель этой статьи
- Как пользоваться этим руководством
- Что такое регулярное выражение на самом деле?
- Начало работы
- Тестирование регулярных выражений
- Метасимволы
- Экранирование символов
- Повторение
- Классы символов
- Условия ветвления
- Отрицание
- Группировка
- Обратные ссылки
- Утверждения нулевой ширины
- Негативные утверждения нулевой ширины
- Комментарии
- Жадные и ленивые
- Параметры обработки
- Сбалансированные группы / рекурсивное сопоставление
- Что ещё не было упомянуто
Цель этой статьи
За 30 минут позволит вам понять, что такое регулярное выражение, и получить базовое представление о нём, чтобы вы могли использовать его в своих программах или веб-страницах.
Как пользоваться этим руководством
Не пугайтесь сложных выражений ниже. Просто следуйте за мной шаг за шагом, и вы обнаружите, что регулярные выражения на самом деле не так сложны, как кажется. Конечно, если после прочтения этого руководства вы поймёте многое, но почти ничего не запомните, это тоже нормально — я думаю, что для человека, который никогда не сталкивался с регулярными выражениями, вероятность запомнить более 80% упомянутого синтаксиса после прочтения этого руководства равна нулю. Это лишь для того, чтобы вы поняли основные принципы. Позже вам нужно больше практиковаться и чаще использовать их, чтобы освоить регулярные выражения.
Помимо того что эта статья является руководством для начинающих, она также пытается стать справочником по синтаксису регулярных выражений, который можно использовать в повседневной работе. Исходя из собственного опыта автора, эта цель была достигнута довольно хорошо — видите, я и сам не смог запомнить всё, не так ли?
Что такое регулярное выражение на самом деле?
При написании программ или веб-страниц, обрабатывающих строки, часто возникает необходимость находить строки, соответствующие определённым сложным правилам.Регулярное выражение— это инструмент, используемый для описания этих правил. Иными словами, регулярное выражение — это код, который записывает текстовые правила.
Вы, вероятно, использовали тот, что в Windows/DOS для поиска файлов:подстановочный знак, то есть*и?. Если вы хотите найти все документы Word в каталоге, вы бы искали*.doc. Здесь*будет интерпретироваться как любая строка. Как и подстановочные знаки, регулярные выражения также являются инструментами для сопоставления текста, за исключением того, что по сравнению с подстановочными знаками они могут более точно описать ваши потребности — конечно, ценой большей сложности — например, вы можете написать регулярное выражение, чтобы найтивсе строки, которые начинаются с 0, за которым следуют 2-3 цифры, затем дефис «-», и наконец 7 или 8 цифр.(например,010-12345678или0376-7654321).
Примечание: символ— это самая базовая единица, когда компьютерное программное обеспечение обрабатывает текст. Это может быть буква, цифра, знак пунктуации, пробел, символ новой строки, китайский иероглиф и т. д.Строка— это последовательность из нуля или более символов.Текст— это тоже слова, строки. Говоря, что строкасоответствуетнекоторому регулярному выражению, обычно имеют в виду, что часть (или несколько частей по отдельности) этой строки может удовлетворять условиям, заданным выражением.
Начало работы
Лучший способ изучить регулярные выражения — начать с примеров. После понимания примеров изменяйте их и экспериментируйте с ними самостоятельно. Ниже приведено множество простых примеров с подробными объяснениями.
Предположим, вы ищетеhiв английском романе, вы можете использовать регулярное выражениеhi。
Это почти самое простое регулярное выражение. Оно может точно соответствовать строке, подобной этой:состоящей из двух символов: первый символ — h, а второй — i.. Обычно инструменты, обрабатывающие регулярные выражения, предоставляют опцию игнорирования регистра. Если эта опция выбрана, оно может соответствоватьhi,HI,Hi,hIлюбой из этих четырёх вариантов.
К сожалению, многие слова содержатhiэти два идущих подряд символа, напримерhim,history,highи т. д. Если использоватьhiдля поиска, тоhiвнутри них также будут найдены. Если вы хотитеточно найти слово "hi", следует использовать\bhi\b。
\b— это специальный код, определяемый регулярными выражениями (впрочем, некоторые называют егометасимволом), обозначающийначало или конец слова, то есть границу слова.. Хотя английские слова обычно разделяются пробелами, знаками препинания или переводами строк,\bне совпадает ни с одним из этих разделяющих слова символов; онсовпадает только с позицией.。
Примечание: если нужно более точное определение,\bсоответствует позиции, в которой предшествующий и следующий за ней символы не являются одновременно словесными символами (один является, другой нет, или один не существует).\w。
Если вы хотите найти"hi", за которым вскоре следует "Lucy", вам следует использовать\bhi\b.*\bLucy\b。
Здесь,.— это ещё один метасимвол, который соответствуетлюбому символу, кроме символов перевода строки.。*также является метасимволом, но он не представляет символ или позицию; скорее, он представляет количество — он указывает, что *содержимое перед ним может повторяться подряд любое количество раз, чтобы совпало всё выражение.. Следовательно,.*при соединении вместе означаетлюбое количество символов, не содержащих переводов строк.. Теперь\bhi\b.*\bLucy\bсмысл очень очевиден:сначала идёт слово "hi", затем любое количество любых символов (но не переводов строк), и наконец слово "Lucy".。
Примечание: символ перевода строки — это '\n', символ с ASCII-кодом 10 (шестнадцатеричное 0x0A).
Если мы используем другие метасимволы вместе, мы можем построить более мощные регулярные выражения. Например, следующий пример:
0\d\d-\d\d\d\d\d\d\d\dСопоставить строку вида:начинающуюся с 0, затем две цифры, затем дефис "-", и наконец 8 цифр.(Это китайский номер телефона. Конечно, этот пример может сопоставить только случай, когда код города состоит из 3 цифр).
Здесь,\d— это новый метасимвол, который соответствуетодной цифре (0, или 1, или 2, или ...)。-не является метасимволом; он соответствует только самому себе — дефису (или знаку минуса, или тире, или как вы его называете).
Чтобы избежать столь надоедливого повторения, мы также можем записать это выражение так:0\d{2}-\d{8}. Здесь\dпосле{2}({8}) означает, что предшествующий\dдолжен непрерывно повторяться и сопоставляться 2 раза (8 раз).。
Тестирование регулярных выражений
Если вы не находите регулярные выражения трудными для чтения и написания, то вы либо гений, либо не с Земли. Синтаксис регулярных выражений — головная боль даже для тех, кто часто ими пользуется. Поскольку их трудно читать и писать и они подвержены ошибкам, необходимо найти инструмент для тестирования регулярных выражений.
Некоторые детали регулярных выражений различаются в разных средах. Вот два доступных инструмента для тестирования:
- RegexBuddy
- Онлайн-инструмент для тестирования регулярных выражений JavaScript
Метасимволы
Теперь вы уже знаете несколько очень полезных метасимволов, таких как\b,.,*, и\d. В регулярных выражениях есть и другие метасимволы, например\sсоответствуетлюбому пробельному символу, включая пробелы, табуляции (Tab), символы новой строки, китайские полноширинные пробелы и т. д.。\wсоответствуетбуквам, цифрам, знакам подчёркивания или китайским иероглифам и т. д.。
Примечание: специальная обработка китайского языка/китайских иероглифов поддерживается движком регулярных выражений, предоставляемым .NET. Для конкретных ситуаций в других средах обратитесь к соответствующей документации.
Давайте посмотрим на дополнительные примеры ниже:
\ba\w*\bсоответствуетсловам, начинающимся с буквыa— сначала начало слова (\b), затем букваa, затем любое количество букв или цифр (\w*), и наконец конец слова (\b)。
Примечание: Что ж, теперь давайте поговорим о том, что означает слово в регулярных выражениях: это один или несколько идущих подряд\w. Действительно, это имеет мало общего с тысячами одноимённых вещей, которые вам приходилось запоминать при изучении английского :)
\d+соответствует1 или более последовательным цифрам. Здесь+— метасимвол, похожий на*, разница в том, что*соответствуетповторяется любое количество раз (возможно, ноль), тогда как+соответствует, повторённому один или более раз。
\b\w{6}\bсоответствуетслову ровно из 6 символов。
| Code | Описание |
|---|---|
| . | Соответствует любому символу, кроме перевода строки |
| \w | Соответствует букве, цифре, символу подчёркивания или китайскому иероглифу |
| \s | Соответствует любому пробельному символу |
| \d | Соответствует цифре |
| \b | Соответствует началу или концу слова |
| ^ | Соответствует началу строки |
| $ | Соответствует концу строки |
Примечание: механизмы регулярных выражений обычно предоставляют метод для «проверки, соответствует ли заданная строка регулярному выражению», например RegExp.test() в JavaScript или Regex.IsMatch() в .NET. Совпадение здесь означает, есть ли в строке часть, соответствующая правилам выражения. Если вы не используете^и$, то для\d{5,12}использование такого метода гарантирует только то, что строкасодержит от 5 до 12 последовательных цифр, а не то, что вся строка состоит из 5–12 цифр.
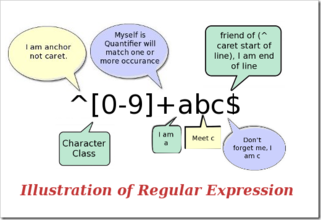
Метасимвол^(символ на той же клавише, что и цифра 6) и$оба соответствуют позиции, что\bнесколько похоже на^совпадает с началом строки, которую вы ищете,$соответствует концу. Эти два кода очень полезны при проверке ввода; например, если сайт требует, чтобы введённый вами номер QQ состоял из 5–12 цифр, можно использовать:^\d{5,12}$。
Этот{5,12}и ранее представленный{2}похожи, за исключением того, что{2}соответствуетповторённому ровно 2 раза,{5,12}, тогда какчисло повторений должно быть не меньше 5 и не больше 12, иначе совпадения не будет.
Из-за использования^и$вся входная строка должна быть\d{5,12}использована для сопоставления, то есть весь вводдолжен состоять из 5–12 цифр, поэтому, если введённый номер QQ соответствует этому регулярному выражению, он удовлетворяет требованию.
Подобно опции нечувствительности к регистру, некоторые инструменты обработки регулярных выражений также имеют многострочную опцию. Если эта опция выбрана,^и$значениесостоит в совпадении с началом и концом строки。
Экранирование символов
Если вы хотите найти сам метасимвол, например вы ищете., или*, возникает проблема: вы не можете указать их, потому что они будут интерпретированы как что-то другое. Тогда вам придётся использовать\чтобы отменить особое значение этих символов. Следовательно, вы должны использовать\.и\*. Конечно, чтобы найти сам\, вам также нужно использовать\\.
Например:deerchao\.netсоответствуетdeerchao.net,C:\\WindowsсоответствуетC:\Windows。
Повторение
Вы уже видели*,+,{2},{5,12}ранее способы сопоставления повторений. Ниже перечислены все квантификаторы в регулярных выражениях (коды, задающие количество, такие как *, {5,12} и т. д.):
| Код/Синтаксис | Описание |
|---|---|
| * | Повторять ноль или более раз |
| + | Повторять один или более раз |
| ? | Повторять ноль или один раз |
| {n} | Повторять ровно n раз |
| {n,} | Повторять n или более раз |
| {n,m} | Повторять от n до m раз |
Вот несколько примеров повторения:
Windows\d+совпадает сWindows, за которыми следует одна или несколько цифр
^\w+совпадает спервым словом строки (или первым словом всей строки; какое значение применяется, зависит от настроек параметров)
Классы символов
Поиск цифр, букв или цифр и пробельных символов прост, потому что для этих наборов символов уже есть метасимволы, но что делать, если вы хотите сопоставить набор символов без предопределённого метасимвола (например, гласные буквы a, e, i, o, u)?
Очень просто: вы просто перечисляете их в квадратных скобках, например[aeiou]совпадает слюбой одной из английских гласных букв,[.?!]совпадает сзнаком препинания (. или ? или !)。
Мы также можем легко указать символьныйдиапазон, например[0-9]значение, представленное\d, в точности такое же:цифра; аналогично[a-z0-9A-Z_]также полностью эквивалентно\w(если рассматривать только английский).
Вот более сложное выражение:\(?0\d{2}[) -]?\d{8}。
Примечание: "(" и ")" также являются метасимволами; в более позднемразделе о группировкеэто будет упомянуто, поэтому здесь нужно использоватьэкранирование。
Это выражение может соответствоватьнескольким форматам телефонных номеров, таким как(010)88886666, или022-22334455, или02912345678, и т. д. Давайте разберём его: сначала идёт экранированный символ\(, который может встречаться 0 или 1 раз (?), затем0, после чего 2 цифры (\d{2}), затем один из)или-илипробел, который появляется 1 раз или не появляется вовсе (?), и наконец 8 цифр (\d{8}).
Условия ветвления
К сожалению, предыдущее выражение также может соответствовать010)12345678или(022-87654321такому «неправильному» формату. Чтобы решить эту проблему, нам нужно использоватьусловия ветвления. Условия ветвления в regexусловия ветвленияозначают, что есть несколько правил, и если выполняется любое из них, это следует считать совпадением. Конкретный способ — использовать|для разделения разных правил. Не понимаете? Не имеет значения, посмотрите на пример:
0\d{2}-\d{8}|0\d{3}-\d{7}Это выражение можетсопоставляться с двумя видами телефонных номеров, разделённых дефисом: один — 3-значный код города с 8-значным местным номером (например, 010-12345678), а другой — 4-значный код города с 7-значным местным номером (0376-2233445)。
\(?0\d{2}\)?[- ]?\d{8}|0\d{2}[- ]?\d{8}Это выражениесопоставляется с телефонными номерами с 3-значным кодом города, где код города может быть заключён в скобки или нет, а код города и местный номер могут быть разделены дефисом или пробелом, или могут не иметь разделителя. Вы можете попробовать расширить это выражение, чтобы также поддерживать 4-значные коды городов с помощью условий ветвления.
\d{5}-\d{4}|\d{5}Это выражение используется для сопоставления с почтовыми индексами США. Правило для почтовых индексов США (ZIP) — 5 цифр или 9 цифр, разделённых дефисом. Причина, по которой приведён этот пример, в том, что он иллюстрирует проблему:При использовании условий ветвления обращайте внимание на порядок условий. Если изменить его на\d{5}|\d{5}-\d{4}, то он будет соответствовать только 5-значным почтовым индексам (и первым 5 цифрам 9-значных почтовых индексов). Причина в том, что при сопоставлении условий ветвления каждое условие проверяется слева направо; если одна ветвь удовлетворена, остальные условия не рассматриваются.
Группировка
Мы уже упоминали, как повторять один символ (просто добавьте квантификатор сразу после символа); но что делать, если вы хотите повторить несколько символов? Можно использовать круглые скобки, чтобы задатьподвыражение(также называемоегруппой), и затем можно указать количество повторений для этого подвыражения, а также выполнять другие операции над подвыражением (описано позже).
(\d{1,3}\.){3}\d{1,3}— этопростоевыражение для сопоставления IP-адресов. Чтобы понять это выражение, проанализируйте его в следующем порядке:\d{1,3}соответствуетот 1 до 3 цифр,(\d{1,3}\.){3}соответствуеттри цифры плюс английская точка (всё это — этагруппа), повторённые 3 раза, и наконец добавьтечисло от 1 до 3 цифр(\d{1,3}).
Примечание: каждое число в IP-адресе не может быть больше 255. Меня часто спрашивают, являются ли числа с ведущими нулями, например 01.02.03.04, допустимыми IP-адресами. Ответ: да, числа в IP-адресах могут содержать ведущие нули (нули в начале).
К сожалению, он также будет соответствовать256.300.888.999такому невозможному IP-адресу. Если бы можно было использовать арифметическое сравнение, возможно, эту проблему удалось бы решить просто, но регулярные выражения не предоставляют никаких математических возможностей, поэтому можно использовать только длинные группировки, чередование и классы символов, чтобы описать правильный IP-адрес:((2[0-4]\d|25[0-5]|[01]?\d\d?)\.){3}(2[0-4]\d|25[0-5]|[01]?\d\d?)。
Ключ к пониманию этого выражения — понимание2[0-4]\d|25[0-5]|[01]?\d\d?. Здесь я не буду вдаваться в подробности; вы должны сами суметь проанализировать его смысл.
Отрицание
Иногда нужно искать символы, которые не принадлежат просто определённому классу символов. Например, если вы хотите сопоставить любой символ, кроме цифр, нужно использоватьотрицание:
| Код/Синтаксис | Описание |
|---|---|
| \W | Совпадает с любым символом, который не является буквой, цифрой, символом подчёркивания или китайским иероглифом |
| \S | Совпадение с любым символом, который не является пробельным символом |
| \D | Совпадение с любым нецифровым символом |
| \B | Совпадение с позицией, которая не является началом или концом слова |
| [^x] | Совпадение с любым символом, кроме x |
| [^aeiou] | Совпадение с любым символом, кроме букв a, e, i, o, u |
Пример:\S+Сопоставитьстроку, не содержащую пробельных символов。
<a[^>]+>Сопоставитьстроку, заключённую в угловые скобки, которая начинается с a。
Обратные ссылки
После использования круглых скобок для указания подвыражения,текст, сопоставленный этим подвыражением,(то есть содержимое, захваченное этой группой), может быть дополнительно обработан в выражении или в других программах. По умолчанию каждая группа автоматически имеетномер группы, и правило таково: слева направо, используя левую круглую скобку группы как маркер, первая появившаяся группа имеет номер группы 1, вторая — 2, и так далее.
Хм... На самом деле, присвоение номеров группам не так просто, как я только что сказал:
- Группа 0 соответствует всему регулярному выражению.
- На самом деле, процесс присвоения номеров группам предполагает сканирование слева направо дважды: первый проход присваивает номера только неименованным группам, а второй проход присваивает номера только именованным группам -- поэтому все именованные группы имеют большие номера групп, чем неименованные группы.
- Вы можете использовать(?:exp)такой синтаксис, чтобы лишить группу участия в присвоении номера группы.
Обратная ссылкаиспользуется для повторного поиска текста, совпавшего с предыдущей группой. Например,\1представляеттекст, совпавший с группой 1.Сложно понять? См. пример:
\b(\w+)\b\s+\1\bможно использовать для сопоставленияповторяющихся слов,напримерgo go, илиkitty kitty. Это выражение сначала представляет собойслово,то естьболее одной буквы или цифры между началом и концом слова(\b(\w+)\b), это слово будет захвачено в группу с номером 1, затемодин или несколько символов пробела(\s+), и наконецсодержимое, захваченное в группе 1 (то есть слово, совпавшее ранее).(\1).
Вы также можете указать у подвыраженияимя группы. Чтобы указать имя группы для подвыражения, используйте такой синтаксис:(?<Word>\w+)(или заменить угловые скобки на'тоже допустимо:(?'Word'\w+)), это делает\w+имя группы [чего-то] указанным какWord. Чтобы сослаться на эту группузахваченноесодержимое, можно использовать\k<Word>, поэтому предыдущий пример также можно записать так:\b(?<Word>\w+)\b\s+\k<Word>\b。
При использовании круглых скобок существует много других синтаксисов специального назначения. Наиболее распространённые из них перечислены ниже:
| Категория | Код/Синтаксис | Описание |
|---|---|---|
| Захват | (exp) | Сопоставить exp и захватить текст в автоматически именованную группу. |
| (?<name>exp) | Сопоставить exp и захватить текст в группу с именем name; также можно записать как (?'name'exp). | |
| (?:exp) | Сопоставить exp, не захватывать сопоставленный текст и не присваивать этой группе номер группы. | |
| Утверждения нулевой ширины | (?=exp) | Сопоставить позицию перед exp. |
| (?<=exp) | Сопоставить позицию после exp. | |
| (?!exp) | Сопоставить позицию, в которой далее следует не exp. | |
| (?<!exp) | Совпадение с позицией, где предшествующее не является exp. | |
| Комментарий | (?#comment) | Этот тип группировки не влияет на обработку регулярного выражения; он используется для предоставления комментариев для чтения людьми. |
Мы уже обсудили первые два синтаксиса. Третий(?:exp)не изменяет способ обработки регулярного выражения; просто содержимое, сопоставленное такой группой, не будет захвачено в группу, как в первых двух, и не получит номер группы."Зачем мне это делать?" -- Хороший вопрос, а как вы думаете?
Утверждения нулевой ширины
Следующие четыре используются для поиска того, что находится до или после определённого содержимого (но не включая это содержимое); то есть они как бы\b,^,$используются для указания позиции, и эта позиция должна удовлетворять определённому условию (то есть утверждению), поэтому их также называютутверждения нулевой ширины.Лучше всего проиллюстрировать примерами:
Примечание: утверждение используется для объявления факта, который должен быть истинным. В регулярном выражении сопоставление продолжается только тогда, когда утверждение истинно.
(?=exp)Также называетсяутверждением положительного просмотра вперёд нулевой ширины, оноутверждает, что после своей позиции может быть сопоставлено выражение exp.Например,\b\w+(?=ing\b), сопоставляетначальную часть слов, заканчивающихся на ing (часть, отличную от ing),например, при поискеI'm singing while you're dancing., оно найдётsingиdanc。
(?<=exp)Также называетсяутверждением положительного просмотра назад нулевой ширины, оноутверждает, что перед своей позицией может быть сопоставлено выражение exp.Например,(?<=\bre)\w+\bбудет совпадать составшейся частью слов, начинающихся с re (частью, отличной от re),, например, при поискеreading a book, он совпадаетading。
Если вы хотите добавлять запятую каждые три цифры в длинном числе (разумеется, начиная справа), вы можете использовать это, чтобы найти части, куда нужно добавить запятые перед и внутри:((?<=\d)\d{3})+\b, применив его к1234567890результат поиска таков234567890。
В следующем примере используются оба эти утверждения одновременно:(?<=\s)\d+(?=\s)Совпадение сцифрами, разделёнными пробельным символом (опять же, не включая пробельный символ)。
Негативные утверждения нулевой ширины
Ранее мы упоминали, как находитьсимволы, которые не являются определённым символом или не входят в определённый класс символовметод для символов (отрицание). Но если мы просто хотимубедиться, что определённый символ не появляется, но не хотим сопоставлять егочто нам делать? Например, если мы хотим найти слова, подобные этим -- они содержат букву q, но после q не следует буква u, мы можем попробовать это:
\b\w*q[^u]\w*\bСовпадение ссловами, содержащимибукву q, после которой не следует буква u.Но если вы проверите больше (или ваше мышление достаточно остро, чтобы увидеть это напрямую), вы обнаружите, что если q появляется в конце слова, например,Iraq,Benq, это выражение даст сбой. Это потому, что[^u]всегда должно сопоставляться с символом, так что если q — последний символ слова, следующее[^u]совпадёт с разделителем слова после q (которым может быть пробел, точка или что-то ещё), и следующее\w*\bсовпадёт со следующим словом, поэтому\b\w*q[^u]\w*\bможет совпасть со всей строкойIraq fighting。отрицательное утверждение нулевой шириныможет решить эту проблему, потому что оно сопоставляется только с позицией и непотреблятьлюбые символы. Теперь мы можем решить эту проблему так:\b\w*q(?!u)\w*\b。
отрицательное утверждение просмотра вперёд нулевой ширины(?!exp),утверждает, что после этой позиции выражение exp не может быть сопоставлено.Например:\d{3}(?!\d)Совпадение стремя цифрами, и после этих трёх цифр не может следовать цифра.;\b((?!abc)\w)+\bСопоставитьслова, которые не содержат непрерывную строку abc.。
Аналогично, мы можем использовать(?<!exp),утверждение негативного просмотра назад нулевой шириныприйтик утверждению, что перед этой позицией выражение exp не может быть сопоставлено.:(?<![a-z])\d{7}Сопоставитьсемь цифр, перед которыми нет строчной буквы.。
Более сложный пример:(?<=<(\w+)>).*(?=<\/\1>)Сопоставитьсодержимое внутри простых HTML-тегов, не содержащих атрибутов.。(?<=<(\w+)>)задаёт такойпрефикс:слово, заключённое в угловые скобки(например, возможно <b>), затем.*(произвольная строка), и наконецсуффикс(?=<\/\1>). Обратите внимание, что в суффиксе,\/, он использует экранирование символов, упомянутое ранее;\1является обратной ссылкой, ссылающейся точно напервую захваченную группу,сопоставленную предшествующим(\w+)содержимым, поэтому если префикс на самом деле <b>, то суффикс — </b>. Всё выражение соответствует содержимому между <b> и </b> (опять же, исключая сами префикс и суффикс).
Примечание: пожалуйста, проанализируйте выражение подробно(?<=<(\w+)>).*(?=<\/\1>); это выражение лучше всего демонстрирует истинное назначение утверждений нулевой ширины.
Комментарии
Ещё одно использование скобок — включать комментарии с помощью синтаксиса(?#comment). Например:2[0-4]\d(?#200-249)|25[0-5](?#250-255)|[01]?\d\d?(?#0-199)。
Если вы хотите включать комментарии, лучше всего включить опцию «игнорировать пробелы в шаблоне», чтобы при написании выражения вы могли свободно добавлять пробелы, табуляции и переводы строк, но при фактическом использовании все они будут игнорироваться. После включения этой опции весь текст от # до конца той строки будет игнорироваться как комментарий. Например, мы можем записать предыдущее выражение так:
      (?<=    # 断言要匹配的文本的前缀
      <(\w+)> # 查找尖括号括起来的字母或数字(即HTML/XML标签)
      )       # 前缀结束
      .*      # 匹配任意文本
      (?=     # 断言要匹配的文本的后缀
      <\/\1>  # 查找尖括号括起来的内容:前面是一个"/",后面是先前捕获的标签
      )       # 后缀结束
Жадные и ленивые
Когда регулярное выражение содержит квантификатор, допускающий повторение, обычное поведение состоит в том, чтобы (при условии, что всё выражение может быть сопоставлено) сопоставитькак можно большесимволов. Возьмём для примера это выражение:a.*b, оно сопоставитсамую длинную строку, которая начинается с a и заканчивается на b.Если вы используете его для поискаaabab, оно сопоставит всю строкуaabab. Это называетсяжаднымсопоставлением.
Иногда нам нужноленивоесопоставление, то есть сопоставлениекак можно меньшего числасимволов. Квантификаторы, приведённые ранее, можно преобразовать в режим ленивого сопоставления, добавив после них вопросительный знак?. Таким образом,.*?это означаетсопоставление любого числа повторений, но с использованием как можно меньшего числа повторений, при котором всё сопоставление всё ещё может успешно завершиться. Теперь рассмотрим пример ленивого варианта:
a.*?bСопоставитьсамую короткую строку, начинающуюся с a и заканчивающуюся на b. Если применить это кaabab, то будет сопоставленоaab (с первого по третий символ)иab (с четвёртого по пятый символ)。
Примечание: почему первое совпадение — aab (с первого по третий символ), а не ab (со второго по третий символ)? Проще говоря, потому что в регулярных выражениях есть ещё одно правило, имеющее более высокий приоритет, чем правило ленивого/жадного сопоставления: совпадение, которое начинается раньше всех, имеет наивысший приоритет — побеждает совпадение, которое начинается раньше всех.
| Код/Синтаксис | Описание |
|---|---|
| *? | Повторять любое число раз, но как можно меньше раз |
| +? | Повторять один или более раз, но как можно меньше раз |
| ?? | Повторять ноль или один раз, но как можно меньше раз |
| {n,m}? | Повторять от n до m раз, но как можно меньше раз |
| {n,}? | Повторять n или более раз, но как можно меньше раз |
Параметры обработки
Выше были представлены несколько параметров, таких как игнорирование регистра, обработка нескольких строк и т. д. Эти параметры можно использовать для изменения способа обработки регулярных выражений. Ниже перечислены распространённые параметры регулярных выражений в .Net:
| Name | Описание |
|---|---|
| IgnoreCase (игнорировать регистр) | Не учитывает регистр при сопоставлении. |
| Multiline (многострочный режим) | Изменяет^и$значение `^` и `$`, чтобы они соответствовали началу и концу любой строки соответственно, а не только началу и концу всей строки. (В этом режиме$точное значение `$` таково: соответствует позиции перед \n и позиции перед концом строки.) |
| Singleline (однострочный режим) | Изменяет.значение `.` так, чтобы он соответствовал любому символу (включая символ новой строки \n). |
| IgnorePatternWhitespace (игнорировать пробельные символы) | Игнорировать неэкранированные пробельные символы в выражении и включить#комментарии, помеченные `#`. |
| ExplicitCapture (явный захват) | Захватывать только группы, которые были явно именованы. |
Часто задаваемый вопрос: можно ли использовать одновременно только один из многострочного и однострочного режимов? Ответ: нет. Эти два параметра никак не связаны друг с другом, за исключением того, что их названия похожи (что сбивает с толку).
Примечание: В C# можно использоватьконструктор Regex(String, RegexOptions)чтобы задать параметры обработки регулярного выражения. Например: Regex regex = new Regex(@"\ba\w{6}\b", RegexOptions.IgnoreCase);
Сбалансированные группы / рекурсивное сопоставление
Примечание: Синтаксис сбалансированных групп, представленный здесь, поддерживается .Net Framework; другие языки/библиотеки могут не поддерживать эту возможность или поддерживать её, но требовать другого синтаксиса.
Иногда нам нужно сопоставить( 100 * ( 50 + 15 ) ) такие вложенные иерархические структуры, в этом случае простое использование\(.+\)сопоставит только содержимое между самой левой открывающей скобкой и самой правой закрывающей скобкой (здесь мы обсуждаем жадный режим; ленивый режим также имеет следующую проблему). Если количество левых и правых скобок в исходной строке не равно, например( 5 / ( 3 + 2 ) ) ), тогда количество тех и других в результате нашего сопоставления также не будет равно. Есть ли способ сопоставить самое длинное содержимое с парными скобками в такой строке?
Чтобы избежать того, что(и\(окончательно запутают ваш мозг, давайте использовать угловые скобки вместо круглых. Теперь наша задача становится такой: как захватитьxx <aa <bbb> <bbb> aa> yyсамое длинное содержимое с парными угловыми скобками в такой строке?
Здесь нужны следующие синтаксические конструкции:
- (?'group')Назвать захваченное содержимое группой group и поместить его встек (Stack)
- (?'-group')Извлечь из стека последнее захваченное содержимое с именем group, которое было в него помещено; если стек изначально был пуст, сопоставление этой группы завершается неудачей
- (?(group)yes|no)Если в стеке есть захват с именем group, продолжить сопоставление выражения в части yes; иначе продолжить сопоставление части no
- (?!)Утверждение нулевой ширины с отрицательным просмотром вперёд. Поскольку суффиксное выражение отсутствует, попытка сопоставления всегда терпит неудачу
Примечание: если вы не программист (или утверждаете, что вы программист, но не знаете, что такое стек), то понимайте три вышеуказанные синтаксические конструкции так: первая — записать «группу» на доске, вторая — стереть «группу» с доски, а третья — проверить, осталась ли ещё «группа», написанная на доске; если да, продолжайте сопоставление с частью «да», иначе сопоставляйте часть «нет».
Что нам нужно делать: каждый раз, когда мы встречаем левую круглую скобку, помещаем "Open" в стек; каждый раз, когда встречаем правую круглую скобку, извлекаем одну; в конце проверяем, пуст ли стек -- если он не пуст, это доказывает, что левых скобок больше, чем правых, и сопоставление должно завершиться неудачей. Механизм регулярных выражений выполнит возврат (отказавшись от некоторых символов в самом начале или конце), чтобы попытаться сопоставить всё выражение.
<                         #最外层的左括号
    [^<>]*                #最外层的左括号后面的不是括号的内容
    (
        (
            (?'Open'<)    #碰到了左括号,在黑板上写一个"Open"
            [^<>]*        #匹配左括号后面的不是括号的内容
        )+
        (
            (?'-Open'>)   #碰到了右括号,擦掉一个"Open"
            [^<>]*        #匹配右括号后面不是括号的内容
        )+
    )*
    (?(Open)(?!))         #在遇到最外层的右括号前面,判断黑板上还有没有没擦掉的"Open";如果还有,则匹配失败

>                         #最外层的右括号
Одно из самых распространённых применений сбалансированных групп — сопоставление HTML. Следующий пример может сопоставитьвложенные теги <div>:<div[^>]*>[^<>]*(((?'Open'<div[^>]*>)[^<>]*)+((?'-Open'</div>)[^<>]*)+)*(?(Open)(?!))</div>.
Что ещё не было упомянуто
Выше было описано много элементов для построения регулярных выражений, но всё ещё многое не упомянуто. Ниже приведён список неупомянутых элементов, включая синтаксис и краткие описания.
| Код/Синтаксис | Описание |
|---|---|
| \a | Символ звонка (при выводе заставляет компьютер один раз издать звуковой сигнал) |
| \b | Обычно позиция границы слова, но при использовании в классе символов обозначает backspace |
| \t | Символ табуляции, Tab |
| \r | Возврат каретки |
| \v | Вертикальная табуляция |
| \f | Подача страницы |
| \n | Символ новой строки |
| \e | Escape |
| \0nn | Символ с восьмеричным кодом nn в ASCII |
| \xnn | Символ с шестнадцатеричным кодом nn в ASCII |
| \unnnn | Символ с шестнадцатеричным кодом nnnn в Unicode |
| \cN | Управляющий символ ASCII. Например, \cC обозначает Ctrl+C |
| \A | Начало строки (аналогично ^, но не зависит от параметра обработки многострочного режима) |
| \Z | Конец строки или конец линии (не зависит от параметра обработки многострочного режима) |
| \z | Конец строки (аналогично $, но не зависит от параметра обработки многострочного режима) |
| \G | Начало текущего поиска |
| \p{name} | Класс символов с именем name в Unicode, например \p{IsGreek} |
| (?>exp) | Жадное подвыражение |
| (?<x>-<y>exp) | Сбалансированная группа |
| (?im-nsx:exp) | Изменяет параметры обработки в подвыражении exp |
| (?im-nsx) | Изменяет параметры обработки для части после выражения |
| (?(exp)yes|no) | Рассматривает exp как позитивную опережающую проверку нулевой ширины. Если она может совпасть в этой позиции, используйте yes как выражение для этой группы; в противном случае используйте no |
| (?(exp)yes) | То же, что выше, за исключением того, что пустое выражение используется как no |
| (?(name)yes|no) | Если группа с именем name захватила содержимое, используйте yes как выражение; в противном случае используйте no |
| (?(name)yes) | То же, что выше, за исключением того, что пустое выражение используется как no |
Другие руководства
Для более подробного руководства см.:Регулярные выражения — руководство
Источник: http://deerchao.net/tutorials/regex/regex.htm