Table des matières
- Objectif de cet article
- Comment utiliser ce tutoriel
- Qu'est-ce qu'une expression régulière, exactement ?
- Pour commencer
- Tester les expressions régulières
- Métacaractères
- Échappements de caractères
- Répétition
- Classes de caractères
- Conditions de branchement
- Négation
- Regroupement
- Références arrière
- Assertions de largeur nulle
- Assertions négatives de largeur nulle
- Commentaires
- Gourmand et paresseux
- Options de traitement
- Groupes équilibrés / Correspondance récursive
- Ce qui n'a pas encore été mentionné
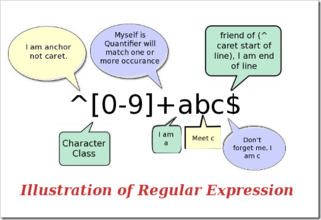
Objectif de cet article
En 30 minutes, vous faire comprendre ce qu'est une expression régulière et vous donner quelques bases à son sujet, afin que vous puissiez l'utiliser dans vos propres programmes ou pages web.
Comment utiliser ce tutoriel
Ne soyez pas intimidé par les expressions complexes ci-dessous. Suivez-moi simplement étape par étape, et vous découvrirez que les expressions régulières ne sont en fait pas aussi difficiles qu'on l'imagine. Bien sûr, si après avoir lu ce tutoriel vous avez l'impression de comprendre beaucoup de choses mais de ne presque rien retenir, c'est également normal — je pense que pour quelqu'un qui n'a jamais été exposé aux expressions régulières, la possibilité de retenir plus de 80% de la syntaxe mentionnée après avoir lu ce tutoriel est nulle. Ce n'est que pour vous faire comprendre les principes de base. Par la suite, vous devrez vous entraîner davantage et l'utiliser davantage afin de maîtriser les expressions régulières.
En plus d'être un tutoriel pour débutants, cet article tente également de devenir un manuel de référence pour la syntaxe des expressions régulières utilisable dans le travail quotidien. D'après l'expérience de l'auteur, cet objectif a été assez bien atteint — vous voyez, moi-même je n'ai pas pu tout mémoriser, n'est-ce pas ?
Qu'est-ce qu'une expression régulière, exactement ?
Lorsque vous écrivez des programmes ou des pages web qui traitent des chaînes de caractères, il est souvent nécessaire de trouver des chaînes qui correspondent à certaines règles complexes.Une expression régulièreest un outil utilisé pour décrire ces règles. En d’autres termes, une expression régulière est du code qui enregistre des règles textuelles.
Vous avez probablement utilisé celui sous Windows/DOS pour la recherche de fichiers :joker, c’est-à-dire*et?. Si vous voulez trouver tous les documents Word dans un répertoire, vous rechercheriez*.doc. Ici,*serait interprété comme n’importe quelle chaîne. Comme les jokers, les expressions régulières sont aussi des outils de correspondance de texte, sauf que, comparées aux jokers, elles peuvent décrire vos besoins plus précisément — bien sûr, au prix d’une plus grande complexité — par exemple, vous pouvez écrire une expression régulière pour trouvertoutes les chaînes qui commencent par 0, suivies de 2-3 chiffres, puis d’un trait d’union "-", et enfin de 7 ou 8 chiffres.(comme010-12345678ou0376-7654321).
Remarque : un caractèreest l’unité la plus fondamentale lorsqu’un logiciel informatique traite du texte. Il peut être une lettre, un chiffre, un signe de ponctuation, un espace, un caractère de nouvelle ligne, un caractère chinois, etc.Une chaîneest une séquence de zéro ou plusieurs caractères.Le texteest aussi des mots, des chaînes. Dire qu’une chaînecorrespond àune certaine expression régulière signifie généralement qu’une partie (ou plusieurs parties séparément) de cette chaîne peut satisfaire aux conditions données par l’expression.
Pour commencer
La meilleure façon d’apprendre les expressions régulières est de commencer par des exemples. Après avoir compris les exemples, modifiez-les et expérimentez-les vous-même. De nombreux exemples simples sont donnés ci-dessous avec des explications détaillées.
Supposons que vous recherchiezhidans un roman anglais, vous pouvez utiliser l’expression régulièrehi。
C’est presque l’expression régulière la plus simple. Elle peut correspondre exactement à une chaîne comme ceci :composée de deux caractères : le premier caractère est h, et le second est i.. Habituellement, les outils qui traitent les expressions régulières offrent une option pour ignorer la casse. Si cette option est sélectionnée, elle peut correspondre àhi,HI,Hi,hIn’importe laquelle de ces quatre variantes de casse.
Malheureusement, beaucoup de mots contiennenthices deux caractères consécutifs, commehim,history,highetc. En utilisanthipour rechercher, lehià l'intérieur d'eux sera aussi trouvé. Si vous vouleztrouver exactement le mot "hi", nous devrions utiliser\bhi\b。
\best un code spécial défini par les expressions régulières (eh bien, certains l'appellentmétacaractère), représentantle début ou la fin d'un mot, c'est-à-dire la limite d'un mot.. Bien que les mots anglais soient généralement séparés par des espaces, de la ponctuation ou des sauts de ligne,\bne correspond à aucun de ces caractères de séparation des mots ; ilcorrespond seulement à une position.。
Remarque : Si vous avez besoin d'une formulation plus précise,\bcorrespond à une position telle que son caractère précédent et son caractère suivant ne sont pas tous les deux des caractères de mot (l'un l'est, l'autre non, ou l'un n'existe pas).\w。
Si ce que vous voulez trouver est"hi" pas loin derrière suivi de "Lucy", vous devriez utiliser\bhi\b.*\bLucy\b。
Ici,.est un autre métacaractère qui correspond àtout caractère sauf les caractères de saut de ligne.。*est aussi un métacaractère, mais il ne représente pas un caractère ni une position ; il représente plutôt une quantité — il spécifie que *le contenu qui le précède peut être répété continuellement un nombre quelconque de fois pour que l'expression entière corresponde.. Par conséquent,.*lorsqu'ils sont reliés ensemble, cela signifieun nombre quelconque de caractères ne contenant pas de sauts de ligne.. Maintenant\bhi\b.*\bLucy\bla signification est très évidente :d'abord le mot "hi", puis un nombre quelconque de caractères quelconques (mais pas de sauts de ligne), et enfin le mot "Lucy".。
Remarque : Le caractère de saut de ligne est '\n', le caractère avec le code ASCII 10 (hexadécimal 0x0A).
Si nous utilisons d'autres métacaractères ensemble, nous pouvons construire des expressions régulières plus puissantes. Par exemple, l'exemple suivant :
0\d\d-\d\d\d\d\d\d\d\dFaire correspondre une chaîne comme ceci :commençant par 0, puis deux chiffres, puis un trait d'union « - », et enfin 8 chiffres.(Il s'agit d'un numéro de téléphone chinois. Bien sûr, cet exemple ne peut correspondre qu'au cas où l'indicatif régional comporte 3 chiffres).
Ici,\dest un nouveau métacaractère qui correspond àun seul chiffre (0, ou 1, ou 2, ou ...)。-n'est pas un métacaractère ; il ne correspond qu'à lui-même — le trait d'union (ou signe moins, ou tiret, ou peu importe comment vous l'appelez).
Pour éviter une répétition aussi pénible, nous pouvons aussi écrire cette expression comme ceci :0\d{2}-\d{8}. Ici\daprès le{2}({8}) signifie que le précédent\ddoit être répété et mis en correspondance de façon continue 2 fois (8 fois).。
Tester les expressions régulières
Si vous ne trouvez pas les expressions régulières difficiles à lire et à écrire, alors soit vous êtes un génie, soit vous n'êtes pas de la Terre. La syntaxe des expressions régulières est un casse-tête, même pour ceux qui les utilisent fréquemment. Parce qu'elles sont difficiles à lire et à écrire et sujettes aux erreurs, il est nécessaire de trouver un outil pour tester les expressions régulières.
Certains détails des expressions régulières diffèrent selon les environnements. Voici deux outils de test disponibles :
- RegexBuddy
- Outil de test en ligne d'expressions régulières JavaScript
Métacaractères
Maintenant, vous connaissez déjà plusieurs métacaractères très utiles, tels que\b,.,*, et\d. Il y a d'autres métacaractères dans les expressions régulières, par exemple\scorrespond àtout caractère d'espacement, y compris les espaces, les tabulations (Tab), les caractères de nouvelle ligne, les espaces pleine largeur chinois, etc.。\wcorrespond àdes lettres, des chiffres, des traits de soulignement ou des caractères chinois, etc.。
Remarque : La gestion spéciale du chinois/des caractères chinois est prise en charge par le moteur d'expressions régulières fourni par .NET. Pour des cas spécifiques dans d'autres environnements, veuillez vous référer à la documentation pertinente.
Regardons d'autres exemples ci-dessous :
\ba\w*\bcorrespond àdes mots commençant par la lettrea— d'abord au début d'un mot (\b), puis la lettrea, puis un nombre quelconque de lettres ou de chiffres (\w*), et enfin la fin du mot (\b)。
Remarque : Eh bien, parlons maintenant de ce que signifie un mot dans les expressions régulières : il s'agit d'un ou plusieurs\wconsécutifs. En effet, cela n'a vraiment pas grand-chose à voir avec les milliers de choses du même nom que vous avez dû mémoriser en apprenant l'anglais :)
\d+correspond à1 ou plusieurs chiffres consécutifs. Ici+est un métacaractère similaire à*, la différence étant que*correspond àrépété un nombre quelconque de fois (éventuellement zéro), tandis que+correspond àrépété une ou plusieurs fois。
\b\w{6}\bcorrespond àun mot d'exactement 6 caractères。
| Code | Description |
|---|---|
| . | Correspond à n'importe quel caractère sauf un saut de ligne |
| \w | Correspond à une lettre, un chiffre, un underscore ou un caractère chinois |
| \s | Correspond à n'importe quel caractère d'espacement |
| \d | Correspond à un chiffre |
| \b | Correspond au début ou à la fin d'un mot |
| ^ | Correspond au début d'une chaîne |
| $ | Correspond à la fin d'une chaîne |
Remarque : les moteurs d'expressions régulières fournissent généralement une méthode pour « tester si une chaîne spécifiée correspond à une expression régulière », comme RegExp.test() en JavaScript ou Regex.IsMatch() en .NET. La correspondance ici signifie s'il existe une partie de la chaîne qui respecte les règles de l'expression. Si vous n'utilisez pas^et$, alors pour\d{5,12}, l'utilisation d'une telle méthode garantit seulement que la chaînecontient de 5 à 12 chiffres consécutifs, plutôt que la chaîne entière soit composée de 5 à 12 chiffres.
Le métacaractère^(le symbole sur la même touche que le chiffre 6) et$correspondent tous deux à une position, ce qui est\bquelque peu similaire à^Correspond au début de la chaîne que vous recherchez,$correspond à la fin. Ces deux codes sont très utiles lors de la validation d'une saisie ; par exemple, si un site web exige que le numéro QQ que vous saisissez soit composé de 5 à 12 chiffres, vous pouvez utiliser :^\d{5,12}$。
Ceci{5,12}et le précédemment introduit{2}sont similaires, sauf que{2}correspond àrépété exactement 2 fois,{5,12}alors quele nombre de répétitions doit être au moins égal à 5 et au plus égal à 12, sinon il ne correspondra pas.
En raison de l'utilisation de^et$, la chaîne d'entrée entière doit être\d{5,12}utilisée pour la correspondance, c'est-à-dire que l'entrée entièredoit comporter de 5 à 12 chiffres, donc si le numéro QQ saisi peut correspondre à cette expression régulière, il satisfait à l'exigence.
Comme pour l'option insensible à la casse, certains outils de traitement des expressions régulières disposent également d'une option multiligne. Si cette option est sélectionnée,^et$la signification decorrespond au début et à la fin d'une ligne。
Échappements de caractères
Si vous souhaitez rechercher un métacaractère lui-même, par exemple vous recherchez., ou*, il y a un problème : vous ne pouvez pas les spécifier car ils seront interprétés comme quelque chose d'autre. Vous devez alors utiliser\pour annuler la signification spéciale de ces caractères. Par conséquent, vous devez utiliser\.et\*. Bien sûr, pour rechercher\lui-même, vous devez également utiliser\\.
Par exemple :deerchao\.netcorrespond àdeerchao.net,C:\\WindowscorrespondC:\Windows。
Répétition
Vous avez déjà vu les*,+,{2},{5,12}façons précédentes de faire correspondre une répétition. Voici tous les quantificateurs en regex (codes qui spécifient une quantité, tels que *, {5,12}, etc.) :
| Code/Syntaxe | Description |
|---|---|
| * | Répéter zéro ou plusieurs fois |
| + | Répéter une ou plusieurs fois |
| ? | Répéter zéro ou une fois |
| {n} | Répéter exactement n fois |
| {n,} | Répéter n fois ou plus |
| {n,m} | Répète entre n et m fois |
Voici quelques exemples de répétition :
Windows\d+correspond àWindows suivi d'un ou plusieurs chiffres
^\w+correspond aupremier mot d'une ligne (ou au premier mot de la chaîne entière ; le sens qui s'applique dépend des réglages des options)
Classes de caractères
Rechercher des chiffres, des lettres ou des chiffres, et des espaces blancs est simple, car il existe déjà des métacaractères pour ces ensembles de caractères, mais que faire si vous voulez faire correspondre un ensemble de caractères sans métacaractère prédéfini (comme les voyelles a, e, i, o, u) ?
Très simple : il suffit de les lister entre crochets, comme[aeiou]correspond àn'importe laquelle des voyelles anglaises,[.?!]correspond àun signe de ponctuation (. ou ? ou !)。
Nous pouvons aussi facilement spécifier uneplage de caractères, comme[0-9]la signification représentée par\dest exactement la même :un chiffre; de même[a-z0-9A-Z_]est aussi complètement équivalent à\w(si l'on ne considère que l'anglais).
Voici une expression plus complexe :\(?0\d{2}[) -]?\d{8}。
Remarque : « ( » et « ) » sont aussi des métacaractères ; dans la sectionde groupementultérieure, cela sera mentionné, donc ici vous devez utiliserl’échappement。
Cette expression peut correspondre àplusieurs formats de numéros de téléphone, tels que(010)88886666, ou022-22334455, ou02912345678, etc. Analysons-la : d'abord, c'est un caractère échappé\(, qui peut apparaître 0 ou 1 fois (?), puis un0, suivi de 2 chiffres (\d{2}), puis l'un de)ou-ouespace, qui apparaît 1 fois ou pas du tout (?), et enfin 8 chiffres (\d{8}).
Conditions de branchement
Malheureusement, cette expression précédente peut aussi correspondre à010)12345678ou(022-87654321un format « incorrect » comme celui-ci. Pour résoudre ce problème, nous devons utiliserdes conditions de branchement. Les conditions de branchement en regexconditions de branchementsignifient qu'il y a plusieurs règles, et si l'une d'elles est satisfaite, cela doit être considéré comme une correspondance. La méthode spécifique consiste à utiliser|pour séparer les différentes règles. Vous ne comprenez pas ? Peu importe, regardez l'exemple :
0\d{2}-\d{8}|0\d{3}-\d{7}Cette expression peutcorrespondre à deux types de numéros de téléphone séparés par un trait d'union : l'un est un indicatif régional à 3 chiffres avec un numéro local à 8 chiffres (comme 010-12345678), et l'autre est un indicatif régional à 4 chiffres avec un numéro local à 7 chiffres (0376-2233445)。
\(?0\d{2}\)?[- ]?\d{8}|0\d{2}[- ]?\d{8}Cette expressioncorrespond aux numéros de téléphone avec un indicatif régional à 3 chiffres, où l'indicatif régional peut être ou ne pas être entre parenthèses, et l'indicatif régional et le numéro local peuvent être séparés par un trait d'union ou un espace, ou ne pas avoir de séparateur. Vous pouvez essayer d'étendre cette expression pour prendre également en charge les indicatifs régionaux à 4 chiffres à l'aide de conditions de branchement.
\d{5}-\d{4}|\d{5}Cette expression est utilisée pour correspondre aux codes postaux américains. La règle des codes ZIP américains est 5 chiffres, ou 9 chiffres séparés par un trait d'union. La raison pour laquelle cet exemple est donné est qu'il illustre un problème :Lorsque vous utilisez des conditions de branchement, faites attention à l'ordre des conditions. Si vous le remplacez par\d{5}|\d{5}-\d{4}, alors il ne correspondra qu'aux codes postaux à 5 chiffres (et aux 5 premiers chiffres des codes postaux à 9 chiffres). La raison est que, lors de la correspondance des conditions de branchement, chaque condition est testée de gauche à droite ; si une branche est satisfaite, les autres conditions ne seront pas prises en compte.
Regroupement
Nous avons déjà mentionné comment répéter un seul caractère (il suffit d'ajouter un quantificateur directement après le caractère) ; mais que faire si vous voulez répéter plusieurs caractères ? Vous pouvez utiliser des parenthèses pour spécifierune sous-expression(également appeléun groupe), puis vous pouvez spécifier le nombre de répétitions pour cette sous-expression, et vous pouvez également effectuer d'autres opérations sur la sous-expression (décrites plus tard).
(\d{1,3}\.){3}\d{1,3}est uneexpression simple de correspondance d'adresse IP. Pour comprendre cette expression, analysez-la dans l'ordre suivant :\d{1,3}correspond à1 à 3 chiffres,(\d{1,3}\.){3}correspond àtrois chiffres plus un point anglais (l'ensemble est cegroupe) répété 3 fois, et enfin ajoutezun nombre de 1 à 3 chiffres(\d{1,3}).
Remarque : chaque nombre dans une adresse IP ne peut pas être supérieur à 255. On me demande souvent si les nombres avec des zéros initiaux, tels que 01.02.03.04, sont des adresses IP valides. La réponse est : oui, les nombres dans les adresses IP peuvent contenir des zéros initiaux (zéros de tête).
Malheureusement, il correspondra aussi à256.300.888.999ce genre d'adresse IP impossible. Si une comparaison arithmétique pouvait être utilisée, ce problème pourrait peut-être être résolu simplement, mais les expressions régulières ne fournissent aucune fonctionnalité mathématique, nous ne pouvons donc utiliser que des groupements longs, des alternances et des classes de caractères pour décrire une adresse IP correcte :((2[0-4]\d|25[0-5]|[01]?\d\d?)\.){3}(2[0-4]\d|25[0-5]|[01]?\d\d?)。
La clé pour comprendre cette expression est de comprendre2[0-4]\d|25[0-5]|[01]?\d\d?. Je n'entrerai pas dans les détails ici ; vous devriez pouvoir analyser vous-même sa signification.
Négation
Parfois, vous devez rechercher des caractères qui n'appartiennent pas à une classe de caractères simplement définie. Par exemple, lorsque vous voulez faire correspondre n'importe quel caractère autre que des chiffres, vous devez utiliserla négation:
| Code/Syntaxe | Description |
|---|---|
| \W | Correspond à tout caractère qui n'est pas une lettre, un chiffre, un trait de soulignement ou un caractère chinois |
| \S | Correspond à tout caractère qui n'est pas un caractère d'espacement |
| \D | Correspond à tout caractère non numérique |
| \B | Correspond à une position qui n'est ni le début ni la fin d'un mot |
| [^x] | Correspond à tout caractère sauf x |
| [^aeiou] | Correspond à tout caractère sauf les lettres a, e, i, o, u |
Exemple :\S+Correspond àune chaîne qui ne contient aucun caractère d'espacement。
<a[^>]+>Correspond àune chaîne encadrée par des chevrons qui commence par a。
Références arrière
Après avoir utilisé des parenthèses pour spécifier une sous-expression,le texte mis en correspondance par cette sous-expression(c'est-à-dire le contenu capturé par ce groupe) peut être traité davantage dans l'expression ou dans d'autres programmes. Par défaut, chaque groupe possède automatiquement unnuméro de groupe, et la règle est : de gauche à droite, en utilisant la parenthèse ouvrante du groupe comme marqueur, le premier groupe à apparaître a le numéro de groupe 1, le deuxième a 2, et ainsi de suite.
Euh... En fait, l'attribution des numéros de groupe n'est pas aussi simple que ce que je viens de dire :
- Le groupe 0 correspond à l'expression régulière entière.
- En fait, le processus d'attribution des numéros de groupe implique de parcourir deux fois de gauche à droite : la première passe attribue des numéros uniquement aux groupes sans nom, et la seconde passe attribue des numéros uniquement aux groupes nommés -- par conséquent, tous les groupes nommés ont des numéros de groupe supérieurs à ceux des groupes sans nom.
- Vous pouvez utiliser(?:exp)une syntaxe comme celle-ci pour empêcher un groupe de participer à l'attribution des numéros de groupe.
Une référence arrièreest utilisée pour rechercher de manière répétée le texte correspondant à un groupe précédent. Par exemple,\1représentele texte correspondant au groupe 1.Difficile à comprendre ? Voir l'exemple :
\b(\w+)\b\s+\1\bpeut être utilisé pour faire correspondredes mots répétés,commego go, oukitty kitty. Cette expression est d'abordun mot,c'est-à-dire,plus d'une lettre ou d'un chiffre entre le début et la fin d'un mot(\b(\w+)\b), ce mot sera capturé dans le groupe numéro 1, puisun ou plusieurs caractères d'espacement(\s+), et enfinle contenu capturé dans le groupe 1 (c'est-à-dire le mot mis en correspondance précédemment).(\1).
Vous pouvez également spécifier lenom de groupede la sous-expression. Pour spécifier un nom de groupe pour une sous-expression, utilisez cette syntaxe :(?<Word>\w+)(ou remplacez les chevrons par'est également acceptable :(?'Word'\w+)), cela fait\w+que le nom de groupe de [quelque chose] est spécifié commeWord. Pour faire une référence arrière à ce groupecapturécontenu, vous pouvez utiliser\k<Word>, donc l'exemple précédent peut aussi s'écrire :\b(?<Word>\w+)\b\s+\k<Word>\b。
Lors de l'utilisation de parenthèses, il existe de nombreuses autres syntaxes à usage spécial. Les plus courantes sont listées ci-dessous :
| Catégorie | Code/Syntaxe | Description |
|---|---|---|
| Capture | (exp) | Correspond à exp et capture le texte dans un groupe nommé automatiquement. |
| (?<name>exp) | Correspond à exp et capture le texte dans un groupe nommé name ; peut aussi s'écrire (?'name'exp). | |
| (?:exp) | Correspond à exp, ne capture pas le texte correspondant et n'attribue pas de numéro de groupe à ce groupe. | |
| Assertions de largeur nulle | (?=exp) | Correspond à la position avant exp. |
| (?<=exp) | Correspond à la position après exp. | |
| (?!exp) | Correspond à une position où ce qui suit n'est pas exp. | |
| (?<!exp) | Correspond à une position où ce qui précède n'est pas exp. | |
| Commentaire | (?#comment) | Ce type de groupement n'a aucun effet sur le traitement de l'expression régulière ; il sert à fournir des commentaires destinés à la lecture humaine. |
Nous avons déjà discuté des deux premières syntaxes. La troisième(?:exp)ne change pas la façon dont l'expression régulière est traitée ; simplement, le contenu mis en correspondance par un tel groupene sera pas capturé dans un groupe comme les deux premiers, et n'aura pas non plus de numéro de groupe.« Pourquoi voudrais-je faire cela ? » -- Bonne question, pourquoi à votre avis ?
Assertions de largeur nulle
Les quatre suivants servent à trouver des choses avant ou après un certain contenu (mais sans inclure ce contenu) ; c'est-à-dire qu'ils sont comme\b,^,$utilisés pour spécifier une position, et cette position doit satisfaire une certaine condition (c'est-à-dire une assertion), c'est pourquoi on les appelle aussiassertions de largeur nulle.Il est préférable d'utiliser des exemples pour illustrer :
Remarque : une assertion sert à déclarer un fait qui doit être vrai. Dans une expression régulière, la correspondance ne continue que lorsque l'assertion est vraie.
(?=exp)Aussi appeléeassertion d'anticipation positive de largeur nulle, elleaffirme qu'après sa propre position, l'expression exp peut être mise en correspondance.Par exemple,\b\w+(?=ing\b), correspond àla partie initiale des mots se terminant par ing (la partie autre que ing),comme lorsqu'on rechercheI'm singing while you're dancing., il correspondra àsingetdanc。
(?<=exp)Aussi appeléeassertion de rétrospection positive de largeur nulle, elleaffirme qu'avant sa propre position, l'expression exp peut être mise en correspondance.Par exemple,(?<=\bre)\w+\bcorrespondra àla partie finale des mots commençant par re (la partie autre que re),, par exemple, lors de la recherche dereading a book, il correspond àading。
Si vous voulez ajouter une virgule tous les trois chiffres dans un long nombre (bien sûr, en partant de la droite), vous pouvez utiliser ceci pour trouver les parties où des virgules doivent être ajoutées avant et à l'intérieur :((?<=\d)\d{3})+\b, en l'utilisant sur1234567890le résultat de la recherche est234567890。
L'exemple suivant utilise ces deux assertions en même temps :(?<=\s)\d+(?=\s)Correspond àdes chiffres séparés par un espace blanc (encore une fois, sans inclure l'espace blanc)。
Assertions négatives de largeur nulle
Plus tôt, nous avons mentionné comment trouverles caractères qui ne sont pas un certain caractère ou qui ne sont pas dans une certaine classe de caractèresméthode pour les caractères (négation). Mais si nous voulons justenous assurer qu'un certain caractère n'apparaît pas, mais sans vouloir le faire correspondreque devons-nous faire ? Par exemple, si nous voulons trouver des mots comme ceci -- ils contiennent la lettre q, mais q n'est pas suivi de la lettre u, nous pouvons essayer ceci :
\b\w*q[^u]\w*\bCorrespond àdes mots contenantla lettre q non suivie de la lettre u.Mais si vous testez davantage (ou votre réflexion est assez aiguisée pour le voir directement), vous constaterez que si q apparaît à la fin d'un mot, commeIraq,Benq, cette expression va mal se comporter. C'est parce que[^u]doit toujours correspondre à un caractère, donc si q est le dernier caractère d'un mot, ce qui suit[^u]correspondra au séparateur de mot après q (qui pourrait être un espace, un point ou autre chose), et ce qui suit\w*\bcorrespondra au mot suivant, donc\b\w*q[^u]\w*\bpeut correspondre à toutIraq fighting。l'assertion négative de largeur nullepeut résoudre ce problème, car elle ne correspond qu'à une position et neconsommeaucun caractère. Maintenant, nous pouvons résoudre ce problème comme ceci :\b\w*q(?!u)\w*\b。
assertion de lookahead négative de largeur nulle(?!exp),affirme qu'après cette position, l'expression exp ne peut pas être mise en correspondance.Par exemple :\d{3}(?!\d)Correspond àtrois chiffres, et ces trois chiffres ne peuvent pas être suivis d'un chiffre.;\b((?!abc)\w)+\bCorrespond auxmots qui ne contiennent pas la chaîne continue abc.。
De même, nous pouvons utiliser(?<!exp),l'assertion lookbehind négative de largeur nullepouraffirmer qu'avant cette position, l'expression exp ne peut pas être mise en correspondance.:(?<![a-z])\d{7}Correspondsept chiffres non précédés d'une lettre minuscule.。
Un exemple plus complexe :(?<=<(\w+)>).*(?=<\/\1>)Correspond àle contenu à l'intérieur de balises HTML simples qui ne contiennent pas d'attributs.。(?<=<(\w+)>)spécifie une tellepréfixe:un mot entre chevrons(comme éventuellement <b>), puis.*(une chaîne arbitraire), et enfin unsuffixe(?=<\/\1>). Notez que dans le suffixe,\/, il utilise l'échappement de caractères mentionné précédemment ;\1est une rétroréférence, faisant exactement référence àle premier groupe capturé,mis en correspondance par le(\w+)contenu précédent, donc si le préfixe est en fait <b>, alors le suffixe est </b>. L'expression entière correspond au contenu entre <b> et </b> (là encore, en excluant le préfixe et le suffixe eux-mêmes).
Remarque : veuillez analyser l'expression en détail(?<=<(\w+)>).*(?=<\/\1>); cette expression démontre le mieux le véritable objectif des assertions de largeur nulle.
Commentaires
Une autre utilisation des parenthèses est d'inclure des commentaires via la syntaxe(?#comment). Par exemple :2[0-4]\d(?#200-249)|25[0-5](?#250-255)|[01]?\d\d?(?#0-199)。
Si vous voulez inclure des commentaires, il est préférable d'activer l'option « ignorer les espaces blancs dans le motif », afin que, lors de l'écriture de l'expression, vous puissiez ajouter librement des espaces, des tabulations et des sauts de ligne, mais qu'en utilisation réelle tout cela sera ignoré. Après avoir activé cette option, tout le texte depuis # jusqu'à la fin de cette ligne sera ignoré en tant que commentaire. Par exemple, nous pouvons écrire une expression précédente comme ceci :
      (?<=    # 断言要匹配的文本的前缀
      <(\w+)> # 查找尖括号括起来的字母或数字(即HTML/XML标签)
      )       # 前缀结束
      .*      # 匹配任意文本
      (?=     # 断言要匹配的文本的后缀
      <\/\1>  # 查找尖括号括起来的内容:前面是一个"/",后面是先前捕获的标签
      )       # 后缀结束
Gourmand et paresseux
Lorsqu'une expression régulière contient un quantificateur qui peut accepter la répétition, le comportement habituel est (à condition que l'expression entière puisse être mise en correspondance) de faire correspondreautantde caractères que possible. Prenons cette expression comme exemple :a.*b, elle correspondra àla plus longue chaîne qui commence par a et se termine par b.Si vous l'utilisez pour rechercheraabab, elle correspondra à la chaîne entièreaabab. C'est ce qu'on appelle lemode gourmandde correspondance.
Parfois, nous avons besoin decorrespondanceparesseuse, c'est-à-dire de faire correspondreaussi peu decaractères que possible. Les quantificateurs donnés précédemment peuvent être convertis en mode de correspondance paresseuse en ajoutant un point d'interrogation après eux?. De cette façon,.*?cela signifiefaire correspondre un nombre quelconque de répétitions, mais en utilisant le moins de répétitions possible tout en permettant à la correspondance entière de réussir. Voyons maintenant un exemple de la version paresseuse :
a.*?bFaire correspondrela chaîne la plus courte commençant par a et se terminant par b. Si vous l'appliquez àaabab, il correspondra àaab (les caractères du premier au troisième)etab (les caractères du quatrième au cinquième)。
Remarque : pourquoi la première correspondance est-elle aab (les caractères du premier au troisième) plutôt que ab (les caractères du deuxième au troisième) ? En termes simples, parce que les expressions régulières ont une autre règle qui a une priorité plus élevée que la règle paresseuse/gourmande : la correspondance qui commence le plus tôt a la priorité la plus élevée — la correspondance qui commence le plus tôt gagne.
| Code/Syntaxe | Description |
|---|---|
| *? | Répéter un nombre quelconque de fois, mais le moins de fois possible |
| +? | Répéter une ou plusieurs fois, mais le moins de fois possible |
| ?? | Répéter zéro ou une fois, mais le moins de fois possible |
| {n,m}? | Répéter de n à m fois, mais le moins de fois possible |
| {n,}? | Répéter n fois ou plus, mais le moins de fois possible |
Options de traitement
Ce qui précède a introduit plusieurs options telles que l'ignorance de la casse, la gestion de plusieurs lignes, etc. Ces options peuvent être utilisées pour modifier la façon dont les expressions régulières sont traitées. Voici les options courantes des expressions régulières dans .Net :
| Name | Description |
|---|---|
| IgnoreCase (ignorer la casse) | Ne distingue pas la casse lors de la correspondance. |
| Multiline (mode multiligne) | Modifie^et$la signification de `^` et `$` afin qu'ils correspondent respectivement au début et à la fin de n'importe quelle ligne, et non plus seulement au début et à la fin de la chaîne entière. (Dans ce mode,$la signification exacte de `$` est : correspondre à la position avant \n et à la position avant la fin de la chaîne.) |
| Singleline (mode monoligne) | Modifie.la signification de `.` afin qu'il corresponde à chaque caractère (y compris le caractère de nouvelle ligne \n). |
| IgnorePatternWhitespace (ignorer les espaces blancs) | Ignore les espaces blancs non échappés dans l'expression et active#les commentaires marqués par `#`. |
| ExplicitCapture (capture explicite) | Capture uniquement les groupes qui ont été explicitement nommés. |
Une question fréquente est : peut-on n'utiliser qu'un seul des modes multiligne et monoligne à la fois ? La réponse est : non. Ces deux options n'ont rien à voir l'une avec l'autre, si ce n'est que leurs noms sont similaires (ce qui prête à confusion).
Remarque : en C#, vous pouvez utiliserle constructeur Regex(String, RegexOptions)pour définir les options de traitement d'une expression régulière. Par exemple : Regex regex = new Regex(@"\ba\w{6}\b", RegexOptions.IgnoreCase);
Groupes équilibrés / Correspondance récursive
Remarque : la syntaxe de groupe équilibré introduite ici est prise en charge par le .Net Framework ; d'autres langages/bibliothèques peuvent ne pas prendre en charge cette fonctionnalité, ou peuvent la prendre en charge mais nécessiter une syntaxe différente.
Parfois, nous devons faire correspondre( 100 * ( 50 + 15 ) ) de telles structures hiérarchiques imbriquables, à ce moment-là, une simple utilisation de\(.+\)ne correspondra qu'au contenu entre la parenthèse ouvrante la plus à gauche et la parenthèse fermante la plus à droite (ici nous parlons du mode gourmand ; le mode paresseux présente aussi le problème suivant). Si le nombre de parenthèses ouvrantes et fermantes dans la chaîne d'origine n'est pas égal, par exemple( 5 / ( 3 + 2 ) ) ), alors les nombres des deux dans notre résultat de correspondance ne seront pas non plus égaux. Existe-t-il un moyen de faire correspondre le contenu entre parenthèses appariées le plus long dans une telle chaîne ?
Afin d'éviter que(et\(ne vous embrouillent complètement le cerveau, utilisons des chevrons au lieu de parenthèses. Maintenant, notre problème devient : comment capturerxx <aa <bbb> <bbb> aa> yyle contenu entre chevrons appariés le plus long dans une telle chaîne ?
Les constructions syntaxiques suivantes sont nécessaires ici :
- (?'group')Nommez le contenu capturé comme group, et empilez-le surla pile (Stack)
- (?'-group')Dépilez le dernier contenu capturé nommé group qui a été empilé sur la pile ; si la pile était initialement vide, la correspondance de ce groupe échoue
- (?(group)yes|no)S'il y a une capture nommée group sur la pile, continuez à faire correspondre l'expression dans la partie yes ; sinon, continuez à faire correspondre la partie no
- (?!)Assertion d'anticipation négative de largeur nulle. Comme il n'y a pas d'expression suffixe, une tentative de correspondance échoue toujours
Note : Si vous n'êtes pas programmeur (ou si vous prétendez être programmeur mais ne savez pas ce qu'est une pile), comprenez alors les trois constructions syntaxiques ci-dessus de cette façon : la première consiste à écrire un « groupe » sur le tableau noir, la deuxième à effacer un « groupe » du tableau noir, et la troisième à voir s'il reste encore un « groupe » écrit sur le tableau noir ; s'il y en a un, continuez à faire correspondre la partie oui, sinon faites correspondre la partie non.
Ce que nous devons faire est : chaque fois que nous rencontrons une parenthèse ouvrante, empiler un "Open" ; chaque fois que nous rencontrons une parenthèse fermante, en dépiler un ; à la fin, voir si la pile est vide -- si elle n'est pas vide, cela prouve qu'il y a plus de parenthèses ouvrantes que de parenthèses fermantes, et la correspondance doit échouer. Le moteur de regex effectuera un retour arrière (en abandonnant certains caractères au tout début ou à la fin) pour essayer de faire correspondre l'expression entière.
<                         #最外层的左括号
    [^<>]*                #最外层的左括号后面的不是括号的内容
    (
        (
            (?'Open'<)    #碰到了左括号,在黑板上写一个"Open"
            [^<>]*        #匹配左括号后面的不是括号的内容
        )+
        (
            (?'-Open'>)   #碰到了右括号,擦掉一个"Open"
            [^<>]*        #匹配右括号后面不是括号的内容
        )+
    )*
    (?(Open)(?!))         #在遇到最外层的右括号前面,判断黑板上还有没有没擦掉的"Open";如果还有,则匹配失败

>                         #最外层的右括号
L'une des applications les plus courantes des groupes équilibrés est la correspondance HTML. L'exemple suivant peut correspondre auxbalises <div> imbriquées:<div[^>]*>[^<>]*(((?'Open'<div[^>]*>)[^<>]*)+((?'-Open'</div>)[^<>]*)+)*(?(Open)(?!))</div>.
Ce qui n'a pas encore été mentionné
Ce qui précède a décrit de nombreux éléments pour construire des expressions régulières, mais il reste encore beaucoup de choses non mentionnées. Ci-dessous se trouve une liste d'éléments non mentionnés, avec leur syntaxe et de brèves descriptions.
| Code/Syntaxe | Description |
|---|---|
| \a | Caractère de sonnerie (lorsqu'il est imprimé, il fait biper l'ordinateur une fois) |
| \b | Habituellement une position de limite de mot, mais s'il est utilisé dans une classe de caractères, il représente un retour arrière |
| \t | Caractère de tabulation, Tab |
| \r | Retour chariot |
| \v | Tabulation verticale |
| \f | Saut de page |
| \n | Caractère de saut de ligne |
| \e | Échap |
| \0nn | Caractère de code octal nn en ASCII |
| \xnn | Caractère de code hexadécimal nn en ASCII |
| \unnnn | Caractère de code hexadécimal nnnn en Unicode |
| \cN | Caractère de contrôle ASCII. Par exemple, \cC représente Ctrl+C |
| \A | Début de chaîne (similaire à ^, mais non affecté par l'option de gestion multiligne) |
| \Z | Fin de chaîne ou fin de ligne (non affectée par l'option de gestion multiligne) |
| \z | Fin de chaîne (similaire à $, mais non affectée par l'option de gestion multiligne) |
| \G | Début de la recherche actuelle |
| \p{name} | Classe de caractères nommée name en Unicode, par exemple \p{IsGreek} |
| (?>exp) | Sous-expression gloutonne |
| (?<x>-<y>exp) | Groupe équilibré |
| (?im-nsx:exp) | Modifier les options de traitement dans la sous-expression exp |
| (?im-nsx) | Modifier les options de traitement pour la partie qui suit l'expression |
| (?(exp)yes|no) | Traiter exp comme une assertion d'anticipation positive de largeur nulle. Si elle peut correspondre à cette position, utiliser yes comme expression pour ce groupe ; sinon, utiliser no |
| (?(exp)yes) | Identique à ci-dessus, sauf qu'une expression vide est utilisée comme no |
| (?(name)yes|no) | Si le groupe nommé name a capturé du contenu, utiliser yes comme expression ; sinon, utiliser no |
| (?(name)yes) | Identique à ci-dessus, sauf qu'une expression vide est utilisée comme no |
Plus de tutoriels
Pour un tutoriel plus détaillé, voir :Expression régulière - Tutoriel
Source : http://deerchao.net/tutorials/regex/regex.htm