Auswahl gängiger Feldtypen
1. Für Zeichentypen wird die Verwendung der Datentypen varchar/nvarchar empfohlen
2. Für Beträge/Währung wird die Verwendung des Datentyps money empfohlen
3. Für wissenschaftliche Notation wird die Verwendung des Datentyps numeric empfohlen
4. Für Auto-Inkrement-Identifikatoren wird die Verwendung des Datentyps bigint empfohlen (Wenn das Datenvolumen groß wird, kann der Typ int es nicht mehr aufnehmen, und zukünftige Änderungen wären mühsam)
5. Für Zeittypen wird die Verwendung des Datentyps datetime empfohlen
6. Die alten Datentypen text, ntext und image sind verboten
7. Der Datentyp xml, varchar(max) und nvarchar(max) sind verboten
Constraints und Indizes
Jede Tabelle muss einen Primärschlüssel haben
- Jede Tabelle muss einen Primärschlüssel haben, um die Entitätsintegrität durchzusetzen
- Eine einzelne Tabelle kann nur einen Primärschlüssel haben (NULL- und doppelte Daten sind nicht erlaubt)
- Versuchen Sie, Primärschlüssel mit einem einzigen Feld zu verwenden
Fremdschlüssel sind nicht erlaubt
- Fremdschlüssel erhöhen die Komplexität von Änderungen der Tabellenstruktur und der Datenmigration
- Fremdschlüssel beeinflussen die Einfüge- und Aktualisierungsleistung, und die Primär-/Fremdschlüsselbeschränkungen müssen überprüft werden
- Die Datenintegrität wird durch die Anwendung gesteuert
NULL-Attribut
Bei neu hinzugefügten Tabellen ist NULL für alle Felder verboten
(Warum sind NULLs in neuen Tabellen nicht erlaubt?
Das Zulassen von NULL-Werten erhöht die Komplexität der Anwendung. Sie müssen spezifischen Logikcode hinzufügen, um verschiedene unerwartete Fehler zu verhindern
Dreiwertige Logik: Alle Abfragen mit dem Gleichheitszeichen ("=") müssen eine ISNULL-Prüfung enthalten.
Null=Null, Null!=Null, not(Null=Null) und not(Null!=Null) sind alle unbekannt, nicht wahr)
Lassen Sie mich ein Beispiel zur Veranschaulichung geben:
Wenn die Daten in der Tabelle wie in der Abbildung dargestellt aussehen:
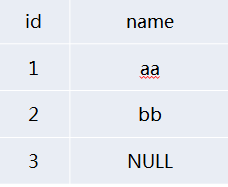
Wenn Sie alle Daten außer denen finden möchten, bei denen name gleich 'aa' ist, und dabei versehentlich SELECT * FROM NULLTEST WHERE NAME<>'aa' verwenden
Sie werden feststellen, dass das Ergebnis von dem abweicht, was Sie erwartet haben. Tatsächlich wird nur der Datensatz mit name=bb zurückgegeben und nicht der Datensatz mit name=NULL
Wie finden wir also alle Daten außer denen, bei denen name gleich 'aa' ist? Wir können nur die ISNULL-Funktion verwenden
SELECT * FROM NULLTEST WHERE ISNULL(NAME,1)<>'aa'
Aber Sie wissen vielleicht nicht, dassISNULL ernsthafte Leistungsengpässe verursachen kann, daher ist es in vielen Fällen am besten, Benutzereingaben auf Anwendungsebene einzuschränken, um sicherzustellen, dass Benutzer gültige Daten eingeben, bevor Abfragen ausgeführt werden.
Wenn neue Felder zu einer alten Tabelle hinzugefügt werden, müssen sie NULL sein dürfen (um Datenaktualisierungen der gesamten Tabelle und Blockierungen durch längerfristiges Halten von Sperren zu vermeiden)(Hierbei geht es hauptsächlich um das Problem, bestehende Tabellen zu ändern)
Richtlinien für das Indexdesign
- Indizes sollten auf Spalten erstellt werden, die häufig in WHERE-Klauseln verwendet werden.
- Indizes sollten für Spalten erstellt werden, die häufig zum Verknüpfen von Tabellen verwendet werden
- Indizes sollten für Spalten erstellt werden, die häufig in ORDER BY-Klauseln verwendet werden
- Indizes sollten nicht für kleine Tabellen erstellt werden (Tabellen, die nur wenige Seiten belegen), da ein vollständiger Tabellenscan schneller sein kann als eine Abfrage unter Verwendung eines Index
- Nicht mehr als 6 Indizes pro Tabelle
- Erstellen Sie keine Einspaltenindizes für Felder mit geringer Selektivität
- Nutzen Sie UNIQUE-Constraints voll aus
- Indizes sollten nicht mehr als 5 Felder enthalten (einschließlich eingeschlossener Spalten)
Erstellen Sie keine Einspaltenindizes für Felder mit geringer Selektivität
- SQL Server hat Anforderungen an die Selektivität indizierter Felder. Wenn die Selektivität zu niedrig ist, verzichtet SQL Server auf deren Verwendung
- Felder, die nicht für die Erstellung von Indizes geeignet sind: Geschlecht, 0/1, TRUE/FALSE
- Felder, die für die Erstellung von Indizes geeignet sind: ORDERID, UID usw.
Nutzen Sie UNIQUE-Indizes voll aus
UNIQUE-Indizes liefern SQL Server Informationen, die sicherstellen, dass eine bestimmte Spalte absolut keine doppelten Werte enthält. Wenn der Abfrageanalysator über einen UNIQUE-Index einen Datensatz findet, bricht er sofort ab und durchsucht den Index nicht weiter
Nicht mehr als 6 Indizes pro Tabelle
Nicht mehr als 6 Indizes pro Tabelle (Diese Regel wurde gerade von Ctrip-DBAs nach Experimenten aufgestellt...)
- Indizes beschleunigen die Abfrageleistung, beeinflussen jedoch die Schreibleistung
- Die Indizes einer Tabelle sollten umfassend auf Grundlage aller SQL-Anweisungen erstellt werden, die sich auf diese Tabelle beziehen, und sollten so weit wie möglich zusammengeführt werden
- Das Prinzip zusammengesetzter Indizes besteht darin, dass Felder mit besserer Filterwirkung weiter vorn platziert werden sollten
- Zu viele Indizes erhöhen nicht nur die Kompilierungszeit, sondern beeinflussen auch die Auswahl des besten Ausführungsplans durch die Datenbank
SQL-Abfragen
- Komplexe Operationen in der Datenbank sind verboten
- Die Verwendung von SELECT * ist verboten
- Die Verwendung von Funktionen oder Berechnungen auf indizierten Spalten ist verboten
- Die Verwendung von Cursorn ist verboten
- Die Verwendung von Triggern ist verboten
- Die Angabe von Indizes in Abfragen ist verboten
- Variablen-/Parameter-/Join-Feldtypen müssen mit dem Feldtyp übereinstimmen
- Parametrisierte Abfragen
- Anzahl der JOINs begrenzen
- Länge von SQL-Anweisungen und Anzahl der Bedingungen in der IN-Klausel begrenzen
- Große Transaktionsvorgänge möglichst vermeiden
- Rückgabe der Information über die Anzahl betroffener Zeilen deaktivieren
- Sofern nicht erforderlich, müssen alle SELECT-Anweisungen NOLOCK enthalten
- UNION ALL statt UNION verwenden
- Bei Abfragen großer Datenmengen Paginierung oder TOP verwenden
- Begrenzung der rekursiven Abfrageebene
- NOT EXISTS statt NOT IN verwenden
- Temporäre Tabellen und Tabellenvariablen
- Verwenden Sie lokale Variablen, um einen moderaten Ausführungsplan zu wählen
- Versuchen Sie, die Verwendung des OR-Operators zu vermeiden
- Fügen Sie Mechanismen zur Behandlung von Transaktionsausnahmen hinzu
- Ausgabespalten verwenden ein zweiteiliges Benennungsformat
Komplexe Operationen in der Datenbank sind verboten
- XML-Parsing
- Vergleich der Ähnlichkeit von Zeichenfolgen
- Zeichenfolgensuche (CHARINDEX)
- Komplexe Operationen werden auf der Anwendungsseite ausgeführt
Die Verwendung von SELECT * ist verboten
- Reduzieren Sie den Speicherverbrauch und die Netzwerkbandbreite
- Geben Sie dem Abfrageoptimierer die Möglichkeit, die erforderlichen Spalten aus dem Index zu lesen
- Wenn sich die Tabellenstruktur ändert, kann dies leicht zu Abfragefehlern führen
Die Verwendung von Funktionen oder Berechnungen auf indizierten Spalten ist verboten
In der WHERE-Klausel: Wenn der Index Teil einer Funktion ist, verwendet der Optimierer den Index nicht mehr und führt stattdessen einen vollständigen Tabellenscan durch
Angenommen, es gibt einen Index auf Feld Col1, dann können die folgenden Szenarien den Index nicht verwenden:
ABS[Col1]=1
[Col1]+1>9
Lassen Sie mich ein weiteres Beispiel geben
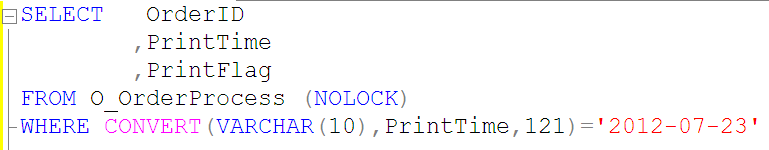
Eine Abfrage wie die oben genannte kann den PrintTime-Index in der Tabelle O_OrderProcess nicht verwenden, daher sollten wir die unten gezeigte SQL-Abfrage verwenden
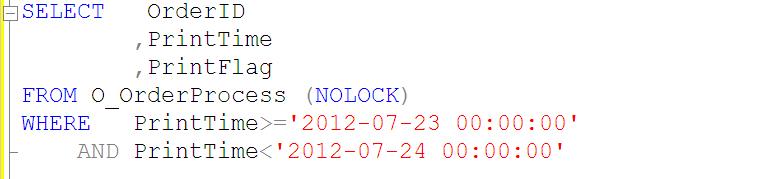
Die Verwendung von Funktionen oder Berechnungen auf indizierten Spalten ist verboten
Angenommen, es gibt einen Index auf Feld Col1, dann können die folgenden Szenarien den Index verwenden:
[Col1]=3.14
[Col1]>100
[Col1] BETWEEN 0 AND 99
[Col1] LIKE 'abc%'
[Col1] IN(2,3,5,7)
Indexprobleme bei LIKE-Abfragen
1. [Col1] LIKE "abc%" – Index Seek. Dies verwendet einen Index Seek.
2. [Col1] LIKE "%abc%" – Index Scan. Dies verwendet jedoch keinen Index Seek.
3.[Col1] like “%abc” – Index Scan. Dies verwendet ebenfalls keine indexbasierte Abfrage.
An den drei obigen Beispielen sollte jeder verstehen, dass es am besten ist, keine unscharfe Übereinstimmung vor der LIKE-Bedingung zu verwenden, da sonst keine indexbasierte Abfrage verwendet werden kann.
Die Verwendung von Cursorn ist verboten
Relationale Datenbanken eignen sich für Mengenoperationen, das heißt für die Durchführung von Mengenoperationen auf der durch die WHERE-Klausel und ausgewählte Spalten bestimmten Ergebnismenge. Cursor bieten eine Möglichkeit für Nicht-Mengenoperationen. Im Allgemeinen ist die durch Cursor implementierte Funktionalität oft äquivalent zu dem, was eine clientseitige Schleife implementiert.
Cursor legen die Ergebnismenge in den Serverspeicher und verarbeiten Datensätze einzeln in einer Schleife, was sehr viele Datenbankressourcen verbraucht (insbesondere Speicher- und Sperrressourcen).
(Außerdem sind Cursor ehrlich gesagt ziemlich komplex und nicht sehr benutzerfreundlich, daher sollte man sie so wenig wie möglich verwenden.)
Die Verwendung von Triggern ist verboten
Trigger sind für die Anwendung intransparent (die Anwendungsschicht hat keine Ahnung, wann ein Trigger ausgelöst wird, noch weiß sie, wann er ausgelöst wurde – es erscheint unerklärlich ...)
Die Angabe von Indizes in Abfragen ist verboten
With(index=XXX) (In Abfragen verwenden wir im Allgemeinen With(index=XXX), wenn wir einen Index angeben)
- Wenn sich Daten ändern, bietet der durch die Abfrageanweisung angegebene Index möglicherweise nicht mehr die beste Leistung.
- Indizes sollten für die Anwendung transparent sein. Wenn beispielsweise der angegebene Index gelöscht wird, führt dies zu Abfragefehlern, was der Fehlersuche nicht zuträglich ist.
- Neu erstellte Indizes können von der Anwendung nicht sofort verwendet werden; sie werden erst nach der Bereitstellung des Codes wirksam.
Variablen-/Parameter-/Join-Feldtypen müssen mit dem Feldtyp übereinstimmen (Darauf habe ich früher nicht besonders geachtet)
Vermeiden Sie den zusätzlichen CPU-Verbrauch durch Typkonvertierung; besonders schwerwiegend sind die dadurch ausgelösten großen Tabellenscans.
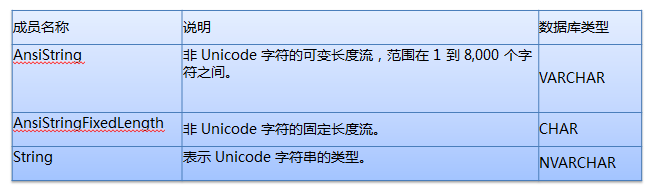
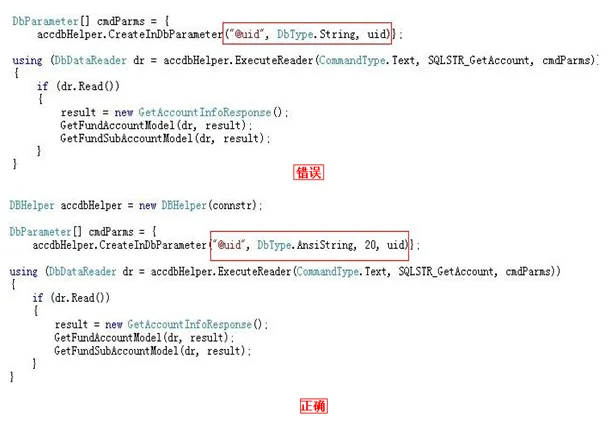
Wenn ich mir die beiden obigen Abbildungen ansehe, denke ich, muss ich nicht weiter erklären – das sollte allen bereits klar sein.
Wenn der Datenbankfeldtyp VARCHAR ist, sollte der Typ in der Anwendung am besten als AnsiString angegeben und seine Länge explizit angegeben werden.
Wenn der Datenbankfeldtyp CHAR ist, sollte der Typ in der Anwendung am besten als AnsiStringFixedLength angegeben und seine Länge explizit angegeben werden.
Wenn der Datenbankfeldtyp NVARCHAR ist, sollte der Typ in der Anwendung am besten als String angegeben und seine Länge explizit angegeben werden.
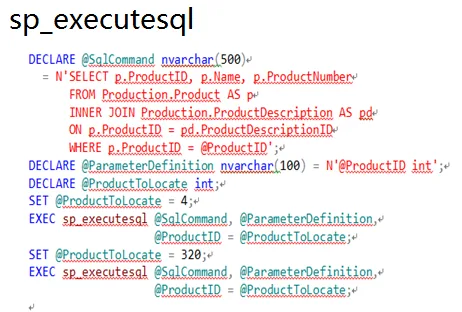
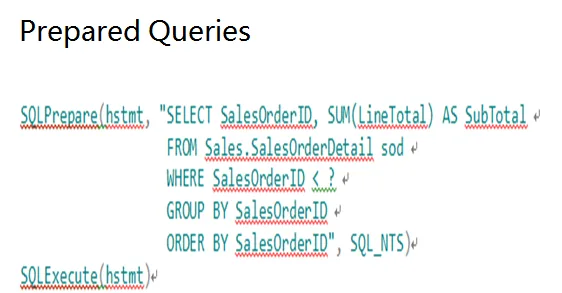
Parametrisierte Abfragen
Die folgenden Methoden können verwendet werden, um Abfrage-SQL zu parametrisieren:
sp_executesql
Prepared Queries
Gespeicherte Prozeduren
Lassen Sie es mich mit einer Abbildung veranschaulichen, haha.
Anzahl der JOINs begrenzen
- Die Anzahl der Tabellen-JOINs in einer einzelnen SQL-Anweisung darf 5 nicht überschreiten.
- Zu viele JOINs können dazu führen, dass der Abfrage-Analyzer einen falschen Ausführungsplan wählt.
- Zu viele JOINs verbrauchen viel beim Kompilieren des Ausführungsplans.
Begrenzen Sie die Anzahl der Bedingungen in IN-Klauseln
Wenn eine sehr große Anzahl von Werten (Tausende) in die IN-Klausel aufgenommen wird, kann dies Ressourcen verbrauchen und den Fehler 8623 oder 8632 zurückgeben. Die Anzahl der Bedingungen in der IN-Klausel muss auf höchstens 100 begrenzt werden.
Große Transaktionsvorgänge möglichst vermeiden
- Starten Sie eine Transaktion nur, wenn Daten aktualisiert werden müssen, wodurch die Haltedauer von Ressourcensperren verringert wird.
- Fügen Sie einen Vorverarbeitungsmechanismus zum Abfangen von Transaktionsausnahmen hinzu.
- Verteilte Transaktionen auf der Datenbank sind verboten.
Lassen Sie es mich anhand einer Abbildung veranschaulichen.
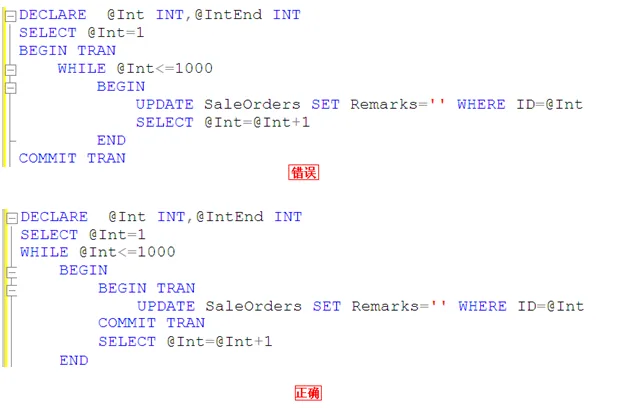
Das heißt, wir sollten COMMIT TRAN nicht erst ausführen, nachdem alle 1000 Datenzeilen aktualisiert wurden. Denken Sie darüber nach – während Sie diese tausend Zeilen aktualisieren, belegen Sie da nicht exklusiv Ressourcen und verhindern, dass andere Transaktionen verarbeitet werden können?
Rückgabe der Information über die Anzahl betroffener Zeilen deaktivieren
Setzen Sie "Set Nocount On" explizit in SQL-Anweisungen, um die Rückgabe von Informationen zur Anzahl betroffener Zeilen zu unterdrücken und den Netzwerkverkehr zu reduzieren.
Sofern nicht erforderlich, müssen alle SELECT-Anweisungen NOLOCK enthalten.
Sofern nicht erforderlich, versuchen Sie, allen SELECT-Anweisungen NOLOCK hinzuzufügen.
Gibt an, dass Dirty Reads zulässig sind. Es werden keine Shared Locks ausgegeben, um andere Transaktionen daran zu hindern, Daten zu ändern, die von der aktuellen Transaktion gelesen werden, und Exclusive Locks, die von anderen Transaktionen gesetzt werden, hindern die aktuelle Transaktion nicht daran, die gesperrten Daten zu lesen. Das Zulassen von Dirty Reads kann mehr gleichzeitige Vorgänge ermöglichen, aber der Preis dafür ist, dass Datenänderungen gelesen werden, die später von anderen Transaktionen zurückgerollt werden. Dies kann Fehler in Ihrer Transaktion verursachen, Daten anzeigen, die nie für Benutzer committet wurden, oder dazu führen, dass Benutzer Datensätze doppelt sehen (oder Datensätze überhaupt nicht sehen).
Verwenden Sie UNION ALL, um UNION zu ersetzen.
UNION ALL statt UNION verwenden
UNION dedupliziert und sortiert die SQL-Ergebnismenge, was den CPU-, Speicher- und sonstigen Verbrauch erhöht.
Bei Abfragen großer Datenmengen Paginierung oder TOP verwenden
Begrenzen Sie die Anzahl zurückgegebener Datensätze angemessen, um Engpässe bei IO und Netzwerkbandbreite zu vermeiden.
Begrenzung der rekursiven Abfrageebene
Verwenden Sie MAXRECURSION, um zu verhindern, dass unangemessene rekursive CTEs in Endlosschleifen geraten.
Temporäre Tabellen und Tabellenvariablen
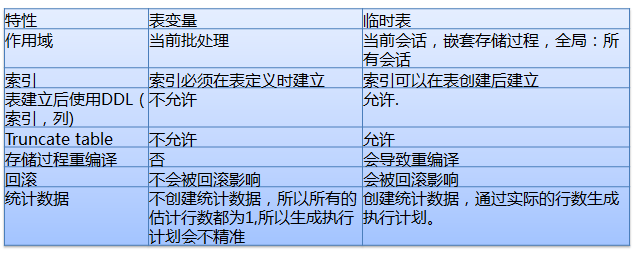
Verwenden Sie lokale Variablen, um einen moderaten Ausführungsplan zu wählen
Wenn in einer gespeicherten Prozedur oder Abfrage auf eine Tabelle mit einer sehr ungleichmäßigen Datenverteilung zugegriffen wird, führt dies häufig dazu, dass die gespeicherte Prozedur oder Abfrage einen suboptimalen oder sogar schlechten Ausführungsplan verwendet, was zu Problemen wie hoher CPU-Auslastung und einer großen Anzahl von IO Reads führt. Verwenden Sie lokale Variablen, um die Wahl des falschen Ausführungsplans zu verhindern.
Beim Ansatz mit lokalen Variablen kennt SQL den Wert der lokalen Variablen zur Kompilierungszeit nicht. Zu diesem Zeitpunkt "rät" SQL einen Rückgabewert basierend auf der allgemeinen Verteilung der Daten in der Tabelle. Unabhängig davon, welchen Variablenwert der Benutzer beim Aufrufen der gespeicherten Prozedur oder Anweisung übergibt, ist der generierte Plan derselbe. Ein solcher Plan ist im Allgemeinen moderater – er ist möglicherweise nicht der optimale Plan, aber in der Regel auch nicht der schlechteste Plan.
Wenn die lokale Variable in der Abfrage einen Ungleichheitsoperator verwendet, nutzt der Abfrageanalysator eine einfache 30%-Formel zur Schätzung.
Geschätzte Zeilen =(Gesamtzeilen * 30)/100
Wenn die lokale Variable in der Abfrage einen Gleichheitsoperator verwendet, nutzt der Abfrageanalysator: Präzision * Gesamtzahl der Tabellendatensätze zur Schätzung.
Geschätzte Zeilen = Dichte * Gesamtzeilen
Versuchen Sie, die Verwendung des OR-Operators zu vermeiden
Bei OR-Operatoren wird normalerweise ein vollständiger Tabellenscan verwendet. Erwägen Sie, die Abfrage in mehrere Abfragen aufzuteilen, die mit UNION/UNION ALL implementiert werden. Hier müssen Sie bestätigen, dass die Abfrage einen Index verwenden und eine kleinere Ergebnismenge zurückgeben kann.
Fügen Sie Mechanismen zur Behandlung von Transaktionsausnahmen hinzu
Die Anwendung sollte Ausnahmen ordnungsgemäß behandeln und rechtzeitig ein Rollback durchführen.
Legen Sie die Verbindungseigenschaft "set xact_abort on" fest.
Ausgabespalten verwenden ein zweiteiliges Benennungsformat
Zweiteiliges Benennungsformat: TableName.ColumnName
In TSQL mit JOIN-Beziehungen müssen Felder angeben, zu welcher Tabelle sie gehören. Andernfalls können nach zukünftigen Änderungen der Tabellenstruktur Kompatibilitätsfehler im Programm wie "Ambiguous column name" auftreten.
Architekturdesign
- Lese-/Schreibtrennung
- Schema-Entkopplung
- Datenlebenszyklus
Lese-/Schreibtrennung
- Erwägen Sie die Lese-/Schreibtrennung von Anfang an im Design, selbst wenn Lese- und Schreibvorgänge dieselbe Datenbank verwenden – dies ist vorteilhaft für eine schnelle Skalierung.
- Teilen Sie Lesevorgänge entsprechend ihren Lesemerkmalen in Echtzeit-Lesevorgänge und aufschiebbare Lesevorgänge auf, die jeweils der Schreibdatenbank und der Lesedatenbank entsprechen.
- Bei der Lese-/Schreibtrennung sollte in Betracht gezogen werden, automatisch auf die Schreibseite umzuschalten, wenn Lesevorgänge nicht verfügbar sind.
Schema-Entkopplung
Datenbankübergreifende JOINs sind verboten.
Datenlebenszyklus
Basierend auf der Häufigkeit der Datennutzung sollten große Tabellen regelmäßig in separate Datenbanken archiviert werden.
Die Primärdatenbank und die Archivdatenbank physisch trennen.
Log-Tabellen sollten partitioniert oder in mehrere Tabellen aufgeteilt werden
Große Tabellen sollten partitioniert werden. Die Partitionierung verteilt Tabellen und Indizes über mehrere Partitionen. Durch Partitionswechsel können alte und neue Partitionen schnell ersetzt werden, wodurch die Datenbereinigung beschleunigt und der Verbrauch von IO-Ressourcen stark reduziert wird.
Tabellen mit häufigen Schreibvorgängen müssen partitioniert oder in mehrere Tabellen aufgeteilt werden
Auto-Inkrement und Latch-Sperre
Latch-Sperren werden von SQL Server selbst angefordert und intern gesteuert; Benutzer haben keine Möglichkeit, einzugreifen. Sie dienen dazu, die Konsistenz von Datenstrukturen im Speicher sicherzustellen, und die Sperrebene ist eine Sperre auf Seitenebene.
Quelle: http://www.codeceo.com/article/sql-server-tips.html