Выбор распространённых типов полей
1. Для символьных типов рекомендуется использовать типы данных varchar/nvarchar
2. Для сумм/денежных значений рекомендуется использовать тип данных money
3. Для научной нотации рекомендуется использовать тип данных numeric
4. Для автоинкрементных идентификаторов рекомендуется использовать тип данных bigint (Когда объём данных станет большим, тип int не сможет их вместить, а будущие изменения окажутся проблематичными)
5. Для типов времени рекомендуется использовать тип данных datetime
6. Старые типы данных text, ntext и image запрещены
7. Тип данных xml, varchar(max) и nvarchar(max) запрещены
Ограничения и индексы
Каждая таблица должна иметь первичный ключ
- Каждая таблица должна иметь первичный ключ для обеспечения целостности сущностей
- Одна таблица может иметь только один первичный ключ (значения NULL и дубликаты данных не допускаются)
- Старайтесь использовать первичные ключи из одного поля
Внешние ключи не допускаются
- Внешние ключи увеличивают сложность изменения структуры таблиц и миграции данных
- Внешние ключи влияют на производительность вставки и обновления, и необходимо проверять ограничения первичного/внешнего ключа
- Целостность данных контролируется приложением
Атрибут NULL
Для вновь добавленных таблиц NULL запрещён для всех полей
(Почему NULL не допускаются в новых таблицах?
Разрешение значений NULL увеличивает сложность приложения. Необходимо добавить специальный логический код, чтобы предотвратить различные неожиданные ошибки
Трёхзначная логика: все запросы со знаком равенства ("=") должны включать проверку ISNULL.
Null=Null, Null!=Null, not(Null=Null) и not(Null!=Null) — все они имеют значение «неизвестно», а не «истина»)
Приведу пример для пояснения:
Если данные в таблице такие, как показано на рисунке:
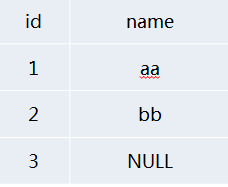
Если вы хотите найти все данные, кроме тех, где name равно 'aa', и случайно используете SELECT * FROM NULLTEST WHERE NAME<>'aa'
Вы обнаружите, что результат отличается от ожидаемого. Фактически он возвращает только запись с name=bb и не возвращает запись с name=NULL
Итак, как найти все данные, кроме тех, где name равно 'aa'? Можно использовать только функцию ISNULL
SELECT * FROM NULLTEST WHERE ISNULL(NAME,1)<>'aa'
Но вы можете не знать, чтоISNULL может вызывать серьёзные узкие места производительности, поэтому во многих случаях лучше ограничивать ввод пользователя на уровне приложения, гарантируя, что пользователи вводят допустимые данные перед выполнением запросов.
При добавлении новых полей в старую таблицу для них нужно разрешить значение NULL (чтобы избежать обновления данных всей таблицы и блокирования, вызванного длительным удержанием блокировки)(Здесь в основном рассматривается вопрос изменения существующих таблиц)
Рекомендации по проектированию индексов
- Индексы следует создавать по столбцам, которые часто используются в условиях WHERE
- Индексы следует создавать на столбцах, часто используемых для соединения таблиц
- Индексы следует создавать на столбцах, часто используемых в предложениях ORDER BY
- Не следует создавать индексы на небольших таблицах (таблицах, занимающих всего несколько страниц), потому что полное сканирование таблицы может быть быстрее, чем запрос с использованием индекса
- Не более 6 индексов на таблицу
- Не создавайте одностолбцовые индексы на полях с низкой селективностью
- Максимально используйте уникальные ограничения
- Индексы должны содержать не более 5 полей (включая включённые столбцы)
Не создавайте одностолбцовые индексы на полях с низкой селективностью
- SQL Server предъявляет требования к селективности индексируемых полей. Если селективность слишком низкая, SQL Server откажется от использования индекса
- Поля, не подходящие для создания индексов: gender, 0/1, TRUE/FALSE
- Поля, подходящие для создания индексов: ORDERID, UID и т. д.
Максимально используйте уникальные индексы
Уникальные индексы предоставляют SQL Server информацию, гарантирующую, что определённый столбец абсолютно не имеет повторяющихся значений. Когда анализатор запросов находит одну запись через уникальный индекс, он немедленно завершает работу и не продолжает поиск по индексу
Не более 6 индексов на таблицу
Не более 6 индексов на таблицу (Это правило было только что установлено DBA Ctrip после экспериментов...)
- Индексы ускоряют выполнение запросов, но влияют на производительность записи
- Индексы таблицы должны создаваться комплексно на основе всех SQL-запросов, относящихся к этой таблице, и по возможности объединяться
- Принцип составных индексов состоит в том, что поля с лучшей фильтрацией должны располагаться раньше
- Слишком много индексов не только увеличивают время компиляции, но и влияют на выбор базой данных наилучшего плана выполнения
SQL-запросы
- Сложные операции в базе данных запрещены
- Использование SELECT * запрещено
- Использование функций или вычислений над индексированными столбцами запрещено
- Использование курсоров запрещено
- Использование триггеров запрещено
- Указание индексов в запросах запрещено
- Типы переменных/параметров/полей соединения должны совпадать с типом поля
- Параметризованные запросы
- Ограничивайте количество JOIN
- Ограничивайте длину SQL-инструкций и количество условий в IN
- Старайтесь избегать операций с крупными транзакциями
- Отключите возврат информации о количестве затронутых строк
- Если нет необходимости, все SELECT-запросы должны включать NOLOCK
- Используйте UNION ALL вместо UNION
- Используйте постраничную выборку или TOP при запросе больших объемов данных
- Ограничение уровня рекурсивных запросов
- Используйте NOT EXISTS вместо NOT IN
- Временные таблицы и табличные переменные
- Используйте локальные переменные для выбора умеренного плана выполнения
- Старайтесь избегать использования оператора OR
- Добавьте механизмы обработки исключений транзакций
- Выходные столбцы используют двухчастный формат именования
Сложные операции в базе данных запрещены
- Разбор XML
- Сравнение схожести строк
- Поиск строки (CHARINDEX)
- Сложные операции выполняются на стороне приложения
Использование SELECT * запрещено
- Сократите потребление памяти и сетевую пропускную способность
- Дайте оптимизатору запросов возможность читать нужные столбцы из индекса
- При изменении структуры таблицы это может легко привести к ошибкам запросов
Использование функций или вычислений над индексированными столбцами запрещено
В предложении WHERE, если индекс является частью функции, оптимизатор больше не будет использовать индекс и вместо этого выполнит полное сканирование таблицы
Предполагая, что существует индекс по полю Col1, следующие сценарии не смогут использовать индекс:
ABS[Col1]=1
[Col1]+1>9
Приведу ещё один пример
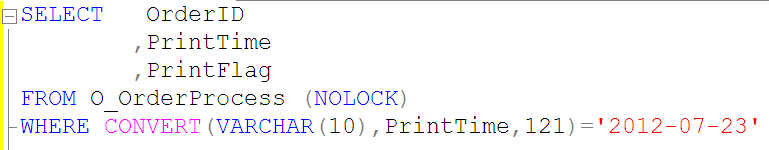
Запрос, подобный приведённому выше, не сможет использовать индекс PrintTime в таблице O_OrderProcess, поэтому следует использовать SQL-запрос, показанный ниже
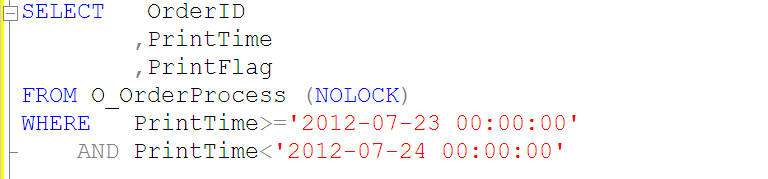
Использование функций или вычислений над индексированными столбцами запрещено
Предполагая, что существует индекс по полю Col1, следующие сценарии смогут использовать индекс:
[Col1]=3.14
[Col1]>100
[Col1] BETWEEN 0 AND 99
[Col1] LIKE 'abc%'
[Col1] IN(2,3,5,7)
Проблемы с индексами в LIKE-запросах
1. [Col1] LIKE "abc%" – поиск по индексу. Здесь используется поиск по индексу.
2. [Col1] LIKE "%abc%" – сканирование индекса. Но здесь не используется поиск по индексу.
3.[Col1] like “%abc” – сканирование индекса. Здесь также не используется поиск по индексу.
Из трёх примеров выше всем должно быть понятно, что лучше не использовать нечёткое сопоставление перед условием LIKE, иначе нельзя будет использовать поиск по индексу.
Использование курсоров запрещено
Реляционные базы данных подходят для операций над множествами, то есть для выполнения операций над множествами над результирующим набором, определяемым предложением WHERE и выбранными столбцами. Курсоры предоставляют средство для операций, не являющихся операциями над множествами. В общем, функциональность, реализуемая курсорами, часто эквивалентна тому, что реализует цикл на стороне клиента.
Курсоры помещают результирующий набор в память сервера и обрабатывают записи одну за другой в цикле, что потребляет огромное количество ресурсов базы данных (особенно памяти и ресурсов блокировок).
(Кроме того, курсоры, честно говоря, довольно сложны и не очень удобны, поэтому используйте их как можно реже.)
Использование триггеров запрещено
Триггеры непрозрачны для приложения (уровень приложения не знает, когда сработает триггер, и не знает, когда он сработал — это кажется необъяснимым...)
Указание индексов в запросах запрещено
With(index=XXX) (В запросах, когда мы указываем индекс, мы обычно используем With(index=XXX))
- По мере изменения данных индекс, указанный в запросе, может перестать обеспечивать наилучшую производительность.
- Индексы должны быть прозрачны для приложения. Например, если указанный индекс удалён, это приведёт к ошибкам запросов, что не способствует устранению неполадок.
- Только что созданные индексы не могут использоваться приложением сразу; они вступают в силу только после развёртывания кода.
Типы переменных/параметров/полей JOIN должны совпадать с типом поля (Раньше я не уделял этому особого внимания)
Избегайте дополнительного потребления CPU, вызванного преобразованием типов; особенно серьёзны вызываемые им сканирования больших таблиц.
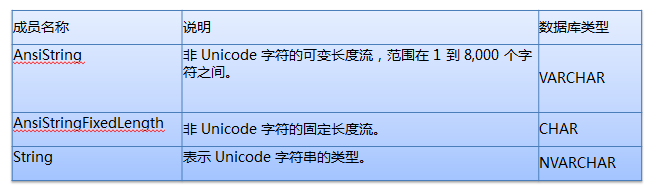
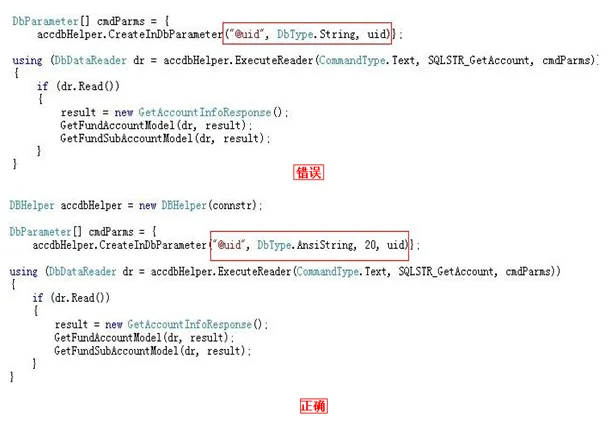
Глядя на два рисунка выше, думаю, мне не нужно объяснять дальше — всем уже должно быть ясно.
Если тип поля базы данных — VARCHAR, лучше всего указать в приложении тип AnsiString и явно задать его длину.
Если тип поля базы данных — CHAR, лучше всего указать в приложении тип AnsiStringFixedLength и явно задать его длину.
Если тип поля базы данных — NVARCHAR, лучше всего указать в приложении тип String и явно задать его длину.
Параметризованные запросы
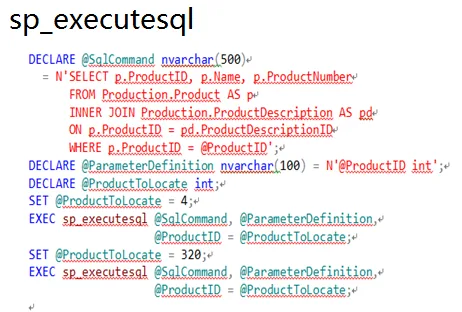
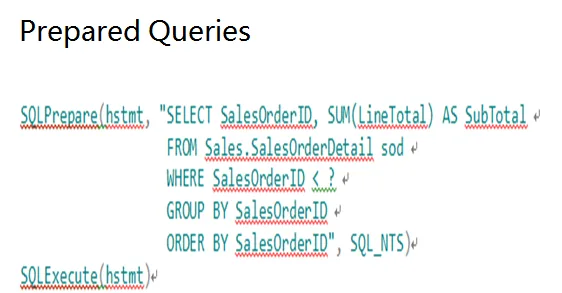
Для параметризации SQL-запроса можно использовать следующие способы:
sp_executesql
Подготовленные запросы
Хранимые процедуры
Позвольте проиллюстрировать это рисунком, ха-ха.
Ограничивайте количество JOIN
- Количество JOIN таблиц в одном SQL-запросе не должно превышать 5.
- Слишком много JOINs может привести к тому, что анализатор запросов выберет неправильный план выполнения.
- Слишком много JOINs потребляют много ресурсов при компиляции плана выполнения.
Ограничьте количество условий в IN-предложениях
Включение очень большого количества значений (тысяч) в IN-предложение может потреблять ресурсы и возвращать ошибку 8623 или 8632. Количество условий в IN-предложении должно быть ограничено 100.
Старайтесь избегать операций с крупными транзакциями
- Начинайте транзакцию только тогда, когда данные нужно обновить, сокращая время удержания блокировок ресурсов.
- Добавьте механизм предварительной обработки для перехвата исключений транзакций.
- Распределённые транзакции в базе данных запрещены.
Позвольте проиллюстрировать это с помощью рисунка.
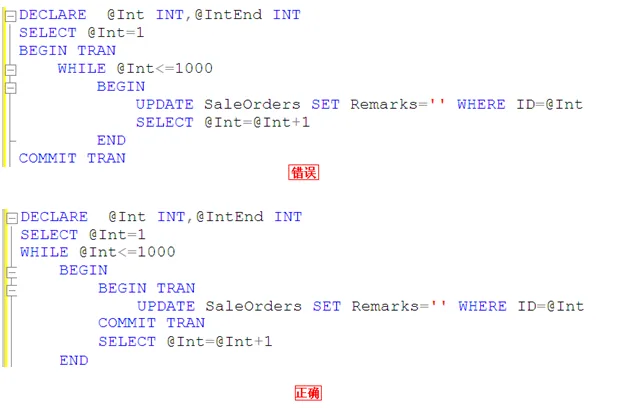
То есть мы не должны выполнять COMMIT TRAN только после того, как все 1000 строк данных были обновлены. Подумайте — пока вы обновляете эту тысячу строк, не занимаете ли вы монопольно ресурсы, из-за чего другие транзакции не могут обрабатываться?
Отключите возврат информации о количестве затронутых строк
Явно устанавливайте "Set Nocount On" в SQL-инструкциях, чтобы отменить возврат информации о количестве затронутых строк и уменьшить сетевой трафик.
За исключением случаев, когда это необходимо, все инструкции SELECT должны содержать NOLOCK.
За исключением случаев, когда это необходимо, старайтесь добавлять NOLOCK во все инструкции SELECT.
Указывает, что разрешены «грязные» чтения. Разделяемые блокировки не выдаются, чтобы другие транзакции не могли изменять данные, читаемые текущей транзакцией, а монопольные блокировки, установленные другими транзакциями, не помешают текущей транзакции читать заблокированные данные. Разрешение «грязных» чтений может обеспечить больше параллельных операций, но ценой является чтение изменений данных, которые позже будут откатаны другими транзакциями. Это может вызвать ошибки в вашей транзакции, показать пользователям данные, которые никогда не были зафиксированы, или привести к тому, что пользователи увидят записи дважды (или вообще не увидят записей).
Используйте UNION ALL вместо UNION.
Используйте UNION ALL вместо UNION
UNION удаляет дубликаты и сортирует результирующий набор SQL, увеличивая потребление CPU, памяти и других ресурсов.
Используйте постраничную выборку или TOP при запросе больших объемов данных
Разумно ограничивайте количество возвращаемых записей, чтобы избежать узких мест в IO и пропускной способности сети.
Ограничение уровня рекурсивных запросов
Используйте MAXRECURSION, чтобы не допустить зацикливания необоснованных рекурсивных CTE.
Временные таблицы и табличные переменные
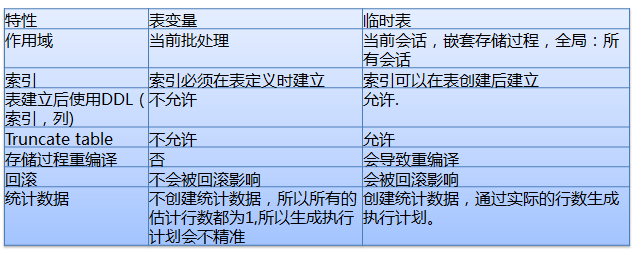
Используйте локальные переменные для выбора умеренного плана выполнения
В хранимой процедуре или запросе, если происходит обращение к таблице с очень неравномерным распределением данных, это часто приводит к тому, что хранимая процедура или запрос используют неоптимальный или даже плохой план выполнения, что вызывает такие проблемы, как высокая загрузка CPU и большое количество IO Reads. Используйте локальные переменные, чтобы не допустить выбора неправильного плана выполнения.
При подходе с локальной переменной SQL не знает значения локальной переменной во время компиляции. В этот момент SQL будет «угадывать» возвращаемое значение на основе общего распределения данных в таблице. Независимо от значения переменной, которое пользователь передает при вызове хранимой процедуры или инструкции, сгенерированный план будет одним и тем же. Такой план обычно более умеренный — он может не быть оптимальным планом, но, как правило, не будет и худшим планом.
Если локальная переменная в запросе использует оператор неравенства, анализатор запросов использует простую формулу 30% для оценки.
Estimated Rows =(Total Rows * 30)/100
Если локальная переменная в запросе использует оператор равенства, анализатор запросов использует: точность * общее количество записей таблицы для оценки.
Оценочное количество строк = Плотность * Общее количество строк
Старайтесь избегать использования оператора OR
Для операторов OR обычно используется полное сканирование таблицы. Рассмотрите разделение запроса на несколько запросов, реализованных с помощью UNION/UNION ALL. Здесь необходимо убедиться, что запрос может использовать индекс и возвращать меньший результирующий набор.
Добавьте механизмы обработки исключений транзакций
Приложение должно корректно обрабатывать исключения и своевременно выполнять Rollback.
Задайте свойство подключения "set xact_abort on".
Выходные столбцы используют двухчастный формат именования
Формат именования из двух частей: TableName.ColumnName
В TSQL при связях JOIN поля должны указывать, к какой таблице они принадлежат. В противном случае после будущих изменений структуры таблиц могут возникнуть ошибки совместимости программы, такие как "Ambiguous column name".
Проектирование архитектуры
- Разделение чтения и записи
- Разделение схемы
- Жизненный цикл данных
Разделение чтения и записи
- Рассмотрите разделение чтения и записи с самого начала проектирования, даже если чтение и запись используют одну и ту же базу данных — это полезно для быстрого масштабирования.
- В соответствии с характеристиками чтения разделите чтения на чтения в реальном времени и отложенные чтения, соответствующие базе данных записи и базе данных чтения соответственно.
- При разделении чтения и записи следует предусмотреть автоматическое переключение на сторону записи, когда чтение недоступно.
Разделение схемы
JOIN между базами данных запрещены.
Жизненный цикл данных
На основе частоты использования данных периодически архивируйте большие таблицы в отдельные базы данных.
Физически разделите основную базу данных и архивную базу данных.
Таблицы типа журнала следует секционировать или разбивать на несколько таблиц
Большие таблицы следует секционировать. Секционирование распределяет таблицы и индексы по нескольким разделам. С помощью переключения разделов можно быстро заменять старые и новые разделы, ускоряя очистку данных и значительно снижая потребление ресурсов IO.
Таблицы с частой записью нужно секционировать или разбивать на несколько таблиц
Автоинкремент и Latch Lock
Latch-блокировки запрашиваются и контролируются внутри самого SQL Server; пользователи не имеют возможности вмешиваться. Они используются для обеспечения согласованности структур данных в памяти, а уровень блокировки — блокировка на уровне страницы.
Источник: http://www.codeceo.com/article/sql-server-tips.html