Sélection des types de champs courants
1. Pour les types caractères, il est recommandé d'utiliser les types de données varchar/nvarchar
2. Pour les montants/devises, il est recommandé d'utiliser le type de données money
3. Pour la notation scientifique, il est recommandé d'utiliser le type de données numeric
4. Pour les identifiants à incrémentation automatique, il est recommandé d'utiliser le type de données bigint (Lorsque le volume de données devient important, le type int ne pourra pas le contenir, et les modifications futures seraient problématiques)
5. Pour les types de temps, il est recommandé d'utiliser le type de données datetime
6. Les anciens types de données text, ntext et image sont interdits
7. Le type de données xml, ainsi que varchar(max) et nvarchar(max), sont interdits
Contraintes et index
Chaque table doit avoir une clé primaire
- Chaque table doit avoir une clé primaire pour garantir l'intégrité d'entité
- Une table ne peut avoir qu'une seule clé primaire (les données NULL et les doublons ne sont pas autorisés)
- Essayez d'utiliser des clés primaires à champ unique
Les clés étrangères ne sont pas autorisées
- Les clés étrangères augmentent la complexité des modifications de la structure des tables et de la migration des données
- Les clés étrangères affectent les performances d'insertion et de mise à jour, et les contraintes de clés primaires/étrangères doivent être vérifiées
- L'intégrité des données est contrôlée par l'application
Attribut NULL
Pour les tables nouvellement ajoutées, NULL est interdit pour tous les champs
(Pourquoi les NULL ne sont-ils pas autorisés dans les nouvelles tables ?
Autoriser les valeurs NULL augmente la complexité de l'application. Vous devez ajouter du code logique spécifique pour éviter divers bugs inattendus
Logique à trois valeurs : toutes les requêtes avec le signe égal ("=") doivent inclure une vérification ISNULL.
Null=Null, Null!=Null, not(Null=Null), et not(Null!=Null) sont tous inconnus, pas vrai)
Laissez-moi donner un exemple pour illustrer :
Si les données de la table sont comme indiqué dans la figure :
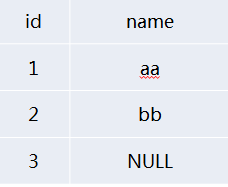
Si vous voulez trouver toutes les données sauf celles où name est égal à 'aa', et que vous utilisez par inadvertance SELECT * FROM NULLTEST WHERE NAME<>'aa'
Vous constaterez que le résultat est différent de ce que vous attendiez. En fait, il ne renvoie que l'enregistrement avec name=bb et ne renvoie pas l'enregistrement avec name=NULL
Alors comment trouver toutes les données sauf celles où name est égal à 'aa' ? Nous ne pouvons utiliser que la fonction ISNULL
SELECT * FROM NULLTEST WHERE ISNULL(NAME,1)<>'aa'
Mais vous ne savez peut-être pas queISNULL peut causer de sérieux goulots d'étranglement de performance, donc dans de nombreux cas, il est préférable de restreindre la saisie de l'utilisateur au niveau de l'application, en veillant à ce que les utilisateurs saisissent des données valides avant d'effectuer des requêtes.
Lors de l'ajout de nouveaux champs à une ancienne table, ils doivent être autorisés à être NULL (pour éviter les mises à jour de données sur toute la table et le blocage causé par la détention de verrous à long terme)(Cela considère principalement le problème de la modification des tables existantes)
Directives de conception d'index
- Des index doivent être créés sur les colonnes fréquemment utilisées dans les clauses WHERE
- Les index doivent être créés sur les colonnes fréquemment utilisées pour joindre des tables
- Les index doivent être créés sur les colonnes fréquemment utilisées dans les clauses ORDER BY
- Les index ne doivent pas être créés sur les petites tables (tables qui n'utilisent que quelques pages), car une analyse complète de la table peut être plus rapide qu'une requête utilisant un index
- Pas plus de 6 index par table
- Ne créez pas d'index à colonne unique sur les champs à faible sélectivité
- Tirez pleinement parti des contraintes d'unicité
- Les index ne doivent pas contenir plus de 5 champs (y compris les colonnes incluses)
Ne créez pas d'index à colonne unique sur les champs à faible sélectivité
- SQL Server a des exigences concernant la sélectivité des champs indexés. Si la sélectivité est trop faible, SQL Server renoncera à l'utiliser
- Champs non adaptés à la création d'index : sexe, 0/1, TRUE/FALSE
- Champs adaptés à la création d'index : ORDERID, UID, etc.
Tirez pleinement parti des index uniques
Les index uniques fournissent à SQL Server des informations garantissant qu'une colonne donnée ne comporte absolument aucune valeur en double. Lorsque l'analyseur de requêtes trouve un enregistrement via un index unique, il s'arrête immédiatement et ne continue pas à parcourir l'index
Pas plus de 6 index par table
Pas plus de 6 index par table (Cette règle vient d'être établie par les DBA de Ctrip après expérimentation...)
- Les index accélèrent les performances des requêtes, mais ils affectent les performances d'écriture
- Les index d'une table doivent être créés de manière exhaustive en fonction de toutes les instructions SQL liées à cette table, et doivent être fusionnés autant que possible
- Le principe des index composites est que les champs offrant un meilleur filtrage doivent être placés en premier
- Trop d'index augmentent non seulement le temps de compilation, mais affectent aussi la sélection du meilleur plan d'exécution par la base de données
Requêtes SQL
- Les opérations complexes dans la base de données sont interdites
- L'utilisation de SELECT * est interdite
- L'utilisation de fonctions ou de calculs sur des colonnes indexées est interdite
- L'utilisation de curseurs est interdite
- L'utilisation de déclencheurs est interdite
- La spécification d'index dans les requêtes est interdite
- Les types de variable/paramètre/champ de jointure doivent correspondre au type du champ
- Requêtes paramétrées
- Limiter le nombre de JOINs
- Limiter la longueur des instructions SQL et le nombre de conditions dans la clause IN
- Essayer d'éviter les opérations de transaction volumineuses
- Désactiver le renvoi des informations sur le nombre de lignes affectées
- Sauf si nécessaire, toutes les instructions SELECT doivent inclure NOLOCK
- Utiliser UNION ALL au lieu de UNION
- Utiliser la pagination ou TOP lors de l'interrogation de grandes quantités de données
- Limite du niveau de requête récursive
- Utiliser NOT EXISTS au lieu de NOT IN
- Tables temporaires et variables de table
- Utiliser des variables locales pour choisir un plan d'exécution modéré
- Essayer d'éviter d'utiliser l'opérateur OR
- Ajouter des mécanismes de gestion des exceptions de transaction
- Les colonnes de sortie utilisent un format de nommage en deux parties
Les opérations complexes dans la base de données sont interdites
- Analyse XML
- Comparaison de similarité de chaînes
- Recherche de chaîne (CHARINDEX)
- Les opérations complexes sont effectuées du côté de l'application
L'utilisation de SELECT * est interdite
- Réduire la consommation de mémoire et la bande passante réseau
- Donner à l'optimiseur de requêtes la possibilité de lire les colonnes requises à partir de l'index
- Lorsque la structure de la table change, cela peut facilement entraîner des erreurs de requête
L'utilisation de fonctions ou de calculs sur des colonnes indexées est interdite
Dans la clause WHERE, si l'index fait partie d'une fonction, l'optimiseur n'utilisera plus l'index et effectuera à la place un balayage complet de table
En supposant qu'il existe un index sur le champ Col1, les scénarios suivants ne pourront pas utiliser l'index :
ABS[Col1]=1
[Col1]+1>9
Je vais donner un autre exemple
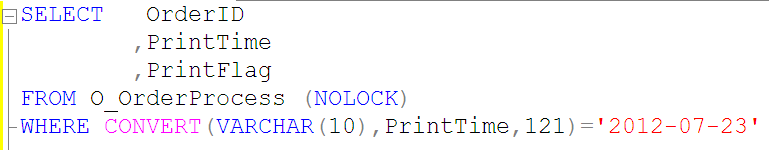
Une requête comme celle ci-dessus ne pourra pas utiliser l'index PrintTime sur la table O_OrderProcess, donc nous devrions utiliser la requête SQL indiquée ci-dessous
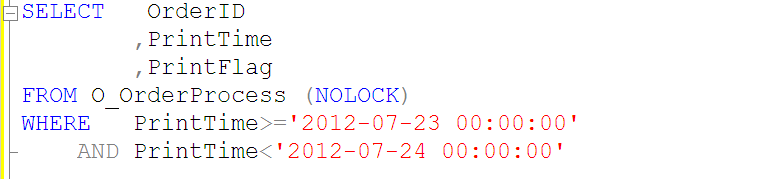
L'utilisation de fonctions ou de calculs sur des colonnes indexées est interdite
En supposant qu'il existe un index sur le champ Col1, les scénarios suivants pourront utiliser l'index :
[Col1]=3.14
[Col1]>100
[Col1] BETWEEN 0 AND 99
[Col1] LIKE 'abc%'
[Col1] IN(2,3,5,7)
Problèmes d'index avec les requêtes LIKE
1. [Col1] LIKE "abc%" – recherche d'index. Cela utilise une recherche d'index
2. [Col1] LIKE "%abc%" – analyse d'index. Mais cela n'utilise pas de recherche d'index
3.[Col1] like “%abc” – analyse d'index. Cela n'utilise pas non plus d'interrogation basée sur un index.
À partir des trois exemples ci-dessus, chacun devrait comprendre qu'il vaut mieux ne pas utiliser de correspondance floue avant la condition LIKE, sinon l'interrogation basée sur un index ne peut pas être utilisée.
L'utilisation de curseurs est interdite
Les bases de données relationnelles sont adaptées aux opérations d'ensemble, c'est-à-dire effectuer des opérations d'ensemble sur le jeu de résultats déterminé par la clause WHERE et les colonnes sélectionnées. Les curseurs fournissent un moyen d'opérations non ensemblistes. En général, la fonctionnalité implémentée par les curseurs est souvent équivalente à ce qu'implémente une boucle côté client.
Les curseurs placent le jeu de résultats dans la mémoire du serveur et traitent les enregistrements un par un via une boucle, ce qui consomme énormément de ressources de la base de données (en particulier la mémoire et les ressources de verrouillage).
(De plus, les curseurs sont honnêtement assez complexes et peu conviviaux, alors utilisez-les le moins possible.)
L'utilisation de déclencheurs est interdite
Les déclencheurs sont opaques pour l'application (la couche applicative n'a aucune idée du moment où un déclencheur va se déclencher, ni ne sait quand il s'est déclenché—cela semble inexplicable...)
La spécification d'index dans les requêtes est interdite
With(index=XXX) (Dans les requêtes, lorsque nous spécifions un index, nous utilisons généralement With(index=XXX))
- À mesure que les données changent, l'index spécifié par l'instruction de requête peut ne plus offrir les meilleures performances.
- Les index doivent être transparents pour l'application. Par exemple, si l'index spécifié est supprimé, cela provoquera des erreurs de requête, ce qui n'est pas propice au dépannage.
- Les index nouvellement créés ne peuvent pas être utilisés immédiatement par l'application ; ils ne prennent effet qu'après le déploiement du code.
Les types de champ de variable/paramètre/jointure doivent correspondre au type de champ (C'est quelque chose à quoi je ne prêtais pas beaucoup attention auparavant)
Évitez la consommation CPU supplémentaire causée par la conversion de type ; les balayages de grandes tables qu'elle déclenche sont particulièrement graves.
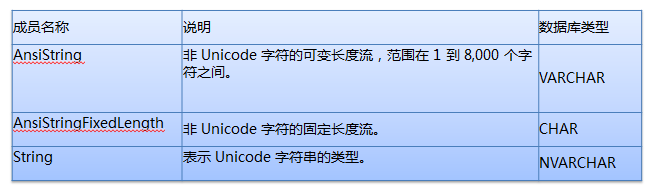
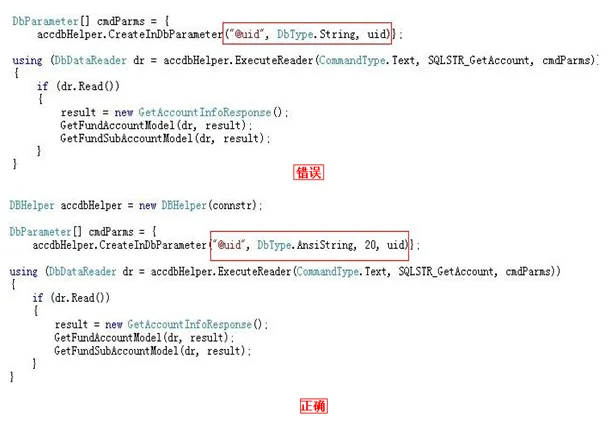
En regardant les deux figures ci-dessus, je pense que je n'ai pas besoin d'expliquer davantage — tout le monde devrait déjà avoir compris.
Si le type du champ de base de données est VARCHAR, il est préférable de spécifier le type comme AnsiString dans l'application et de préciser explicitement sa longueur.
Si le type du champ de base de données est CHAR, il est préférable de spécifier le type comme AnsiStringFixedLength dans l'application et de préciser explicitement sa longueur.
Si le type du champ de base de données est NVARCHAR, il est préférable de spécifier le type comme String dans l'application et de préciser explicitement sa longueur.
Requêtes paramétrées
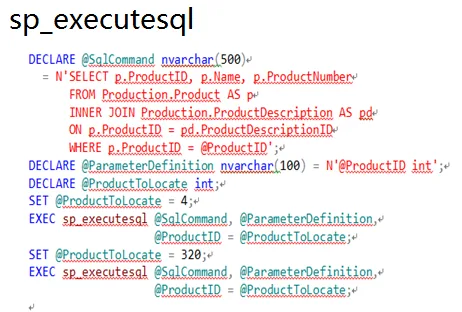
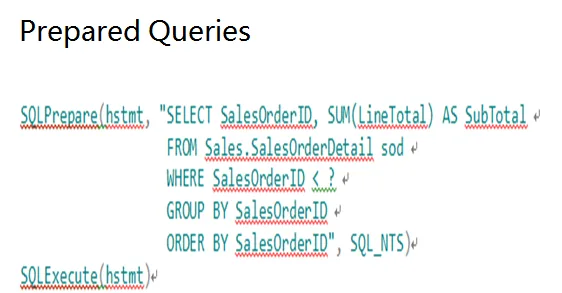
Les méthodes suivantes peuvent être utilisées pour paramétrer une requête SQL :
sp_executesql
Requêtes préparées
Procédures stockées
Laissez-moi illustrer avec une figure, haha.
Limiter le nombre de JOINs
- Le nombre de JOIN de tables dans une seule instruction SQL ne doit pas dépasser 5.
- Un trop grand nombre de JOINs peut amener l'analyseur de requêtes à choisir un mauvais plan d'exécution.
- Un trop grand nombre de JOINs consomme beaucoup lors de la compilation du plan d'exécution.
Limiter le nombre de conditions dans les clauses IN
Inclure un très grand nombre de valeurs (des milliers) dans la clause IN peut consommer des ressources et renvoyer l'erreur 8623 ou 8632. Le nombre de conditions dans la clause IN doit être limité à 100.
Essayer d'éviter les opérations de transaction volumineuses
- Ne démarrer une transaction que lorsqu'il est nécessaire de mettre à jour des données, afin de réduire le temps de détention des verrous de ressources.
- Ajouter un mécanisme de prétraitement pour la capture des exceptions de transaction.
- Les transactions distribuées sur la base de données sont interdites.
Laissez-moi illustrer cela par une figure.
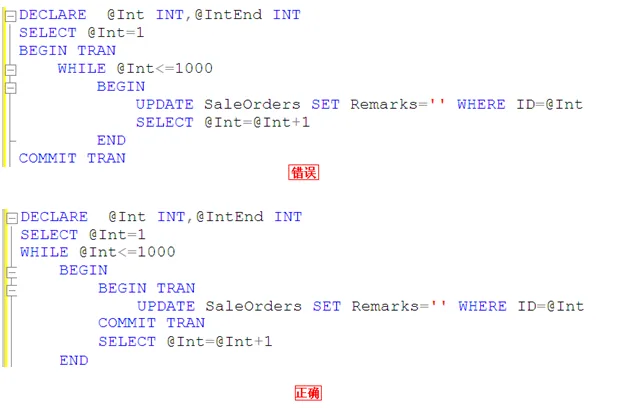
Autrement dit, nous ne devrions pas exécuter COMMIT TRAN seulement après que les 1000 lignes de données ont toutes été mises à jour. Réfléchissez : pendant que vous mettez à jour ces mille lignes, n'occupez-vous pas exclusivement les ressources, empêchant ainsi d'autres transactions de pouvoir s'exécuter ?
Désactiver le renvoi des informations sur le nombre de lignes affectées
Indiquez explicitement « Set Nocount On » dans les instructions SQL afin d'annuler le renvoi des informations sur le nombre de lignes affectées et de réduire le trafic réseau.
Sauf si nécessaire, toutes les instructions SELECT doivent inclure NOLOCK.
Sauf si nécessaire, essayez d'ajouter NOLOCK à toutes les instructions SELECT
Spécifie que les lectures sales sont autorisées. Aucun verrou partagé n'est émis pour empêcher d'autres transactions de modifier les données lues par la transaction actuelle, et les verrous exclusifs posés par d'autres transactions n'empêcheront pas la transaction actuelle de lire les données verrouillées. Autoriser les lectures sales peut produire davantage d'opérations concurrentes, mais le coût est la lecture de modifications de données qui seront ensuite annulées par d'autres transactions. Cela peut provoquer des erreurs dans votre transaction, afficher des données qui n'ont jamais été validées aux utilisateurs, ou faire voir des enregistrements deux fois aux utilisateurs (ou ne pas leur faire voir d'enregistrements du tout).
Utilisez UNION ALL pour remplacer UNION.
Utiliser UNION ALL au lieu de UNION
UNION dédupliquera et triera le jeu de résultats SQL, augmentant la consommation de CPU, de mémoire et d'autres ressources.
Utiliser la pagination ou TOP lors de l'interrogation de grandes quantités de données
Limitez raisonnablement le nombre d'enregistrements renvoyés pour éviter les goulots d'étranglement d'E/S et de bande passante réseau.
Limite du niveau de requête récursive
Utilisez MAXRECURSION pour empêcher les CTE récursives déraisonnables d'entrer dans des boucles infinies.
Tables temporaires et variables de table
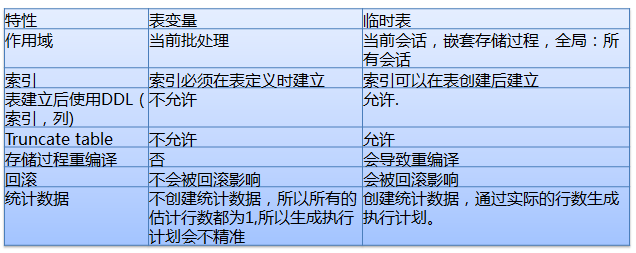
Utiliser des variables locales pour choisir un plan d'exécution modéré
Dans une procédure stockée ou une requête, si l'on accède à une table dont la distribution des données est très inégale, cela amène souvent la procédure stockée ou la requête à utiliser un plan d'exécution sous-optimal, voire médiocre, entraînant des problèmes tels qu'un CPU élevé et un grand nombre de lectures d'E/S. Utilisez des variables locales pour éviter de choisir un mauvais plan d'exécution.
Avec l'approche par variable locale, SQL ne connaît pas la valeur de la variable locale au moment de la compilation. À ce stade, SQL va « deviner » une valeur de retour en fonction de la distribution générale des données dans la table. Quelle que soit la valeur de variable transmise par l'utilisateur lors de l'appel de la procédure stockée ou de l'instruction, le plan généré est le même. Un tel plan est généralement plus modéré : il peut ne pas être le plan optimal, mais il ne sera généralement pas non plus le pire plan.
Si la variable locale de la requête utilise un opérateur d'inégalité, l'analyseur de requêtes utilise une formule simple de 30 % pour estimer.
Lignes estimées =(Nombre total de lignes * 30)/100
Si la variable locale dans la requête utilise un opérateur d'égalité, l'analyseur de requêtes utilise : précision * nombre total d'enregistrements de la table pour estimer.
Lignes estimées = Densité * Nombre total de lignes
Essayer d'éviter d'utiliser l'opérateur OR
Pour les opérateurs OR, un balayage complet de table est généralement utilisé. Envisagez de scinder la requête en plusieurs requêtes implémentées avec UNION/UNION ALL. Ici, vous devez confirmer que la requête peut utiliser un index et renvoyer un ensemble de résultats plus petit.
Ajouter des mécanismes de gestion des exceptions de transaction
L'application doit gérer correctement les exceptions et effectuer un Rollback en temps utile.
Définissez la propriété de connexion "set xact_abort on".
Les colonnes de sortie utilisent un format de nommage en deux parties
Format de nommage en deux parties : TableName.ColumnName
Dans TSQL avec des relations JOIN, les champs doivent indiquer à quelle table ils appartiennent. Sinon, après de futures modifications de la structure des tables, des erreurs de compatibilité du programme telles que "Ambiguous column name" peuvent se produire.
Conception de l'architecture
- Séparation lecture-écriture
- Découplage du schéma
- Cycle de vie des données
Séparation lecture-écriture
- Envisagez la séparation lecture-écriture dès le tout début de la conception, même si les lectures et les écritures utilisent la même base de données—cela est bénéfique pour une mise à l'échelle rapide.
- Selon les caractéristiques de lecture, divisez les lectures en lectures en temps réel et lectures différables, correspondant respectivement à la base de données d'écriture et à la base de données de lecture.
- La séparation lecture-écriture doit envisager de basculer automatiquement vers le côté écriture lorsque les lectures ne sont pas disponibles.
Découplage du schéma
Les JOIN inter-bases de données sont interdits.
Cycle de vie des données
En fonction de la fréquence d'utilisation des données, archiver périodiquement les grandes tables dans des bases de données séparées.
Séparer physiquement la base de données principale et la base de données d'archivage.
Les tables de type journal doivent être partitionnées ou divisées en plusieurs tables
Les grandes tables doivent être partitionnées. Le partitionnement distribue les tables et les index sur plusieurs partitions. Grâce à la commutation de partitions, les anciennes et nouvelles partitions peuvent être rapidement remplacées, ce qui accélère le nettoyage des données et réduit considérablement la consommation de ressources IO.
Les tables avec des écritures fréquentes doivent être partitionnées ou divisées en plusieurs tables
Auto-incrément et verrou Latch
Les verrous Latch sont demandés et contrôlés en interne par SQL Server lui-même ; les utilisateurs n'ont aucun moyen d'intervenir. Ils sont utilisés pour garantir la cohérence des structures de données en mémoire, et le niveau de verrou est un verrou au niveau page.
Source : http://www.codeceo.com/article/sql-server-tips.html