Damit Quellcode ausgeführt werden kann, muss er zuerst in binären Maschinencode umgewandelt werden. Das ist die Aufgabe des Compilers.
Betrachten Sie zum Beispiel den folgenden Quellcode (nehmen Sie an, der Dateiname sei test.c).
#include <stdio.h>

int main(void)
{
  fputs("Hello, world!\n", stdout);
  return 0;
}
Er muss zuerst von einem Compiler verarbeitet werden, bevor er ausgeführt werden kann.
$ gcc test.c
$ ./a.out
Hello, world!
Bei komplexen Projekten muss der Kompilierungsprozess in drei Schritte unterteilt werden.
$ ./configure
$ make
$ make install
Was genau bewirken diese Befehle? Die meisten Bücher und Materialien bleiben an diesem Punkt vage und sagen einfach "so kompiliert man", ohne weitere Erklärung.
Dieser Artikel stellt vor, wie der Compiler funktioniert, das heißt, welche Aufgaben die drei obigen Befehle jeweils haben. Ich beziehe mich hauptsächlich auf Alex Smiths Artikel "Building C Projects". Es sollte beachtet werden, dass sich dieser Artikel hauptsächlich auf den gcc-Compiler bezieht, also auf C und C++, und möglicherweise nicht auf die Kompilierung anderer Sprachen anwendbar ist.
Schritt 1: Konfigurieren
Bevor der Compiler mit der Arbeit beginnt, muss er die aktuelle Systemumgebung kennen, z. B. wo sich die Standardbibliothek befindet, wo der Software-Installationsort liegt, welche Komponenten installiert werden müssen und so weiter. Das liegt daran, dass verschiedene Computer unterschiedliche Systemumgebungen haben. Durch Angabe von Kompilierungsparametern kann sich der Compiler flexibel an die Umgebung anpassen und Maschinencode erzeugen, der in verschiedenen Umgebungen ausgeführt werden kann. Dieser Schritt der Bestimmung der Kompilierungsparameter wird "configure" genannt.
Diese Konfigurationsinformationen werden in einer Konfigurationsdatei gespeichert, üblicherweise einer Skriptdatei namens configure. Sie wird normalerweise vom autoconf-Tool generiert. Der Compiler erhält die Kompilierungsparameter durch Ausführen dieses Skripts.
Das configure-Skript versucht bereits, Unterschiede zwischen Systemen zu berücksichtigen, und stellt Standardwerte für verschiedene Kompilierungsparameter bereit. Wenn die Systemumgebung des Benutzers ungewöhnlich ist oder spezifische Anforderungen bestehen, muss der Benutzer dem configure-Skript die Kompilierungsparameter manuell übergeben.
$ ./configure --prefix=/www --with-mysql
Der obige Code ist eine Kompilierungskonfiguration für PHP-Quellcode. Der Benutzer gibt an, dass die installierten Dateien im www-Verzeichnis gespeichert werden und dass die Unterstützung für das mysql-Modul während der Kompilierung einbezogen wird.
Schritt 2: Bestimmen Sie den Speicherort der Standardbibliothek und der Header-Dateien
Quellcode wird unweigerlich Standardbibliotheksfunktionen und Header-Dateien verwenden. Sie können in jedem Verzeichnis des Systems gespeichert sein. Der Compiler kann ihren Speicherort nicht automatisch erkennen; er kann ihn nur über die Konfigurationsdatei erfahren.
Der zweite Schritt der Kompilierung besteht darin, den Speicherort der Standardbibliothek und der Header-Dateien aus der Konfigurationsdatei zu erfahren. Im Allgemeinen stellt die Konfigurationsdatei eine Liste mehrerer bestimmter Verzeichnisse bereit. Während der Kompilierung durchsucht der Compiler diese Verzeichnisse der Reihe nach, um die Ziele zu finden.
Schritt 3: Abhängigkeiten bestimmen
Bei großen Projekten gibt es oft Abhängigkeiten zwischen Quelldateien. Der Compiler muss die Reihenfolge der Kompilierung bestimmen. Angenommen, Datei A hängt von Datei B ab; der Compiler sollte die folgenden zwei Punkte sicherstellen:
(1) Datei A kann erst kompiliert werden, nachdem Datei B kompiliert wurde.
(2) Wenn sich Datei B ändert, wird Datei A neu kompiliert.
Die Kompilierungsreihenfolge wird in einer Datei namens makefile gespeichert, die auflistet, welche Dateien zuerst und welche später kompiliert werden. Die makefile-Datei wird durch Ausführen des configure-Skripts generiert; deshalb muss configure während der Kompilierung zuerst ausgeführt werden.
Während der Ermittlung von Abhängigkeiten bestimmt der Compiler auch, welche Header-Dateien während der Kompilierung verwendet werden.
Schritt 4: Vorkompilierung der Header-Dateien
Verschiedene Quelldateien können auf dieselbe Header-Datei verweisen (z. B. stdio.h). Beim Kompilieren müssen auch Header-Dateien kompiliert werden. Um Zeit zu sparen, kompiliert der Compiler Header-Dateien, bevor er den Quellcode kompiliert. Dadurch wird sichergestellt, dass jede Header-Datei nur einmal kompiliert wird, anstatt bei jeder Verwendung erneut kompiliert zu werden.
Allerdings werden nicht alle Inhalte von Header-Dateien vorkompiliert. Der Befehl #define, der zum Deklarieren von Makros verwendet wird, wird nicht vorkompiliert.
Schritt 5: Präprozessierung
Nach der Vorkompilierung beginnt der Compiler, die Header-Dateien und Makros im Quellcode zu ersetzen. Nehmen wir den Quellcode vom Anfang dieses Artikels als Beispiel: Er enthält die Header-Datei stdio.h, und nach dem Ersetzen sieht er so aus:
extern int fputs(const char *, FILE *);
extern FILE *stdout;

int main(void)
{
    fputs("Hello, world!\n", stdout);
    return 0;
}
Zur besseren Lesbarkeit zeigt der obige Code nur die Teile der Header-Datei, die für den Quellcode relevant sind, d. h. die Deklarationen von fputs und FILE, und lässt den Rest von stdio.h weg (weil er sehr lang ist). Außerdem wurde die Header-Datei im obigen Code nicht vorkompiliert; tatsächlich wird das vorkompilierte Ergebnis in den Quellcode eingefügt. Der Compiler entfernt in diesem Schritt auch Kommentare.
Dieser Schritt wird "Präprozessierung" genannt, denn nach seinem Abschluss beginnt die eigentliche Verarbeitung.
Schritt 6: Kompilierung
Nach der Präprozessierung beginnt der Compiler, Maschinencode zu erzeugen. Bei manchen Compilern gibt es einen Zwischenschritt: Zuerst wird der Quellcode in Assembler-Code umgewandelt und dann der Assembler-Code in Maschinencode.
Nachfolgend ist der Assembler-Code aufgeführt, der aus dem Quellcode vom Anfang dieses Artikels generiert wurde.
    .file   "test.c"
    .section    .rodata
.LC0:
    .string "Hello, world!\n"
    .text
    .globl  main
    .type   main, @function
main:
.LFB0:
    .cfi_startproc
    pushq   %rbp
    .cfi_def_cfa_offset 16
    .cfi_offset 6, -16
    movq    %rsp, %rbp
    .cfi_def_cfa_register 6
    movq    stdout(%rip), %rax
    movq    %rax, %rcx
    movl    $14, %edx
    movl    $1, %esi
    movl    $.LC0, %edi
    call    fwrite
    movl    $0, %eax
    popq    %rbp
    .cfi_def_cfa 7, 8
    ret
    .cfi_endproc
.LFE0:
    .size   main, .-main
    .ident  "GCC: (Debian 4.9.1-19) 4.9.1"
    .section    .note.GNU-stack,"",@progbits
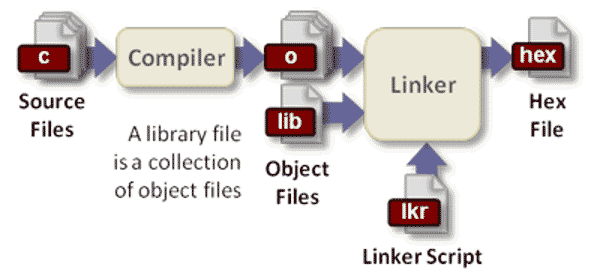
Diese transkodierte Datei wird Objektdatei genannt.
Schritt 7: Linken
Die Objektdatei kann noch nicht ausgeführt werden; sie muss weiter in eine ausführbare Datei umgewandelt werden. Wenn Sie sich das Ergebnis des vorherigen Schritts genau ansehen, werden Sie feststellen, dass es auf die Funktion stdout und die Funktion fwrite verweist. Das heißt, damit das Programm normal ausgeführt werden kann, muss es zusätzlich zum obigen Code auch den Code für die Funktionen stdout und fwrite enthalten, die von der C-Standardbibliothek bereitgestellt werden.
Die nächste Aufgabe des Compilers besteht darin, den Code externer Funktionen (normalerweise Dateien mit den Endungen .lib und .a) zur ausführbaren Datei hinzuzufügen. Dies wird als Linken bezeichnet. Diese Methode, externe Funktionsbibliotheken durch Kopieren zur ausführbaren Datei hinzuzufügen, wird als statisches Linken bezeichnet. Dynamisches Linken wird später erwähnt.
Die Aufgabe des Befehls make besteht darin, bei Schritt 4, der Vorkompilierung von Header-Dateien, zu beginnen und fortzufahren, bis dieser Schritt abgeschlossen ist.
Schritt 8: Installation
Das Linken im vorherigen Schritt erfolgt im Speicher, das heißt, der Compiler erzeugt die ausführbare Datei im Speicher. Als Nächstes muss die ausführbare Datei im Installationsverzeichnis gespeichert werden, das zuvor vom Benutzer angegeben wurde.
Oberflächlich betrachtet ist dieser Schritt einfach: Man kopiert einfach die ausführbare Datei (zusammen mit zugehörigen Datendateien) dorthin. In der Praxis umfasst dieser Schritt jedoch auch das Erstellen von Verzeichnissen, das Speichern von Dateien, das Festlegen von Berechtigungen und so weiter. Dieser gesamte Speichervorgang wird als "Installation" bezeichnet.
Schritt 9: Integration in das Betriebssystem
Nachdem die ausführbare Datei installiert wurde, muss das Betriebssystem auf irgendeine Weise darüber informiert werden, dass das Programm verfügbar ist. Wenn wir beispielsweise ein Textleseprogramm installieren, möchten wir oft, dass das Programm automatisch ausgeführt wird, wenn auf eine txt-Datei doppelt geklickt wird.
Dazu müssen die Metadaten des Programms im Betriebssystem registriert werden: Dateiname, Dateibeschreibung, zugeordnete Dateiendungen und so weiter. Unter Linux werden diese Informationen normalerweise in .desktop-Dateien im Verzeichnis /usr/share/applications gespeichert. Darüber hinaus muss unter Windows-Betriebssystemen eine Verknüpfung im Startmenü erstellt werden.
Diese Aufgaben werden als „Betriebssystemintegration“ bezeichnet. Der Befehl make install wird verwendet, um die Schritte „Installation“ und „Betriebssystemintegration“ abzuschließen.
Schritt 10: Installationspaket erzeugen
An diesem Punkt ist der Gesamtprozess der Kompilierung von Quellcode im Wesentlichen abgeschlossen. Aber nur sehr wenige Benutzer sind bereit, diesen gesamten Prozess von Anfang bis Ende geduldig durchzugehen. Tatsächlich werden sie dich für unfreundlich halten, wenn du den Benutzern nur den Quellcode gibst. Die meisten Benutzer möchten ein binäres ausführbares Programm, das sofort ausgeführt werden kann. Dazu müssen Entwickler die im vorherigen Schritt erzeugte ausführbare Datei in ein verteilbares Installationspaket umwandeln.
Daher muss der Compiler auch in der Lage sein, Installationspakete zu erzeugen. Normalerweise wird die ausführbare Datei (zusammen mit zugehörigen Datendateien) als komprimiertes Archiv in einer bestimmten Verzeichnisstruktur gespeichert und dem Benutzer übergeben.
Schritt 11: Dynamisches Linken
Normalerweise ist das Programm zu diesem Zeitpunkt bereits lauffähig. Was während der Laufzeit geschieht, ist für den Compiler unerheblich. Der Entwickler kann jedoch während der Kompilierungsphase wählen, wie die ausführbare Datei mit externen Funktionsbibliotheken verknüpft wird: entweder statisches Linken (Verknüpfung zur Kompilierungszeit) oder dynamisches Linken (Verknüpfung zur Laufzeit). Abschließend sollten wir daher auch erwähnen, was dynamisches Linken bedeutet.
Wie bereits erwähnt, bedeutet statisches Linken, dass externe Funktionsbibliotheken in die ausführbare Datei kopiert werden. Der Vorteil ist die breite Anwendbarkeit: Man muss sich keine Sorgen machen, dass auf dem Rechner des Benutzers eine Bibliotheksdatei fehlt. Der Nachteil ist, dass das Installationspaket relativ groß ist und mehrere Anwendungen keine Bibliotheksdateien gemeinsam nutzen können. Dynamisches Linken ist das Gegenteil: Externe Funktionsbibliotheken sind nicht im Installationspaket enthalten und werden erst zur Laufzeit dynamisch referenziert. Der Vorteil ist, dass das Installationspaket kleiner ist und mehrere Anwendungen Bibliotheksdateien gemeinsam nutzen können. Der Nachteil ist, dass Benutzer die Bibliotheksdateien vorinstalliert haben müssen und sowohl die Version als auch der Installationsort den Anforderungen entsprechen müssen; andernfalls läuft das Programm nicht ordnungsgemäß.
In der Praxis verwendet die meiste Software dynamisches Linken und gemeinsam genutzte Bibliotheksdateien. Diese dynamisch gemeinsam genutzten Bibliotheksdateien haben auf Linux-Plattformen die Endung .so, auf Windows-Plattformen .dll und auf Mac-Plattformen .dylib.
Originalquelle: http://www.ruanyifeng.com/blog/2014/11/compiler.html