Pour qu'un code source puisse s'exécuter, il doit d'abord être converti en code machine binaire. C'est la tâche du compilateur.
Par exemple, considérons le code source suivant (supposons que le nom du fichier soit test.c).
#include <stdio.h>

int main(void)
{
  fputs("Hello, world!\n", stdout);
  return 0;
}
Il doit d'abord être traité par un compilateur avant de pouvoir s'exécuter.
$ gcc test.c
$ ./a.out
Hello, world!
Pour les projets complexes, le processus de compilation doit être divisé en trois étapes.
$ ./configure
$ make
$ make install
Que font exactement ces commandes ? La plupart des livres et des ressources restent vagues sur ce point, se contentant de dire « c'est ainsi que l'on compile », sans plus d'explication.
Cet article présentera le fonctionnement du compilateur, c'est-à-dire les tâches respectives des trois commandes ci-dessus. Je me réfère principalement à l'article d'Alex Smith « Building C Projects ». Il convient de noter que cet article cible principalement le compilateur gcc, c'est-à-dire C et C++, et peut ne pas s'appliquer à la compilation d'autres langages.
Étape 1 : Configure
Avant que le compilateur ne commence à fonctionner, il doit connaître l'environnement système actuel, par exemple où se trouve la bibliothèque standard, où se trouve l'emplacement d'installation des logiciels, quels composants doivent être installés, etc. Cela s'explique par le fait que différents ordinateurs ont des environnements système différents. En spécifiant des paramètres de compilation, le compilateur peut s'adapter de manière flexible à l'environnement et produire du code machine pouvant s'exécuter dans divers environnements. Cette étape de détermination des paramètres de compilation est appelée « configure ».
Ces informations de configuration sont stockées dans un fichier de configuration, conventionnellement un fichier script nommé configure. Il est généralement généré par l'outil autoconf. Le compilateur obtient les paramètres de compilation en exécutant ce script.
Le script configure essaie déjà de prendre en compte les différences entre les systèmes et fournit des valeurs par défaut pour divers paramètres de compilation. Si l'environnement système de l'utilisateur est inhabituel, ou s'il existe des exigences spécifiques, l'utilisateur doit fournir manuellement des paramètres de compilation au script configure.
$ ./configure --prefix=/www --with-mysql
Le code ci-dessus est une configuration de compilation du code source PHP. L'utilisateur spécifie que les fichiers installés sont enregistrés dans le répertoire www, et que la prise en charge du module mysql est incluse lors de la compilation.
Étape 2 : Déterminer l'emplacement de la bibliothèque standard et des fichiers d'en-tête
Le code source utilisera inévitablement des fonctions de bibliothèque standard et des fichiers d'en-tête. Ils peuvent être stockés dans n'importe quel répertoire du système. Le compilateur ne peut pas détecter automatiquement leur emplacement ; il ne peut le connaître qu'à travers le fichier de configuration.
La deuxième étape de la compilation consiste à apprendre l'emplacement de la bibliothèque standard et des fichiers d'en-tête à partir du fichier de configuration. Généralement, le fichier de configuration fournit une liste de plusieurs répertoires spécifiques. Pendant la compilation, le compilateur recherche ces répertoires dans l'ordre pour trouver les cibles.
Étape 3 : Déterminer les dépendances
Pour les grands projets, il existe souvent des dépendances entre les fichiers source. Le compilateur doit déterminer l'ordre de compilation. Supposons que le fichier A dépende du fichier B ; le compilateur doit garantir les deux points suivants :
(1) Le fichier A ne peut être compilé qu'après que le fichier B a été compilé.
(2) Lorsque le fichier B change, le fichier A sera recompilé.
L'ordre de compilation est stocké dans un fichier appelé makefile, qui liste quels fichiers sont compilés en premier et quels fichiers sont compilés plus tard. Le fichier makefile est généré en exécutant le script configure, c'est pourquoi configure doit être exécuté en premier lors de la compilation.
Tout en déterminant les dépendances, le compilateur détermine également quels fichiers d'en-tête seront utilisés lors de la compilation.
Étape 4 : Précompilation des fichiers d'en-tête
Différents fichiers source peuvent référencer le même fichier d'en-tête (par exemple, stdio.h). Pendant la compilation, les fichiers d'en-tête doivent aussi être compilés. Pour gagner du temps, le compilateur compile les fichiers d'en-tête avant de compiler le code source. Cela garantit que chaque fichier d'en-tête n'est compilé qu'une seule fois, au lieu d'être recompilé à chaque fois qu'il est utilisé.
Cependant, tout le contenu des fichiers d'en-tête n'est pas précompilé. La commande #define, utilisée pour déclarer des macros, n'est pas précompilée.
Étape 5 : Prétraitement
Après la précompilation, le compilateur commence à remplacer les fichiers d'en-tête et les macros dans le code source. En prenant comme exemple le code source du début de cet article, il contient le fichier d'en-tête stdio.h, et après remplacement, il ressemble à ceci :
extern int fputs(const char *, FILE *);
extern FILE *stdout;

int main(void)
{
    fputs("Hello, world!\n", stdout);
    return 0;
}
Pour la lisibilité, le code ci-dessus ne montre que les parties du fichier d'en-tête liées au code source, c'est-à-dire les déclarations de fputs et FILE, en omettant le reste de stdio.h (car il est très long). De plus, le fichier d'en-tête dans le code ci-dessus n'a pas été précompilé ; en fait, ce qui est inséré dans le code source est le résultat précompilé. Le compilateur supprime également les commentaires lors de cette étape.
Cette étape est appelée « prétraitement », car une fois qu'elle est terminée, le véritable traitement est sur le point de commencer.
Étape 6 : Compilation
Après le prétraitement, le compilateur commence à générer du code machine. Pour certains compilateurs, il existe une étape intermédiaire : d'abord convertir le code source en code assembleur, puis convertir le code assembleur en code machine.
Ci-dessous se trouve le code assembleur généré à partir du code source du début de cet article.
    .file   "test.c"
    .section    .rodata
.LC0:
    .string "Hello, world!\n"
    .text
    .globl  main
    .type   main, @function
main:
.LFB0:
    .cfi_startproc
    pushq   %rbp
    .cfi_def_cfa_offset 16
    .cfi_offset 6, -16
    movq    %rsp, %rbp
    .cfi_def_cfa_register 6
    movq    stdout(%rip), %rax
    movq    %rax, %rcx
    movl    $14, %edx
    movl    $1, %esi
    movl    $.LC0, %edi
    call    fwrite
    movl    $0, %eax
    popq    %rbp
    .cfi_def_cfa 7, 8
    ret
    .cfi_endproc
.LFE0:
    .size   main, .-main
    .ident  "GCC: (Debian 4.9.1-19) 4.9.1"
    .section    .note.GNU-stack,"",@progbits
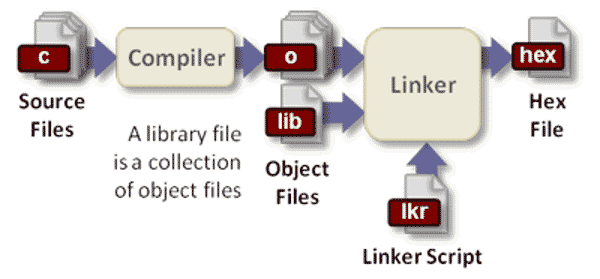
Ce fichier transcodé est appelé fichier objet.
Étape 7 : Édition des liens
Le fichier objet ne peut pas encore s'exécuter ; il doit être converti davantage en un fichier exécutable. Si vous observez attentivement le résultat de l'étape précédente, vous remarquerez qu'il référence la fonction stdout et la fonction fwrite. Autrement dit, pour que le programme s'exécute normalement, en plus du code ci-dessus, il doit également disposer du code des fonctions stdout et fwrite, qui sont fournies par la bibliothèque standard C.
La tâche suivante du compilateur consiste à ajouter le code des fonctions externes (généralement des fichiers avec les suffixes .lib et .a) au fichier exécutable. C'est ce qu'on appelle l'édition de liens. Cette méthode d'ajout de bibliothèques de fonctions externes au fichier exécutable par copie est appelée liaison statique. La liaison dynamique sera mentionnée plus tard.
Le rôle de la commande make est de partir de l'Étape 4, la précompilation des fichiers d'en-tête, et de continuer jusqu'à ce que cette étape soit terminée.
Étape 8 : Installation
L'édition de liens de l'étape précédente est effectuée en mémoire, ce qui signifie que le compilateur génère le fichier exécutable en mémoire. Ensuite, le fichier exécutable doit être enregistré dans le répertoire d'installation spécifié à l'avance par l'utilisateur.
En apparence, cette étape est simple : il suffit de copier le fichier exécutable (ainsi que les fichiers de données associés) à cet endroit. Cependant, en pratique, cette étape implique aussi la création de répertoires, l'enregistrement de fichiers, la définition d'autorisations, etc. Tout ce processus d'enregistrement est appelé « Installation ».
Étape 9 : Intégration au système d'exploitation
Une fois le fichier exécutable installé, le système d'exploitation doit être informé d'une manière ou d'une autre que le programme est disponible. Par exemple, si nous installons un programme de lecture de texte, nous souhaitons souvent que le programme s'exécute automatiquement lorsqu'on double-clique sur un fichier txt.
Cela nécessite d'enregistrer les métadonnées du programme dans le système d'exploitation : nom du fichier, description du fichier, extensions de fichiers associées, etc. Dans les systèmes Linux, ces informations sont généralement stockées dans des fichiers .desktop sous le répertoire /usr/share/applications. De plus, sur les systèmes d'exploitation Windows, un raccourci doit être créé dans le menu Démarrer.
Ces tâches sont appelées « Intégration au système d'exploitation ». La commande make install est utilisée pour accomplir les étapes « Installation » et « Intégration au système d'exploitation ».
Étape 10 : Générer le paquet d'installation
À ce stade, le processus global de compilation du code source est pratiquement terminé. Mais seul un très petit nombre d'utilisateurs est prêt à parcourir patiemment tout ce processus du début à la fin. En fait, si vous ne fournissez aux utilisateurs que le code source, ils vous considéreront comme peu convivial. La plupart des utilisateurs veulent un programme exécutable binaire qui peut être exécuté immédiatement. Cela oblige les développeurs à transformer le fichier exécutable généré à l'étape précédente en un paquet d'installation distribuable.
Par conséquent, le compilateur doit également avoir la capacité de générer des paquets d'installation. Habituellement, le fichier exécutable (ainsi que les fichiers de données associés) est enregistré sous forme d'archive compressée dans une certaine structure de répertoires et remis à l'utilisateur.
Étape 11 : Liaison dynamique
Normalement, à cette étape, le programme est déjà capable de s'exécuter. Quant à ce qui se passe pendant l'exécution, cela n'a rien à voir avec le compilateur. Cependant, le développeur peut choisir, pendant la phase de compilation, la manière dont le fichier exécutable se lie aux bibliothèques de fonctions externes : soit la liaison statique (liaison au moment de la compilation), soit la liaison dynamique (liaison au moment de l'exécution). Donc, enfin, nous devrions également mentionner ce que signifie la liaison dynamique.
Comme mentionné précédemment, la liaison statique consiste à copier des bibliothèques de fonctions externes dans le fichier exécutable. L'avantage est une large applicabilité : pas besoin de se soucier de l'absence d'un fichier de bibliothèque sur la machine de l'utilisateur. L'inconvénient est que le paquet d'installation est relativement volumineux, et que plusieurs applications ne peuvent pas partager les fichiers de bibliothèque. La liaison dynamique est l'inverse : les bibliothèques de fonctions externes ne sont pas incluses dans le paquet d'installation et ne sont référencées dynamiquement qu'à l'exécution. L'avantage est que le paquet d'installation est plus petit, et que plusieurs applications peuvent partager les fichiers de bibliothèque. L'inconvénient est que les utilisateurs doivent avoir les fichiers de bibliothèque préinstallés, et que tant la version que l'emplacement d'installation doivent répondre aux exigences ; sinon, le programme ne fonctionnera pas correctement.
En pratique, la plupart des logiciels utilisent la liaison dynamique et des fichiers de bibliothèque partagés. Ces fichiers de bibliothèque partagés dynamiquement ont l'extension .so sur les plateformes Linux, .dll sur les plateformes Windows, et .dylib sur les plateformes Mac.
Source originale : http://www.ruanyifeng.com/blog/2014/11/compiler.html