Para que el código fuente se ejecute, primero debe convertirse en código máquina binario. Esa es la tarea del compilador.
Por ejemplo, el siguiente código fuente (supongamos que el archivo se llama test.c).
#include <stdio.h>

int main(void)
{
  fputs("Hello, world!\n", stdout);
  return 0;
}
Primero hay que procesarlo con el compilador para poder ejecutarlo.
$ gcc test.c
$ ./a.out
Hello, world!
Para proyectos complejos, el proceso de compilación debe dividirse en tres pasos.
$ ./configure
$ make
$ make install
¿Qué hacen exactamente estos comandos? La mayoría de los libros y materiales son vagos al respecto, solo dicen que así se compila, sin dar más explicaciones.
Este artículo presentará el proceso de trabajo del compilador, es decir, las tareas de cada uno de los tres comandos anteriores. Me he basado principalmente en el artículo de Alex Smith "Building C Projects". Cabe aclarar que este artículo se centra principalmente en el compilador gcc, es decir, en C y C++, y no necesariamente se aplica a la compilación de otros lenguajes.
Paso 1: Configuración (configure)
Antes de comenzar a trabajar, el compilador necesita conocer el entorno actual del sistema, por ejemplo, dónde está la biblioteca estándar, dónde se instalará el software, qué componentes es necesario instalar, etc. Esto se debe a que el entorno del sistema varía entre computadoras. Al especificar los parámetros de compilación, el compilador puede adaptarse con flexibilidad al entorno y generar código máquina que pueda ejecutarse en diversos entornos. Este paso de determinar los parámetros de compilación se denomina "configuración" (configure).
Esta información de configuración se guarda en un archivo de configuración, que por convención es un archivo de script llamado configure. Normalmente lo genera la herramienta autoconf. El compilador, al ejecutar este script, obtiene los parámetros de compilación.
El script configure ya ha tenido en cuenta, en la medida de lo posible, las diferencias entre los distintos sistemas, y ofrece valores predeterminados para varios parámetros de compilación. Si el entorno del sistema del usuario es especialmente diferente o tiene requisitos específicos, es necesario proporcionar manualmente los parámetros de compilación al script configure.
$ ./configure --prefix=/www --with-mysql
El código anterior es una configuración de compilación para el código fuente de PHP. El usuario especifica que los archivos instalados se guarden en el directorio www y que se incluya soporte para el módulo mysql durante la compilación.
Paso 2: Determinar la ubicación de la biblioteca estándar y los archivos de cabecera
El código fuente seguramente utiliza funciones de la biblioteca estándar (standard library) y archivos de cabecera (header). Pueden estar ubicados en cualquier directorio del sistema; el compilador, en realidad, no puede detectar automáticamente su ubicación, solo puede saberlo mediante el archivo de configuración.
El segundo paso de la compilación es conocer, a partir del archivo de configuración, la ubicación de la biblioteca estándar y los archivos de cabecera. En general, el archivo de configuración proporciona una lista con varios directorios concretos. Luego, durante la compilación, el compilador busca los objetivos en esos directorios en orden.
Paso 3: Determinar las dependencias
En proyectos grandes, a menudo existen dependencias entre los archivos de código fuente. El compilador debe determinar el orden de compilación. Supongamos que el archivo A depende del archivo B; el compilador debe garantizar lo siguiente:
(1) Solo después de que se complete la compilación del archivo B, se comienza a compilar el archivo A.
(2) Cuando el archivo B sufre modificaciones, el archivo A se vuelve a compilar.
El orden de compilación se guarda en un archivo llamado makefile, que enumera qué archivo se compila primero y cuál después. Y el archivo makefile se genera al ejecutar el script configure; por eso configure debe ejecutarse primero durante la compilación.
Al mismo tiempo que se determinan las dependencias, el compilador también determina qué archivos de cabecera se usarán durante la compilación.
Paso 4: Precompilación de los archivos de cabecera
Diferentes archivos de código fuente pueden hacer referencia al mismo archivo de cabecera (por ejemplo, stdio.h). Al compilar, los archivos de cabecera también deben compilarse junto con el código. Para ahorrar tiempo, el compilador primero compila los archivos de cabecera antes de compilar el código fuente. Esto garantiza que el archivo de cabecera se compile solo una vez y no sea necesario recompilarlo cada vez que se use.
Sin embargo, no todo el contenido del archivo de cabecera se precompila. El comando #define, que se usa para declarar macros, no se precompila.
Paso 5: Preprocesamiento (Preprocessing)
Una vez completada la precompilación, el compilador comienza a reemplazar los archivos de cabecera y las macros del código fuente. Tomando como ejemplo el código fuente del comienzo de este artículo, que incluye el archivo de cabecera stdio.h, el resultado después del reemplazo es el siguiente:
extern int fputs(const char *, FILE *);
extern FILE *stdout;

int main(void)
{
    fputs("Hello, world!\n", stdout);
    return 0;
}
Para facilitar la lectura, el código anterior solo muestra la parte del archivo de cabecera relacionada con el código fuente, es decir, las declaraciones de fputs y FILE, omitiendo el resto de stdio.h (porque son muy extensas). Además, el archivo de cabecera en el código anterior no ha sido precompilado; en realidad, lo que se inserta en el código fuente es el resultado de la precompilación. En este paso, el compilador también elimina los comentarios.
Este paso se denomina "preprocesamiento" (Preprocessing), porque una vez completado, comienza el procesamiento real.
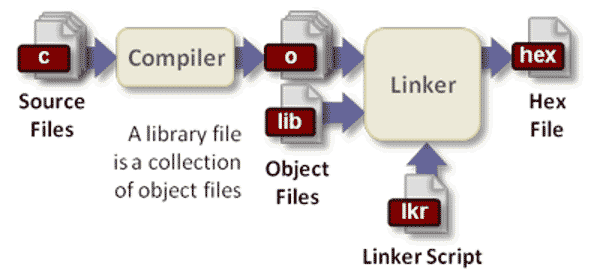
Paso 6: Compilación
Después del preprocesamiento, el compilador comienza a generar código máquina. Para algunos compiladores, existe un paso intermedio: primero se convierte el código fuente a código ensamblador (assembly) y luego este se convierte a código máquina.
El siguiente es el código ensamblador generado a partir del código fuente del comienzo de este artículo.
    .file   "test.c"
    .section    .rodata
.LC0:
    .string "Hello, world!\n"
    .text
    .globl  main
    .type   main, @function
main:
.LFB0:
    .cfi_startproc
    pushq   %rbp
    .cfi_def_cfa_offset 16
    .cfi_offset 6, -16
    movq    %rsp, %rbp
    .cfi_def_cfa_register 6
    movq    stdout(%rip), %rax
    movq    %rax, %rcx
    movl    $14, %edx
    movl    $1, %esi
    movl    $.LC0, %edi
    call    fwrite
    movl    $0, %eax
    popq    %rbp
    .cfi_def_cfa 7, 8
    ret
    .cfi_endproc
.LFE0:
    .size   main, .-main
    .ident  "GCC: (Debian 4.9.1-19) 4.9.1"
    .section    .note.GNU-stack,"",@progbits
Este archivo resultante de la conversión se denomina archivo objeto (object file).
Paso 7: Enlazado (Linking)
El archivo objeto aún no puede ejecutarse; debe convertirse además en un archivo ejecutable. Si observas con atención el resultado de la conversión del paso anterior, verás que se hace referencia a las funciones stdout y fwrite. Es decir, para que el programa se ejecute correctamente, además del código anterior, también se necesita el código de las funciones stdout y fwrite, que son proporcionadas por la biblioteca estándar del lenguaje C.
El siguiente trabajo del compilador es añadir el código de las funciones externas (normalmente archivos con extensiones .lib y .a) al archivo ejecutable. Esto se llama enlazado (linking). Esta forma de añadir bibliotecas de funciones externas al archivo ejecutable mediante copia se denomina enlazado estático (static linking); más adelante se mencionará el enlazado dinámico (dynamic linking).
La función del comando make es realizar desde el cuarto paso (precompilación de archivos de cabecera) hasta completar este paso.
Paso 8: Instalación
El enlazado del paso anterior se realiza en memoria, es decir, el compilador genera el archivo ejecutable en memoria. En el siguiente paso, es necesario guardar el archivo ejecutable en el directorio de instalación especificado previamente por el usuario.
En apariencia, este paso es muy simple: basta con copiar el archivo ejecutable (junto con los archivos de datos relacionados). Pero en realidad, este paso también debe incluir crear directorios, guardar archivos, establecer permisos, etc. Todo este proceso de guardado se denomina "instalación" (Installation).
Paso 9: Conexión con el sistema operativo
Una vez instalado el archivo ejecutable, se debe notificar al sistema operativo de alguna manera para que sepa que este programa está disponible. Por ejemplo, si instalamos un programa lector de texto, a menudo esperamos que al hacer doble clic en un archivo txt, el programa se ejecute automáticamente.
Esto requiere registrar los metadatos del programa en el sistema operativo: nombre del archivo, descripción, extensiones asociadas, etc. En sistemas Linux, esta información generalmente se guarda en archivos .desktop dentro del directorio /usr/share/applications. Además, en el sistema operativo Windows, es necesario crear un acceso directo en el menú de inicio Start.
Todas estas acciones se denominan "conexión con el sistema operativo". El comando make install se utiliza para completar los pasos de "instalación" y "conexión con el sistema operativo".
Paso 10: Generación del paquete de instalación
Hasta aquí, el proceso completo de compilación del código fuente está básicamente terminado. Sin embargo, muy pocos usuarios están dispuestos a tener paciencia para realizar todo este proceso de principio a fin. De hecho, si solo tienes el código fuente para entregar a los usuarios, pensarán que eres una persona poco amigable. La mayoría de los usuarios quieren un programa ejecutable binario que puedan ejecutar de inmediato. Esto requiere que el desarrollador convierta el archivo ejecutable generado en el paso anterior en un paquete de instalación que pueda distribuirse.
Por lo tanto, el compilador también debe tener la función de generar paquetes de instalación. Normalmente, se toma el archivo ejecutable (junto con los archivos de datos relacionados) y se guarda en un paquete comprimido con cierta estructura de directorios, para entregarlo al usuario.
Paso 11: Enlazado dinámico (Dynamic linking)
En circunstancias normales, en este punto el programa ya puede ejecutarse. En cuanto a lo que ocurre durante la ejecución (runtime), no tiene nada que ver con el compilador. Sin embargo, el desarrollador puede elegir en la fase de compilación el modo en que el archivo ejecutable se enlaza con las bibliotecas de funciones externas: ya sea enlazado estático (enlazado en tiempo de compilación) o enlazado dinámico (enlazado en tiempo de ejecución). Por lo tanto, al final también hay que mencionar qué es el enlazado dinámico.
Como se dijo antes, el enlazado estático consiste en copiar las bibliotecas de funciones externas dentro del archivo ejecutable. La ventaja es que tiene un ámbito de aplicación más amplio, sin preocuparse de que a la máquina del usuario le falte alguna biblioteca; la desventaja es que el paquete de instalación es más grande y varios programas no pueden compartir las bibliotecas. El enlazado dinámico hace lo contrario: las bibliotecas de funciones externas no se incluyen en el paquete de instalación, solo se referencian dinámicamente en tiempo de ejecución. La ventaja es que el paquete de instalación es más pequeño y varias aplicaciones pueden compartir las bibliotecas; la desventaja es que el usuario debe instalar las bibliotecas de antemano, y tanto la versión como la ubicación de instalación deben cumplir los requisitos; de lo contrario, el programa no podrá ejecutarse correctamente.
En la práctica, la mayoría del software utiliza enlaces dinámicos y archivos de bibliotecas compartidas. Estos archivos de bibliotecas compartidas dinámicamente son archivos con extensión .so en la plataforma Linux, archivos .dll en la plataforma Windows y archivos .dylib en la plataforma Mac.
Fuente original: http://www.ruanyifeng.com/blog/2014/11/compiler.html