Creo que muchos amigos, al usar el lenguaje Perl, a menudo se encuentran con un problema: ¿Perl no admite chino? Al ingresar o generar chino en Perl, aparecen caracteres confusos. ¿Qué hacer entonces? A continuación, el editor les enseñará cómo resolver este problema.
Método/Pasos
Tomemos como ejemplo ActivePerl en Windows.
El código del editor es muy simple, solo una línea:
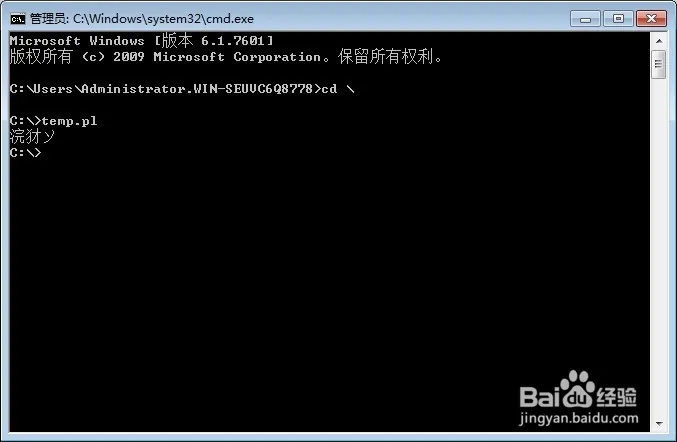
print "你好";
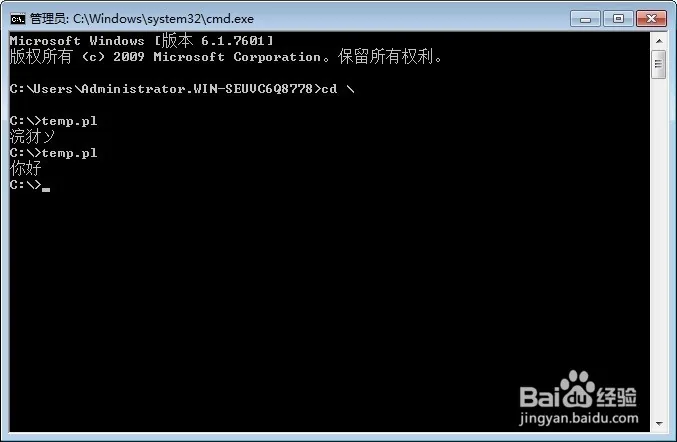
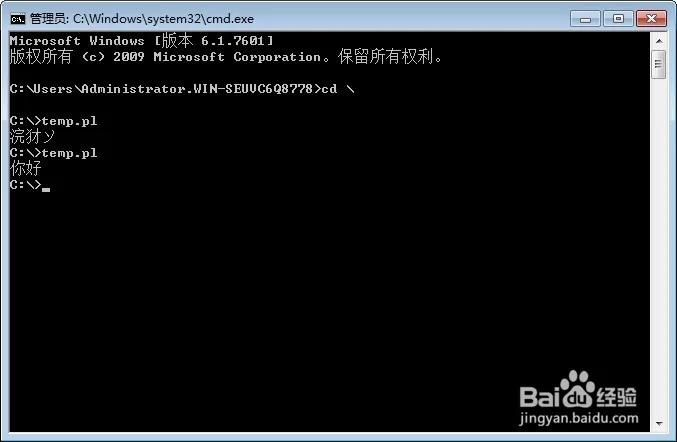
Pero aparecieron caracteres confusos, como se muestra en la figura.
Ante este problema, ¿qué debemos hacer?
En realidad, es un problema de codificación de Perl, y esto tiene que ver con la codificación de nuestro sistema operativo.
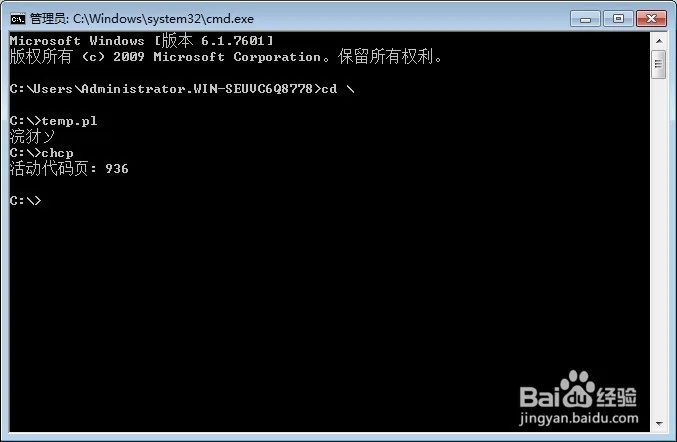
Abrimos el símbolo del sistema de cmd e ingresamos chcp para obtener el código del tipo de codificación.
Se puede ver que el Windows del editor aquí tiene el código 936 como formato de codificación predeterminado.
Luego podemos ver que la página de códigos 936 corresponde a gb2313 (es decir, chino), o más bien a gbk.
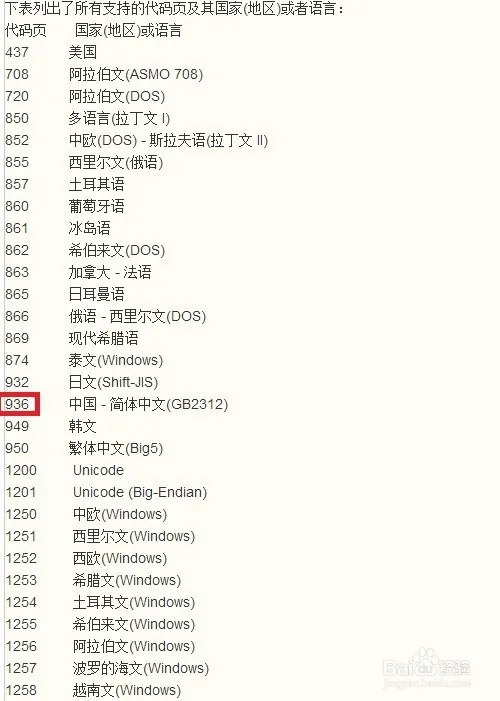
Sabemos que nuestro Windows usa la codificación gb2312; en este caso, solo tenemos que cambiar el formato de codificación.
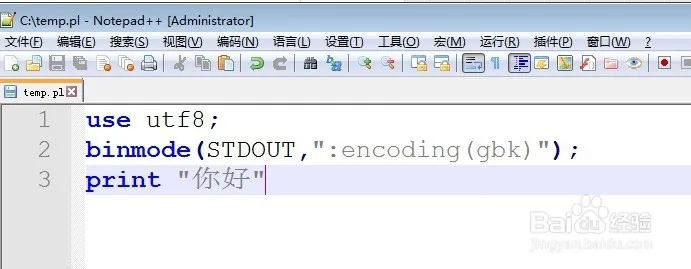
Ingresa al inicio del código:
use utf8;
#引入utf8模块 脚本内的字符串使用utf8作为编码格式

binmode(STDOUT,":encoding(gbk)");
#标准输出使用gbk作为编码格式,也可以把gbk改为gb2312

binmode(STDIN,":encoding(gbk)");
#如果涉及到输入流,例如读文件,不加这条读中文文件会出现乱码


binmode(STDERR,":encoding(gbk)");
#如果异常错误中的字符串有中文,请加上STDERR,否则也会出现乱码

print "你好";
¿Ahora sí se puede generar chino correctamente?
Hay que tener en cuenta un punto: si el código implica leer archivos en chino, hay que agregarbinmode(STDIN,":encoding(gbk)");。
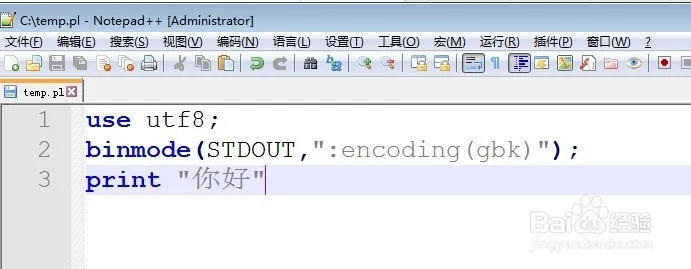
Hay otro método: para STDIN, STDOUT, STDERR (es decir, entrada estándar, salida estándar y error estándar), usar cierta codificación como formato de codificación para todos.
Sigue siendo ese pequeño programa simple, print genera un carácter chino.
El código es el siguiente:
use utf8;

use open ":encoding(gbk)",":std";
#标准输入、输出、错误皆用gbk编码格式进行编码

print "你好";
Dirección original: https://jingyan.baidu.com/article/4f7d5712fd36301a21192744.html