Я думаю, многие друзья часто сталкиваются с этой проблемой при использовании языка Perl: Perl не поддерживает китайский? При вводе или выводе китайского текста в Perl появляются искажённые символы. Что же делать? Ниже я научу друзей, как решить эту проблему.
Метод/Шаги
Возьмём ActivePerl в Windows в качестве примера.
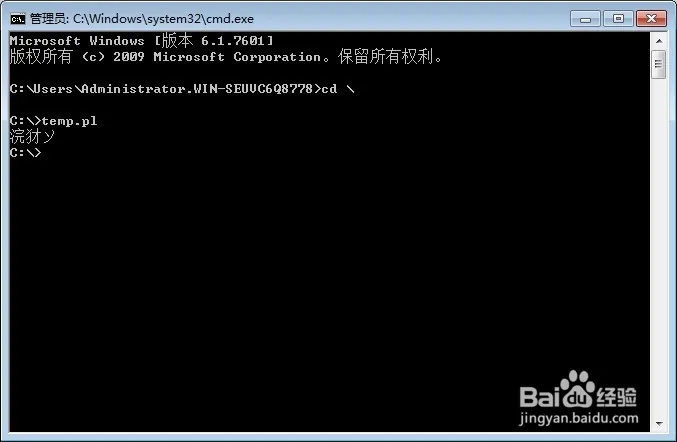
Мой код очень прост, всего одна строка:
print "你好";
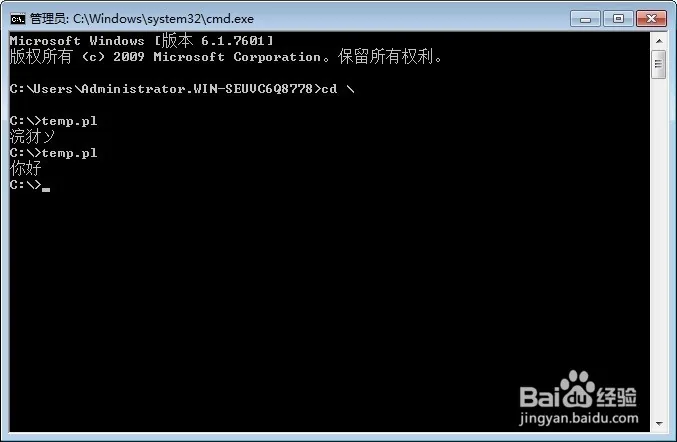
Но появились искажённые символы, как показано на рисунке.
Что делать, если мы столкнулись с такой проблемой?
На самом деле это проблема кодировки Perl, и она связана с кодировкой нашей операционной системы.
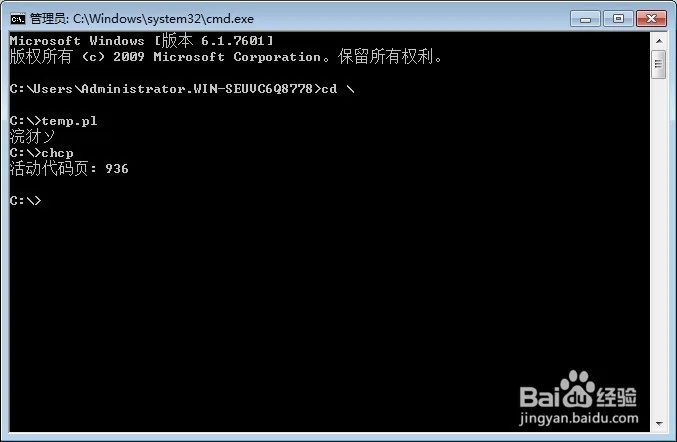
Мы открываем командную строку cmd и вводим chcp, чтобы получить код типа кодировки.
Видно, что Windows здесь использует кодовую страницу 936 в качестве кодировки по умолчанию.
Тогда мы видим, что кодовая страница 936 соответствует gb2313 (то есть китайской кодировке), а точнее gbk.
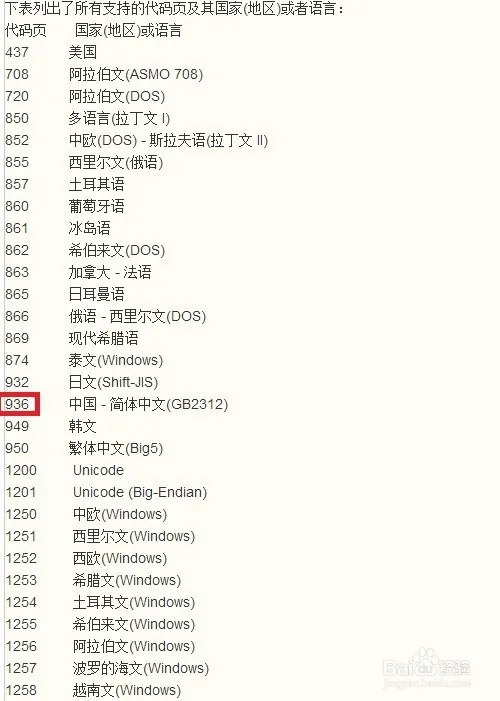
Теперь, когда мы знаем, что наша Windows использует кодировку gb2312, нам просто нужно изменить формат кодировки.
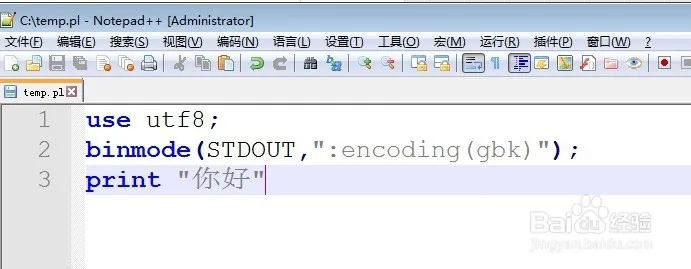
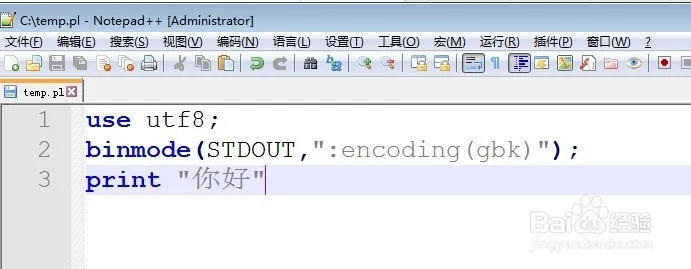
Введите следующее в начале кода:
use utf8;
#引入utf8模块 脚本内的字符串使用utf8作为编码格式

binmode(STDOUT,":encoding(gbk)");
#标准输出使用gbk作为编码格式,也可以把gbk改为gb2312

binmode(STDIN,":encoding(gbk)");
#如果涉及到输入流,例如读文件,不加这条读中文文件会出现乱码


binmode(STDERR,":encoding(gbk)");
#如果异常错误中的字符串有中文,请加上STDERR,否则也会出现乱码

print "你好";
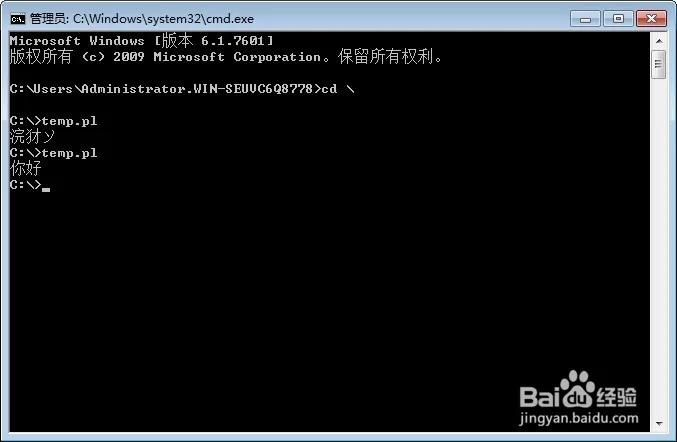
Сможет ли теперь китайский текст выводиться нормально?
На что стоит обратить внимание: если код включает чтение китайских файлов, обязательно добавьтеДобавьте binmode(STDIN,":encoding(gbk)");。
Есть еще один метод: для STDIN, STDOUT, STDERR (то есть стандартного ввода, стандартного вывода и стандартного потока ошибок), все используют определенную кодировку в качестве формата кодирования.
Все та же простая маленькая программа, использующая print для вывода китайской строки.
Код выглядит следующим образом:
use utf8;

use open ":encoding(gbk)",":std";
#标准输入、输出、错误皆用gbk编码格式进行编码

print "你好";
Исходный URL: https://jingyan.baidu.com/article/4f7d5712fd36301a21192744.html