Zeichensatz und Zeichenkodierung — Wissen, das jeder Softwareentwickler bedingungslos beherrschen sollte!
Ich glaube, jeder hat schon einmal erlebt, dass beim Öffnen einer Webseite ein Haufen Zeichensalat angezeigt wird? Erinnern Sie sich an die Header-Felder von HTTP-Nachrichten wie Accept-Charset, Accept-Encoding, Accept-Language, Content-Encoding, Content-Language? Das werden wir als Nächstes besprechen.
Inhaltsverzeichnis:
- 1. Grundlagen
- 2. Gängige Zeichensätze und Zeichenkodierungen
- 2.1. ASCII-Zeichensatz & Kodierung
- 2.2. GBXXXX-Zeichensatz & Kodierung
- 2.3. BIG5-Zeichensatz & Kodierung
- 3. Unicode-Zeichensatz & UTF-Kodierung
- 3.1.UCS & UNICODE
- 3.2.UTF-32
- 3.3.UTF-16
- 3.4.UTF-8
- 4.Accept-Charset/Accept-Encoding/Accept-Language/Content-Type/Content-Encoding/Content-Language
- 5. Referenzen & weiterführende Literatur
1. Grundlagen
Informationen, die in einem Computer gespeichert sind, werden durch Binärzahlen dargestellt; die englischen Zeichen, chinesischen Zeichen und anderen Zeichen, die wir auf dem Bildschirm sehen, sind das Ergebnis der Umwandlung von Binärzahlen. Einfach ausgedrückt werden die Regeln, nach denen Zeichen in einem Computer gespeichert werden, z. B. wodurch 'a' dargestellt wird, als „Kodierung“ bezeichnet; umgekehrt wird das Parsen und Anzeigen der in einem Computer gespeicherten Binärzahlen als „Dekodierung“ bezeichnet, ähnlich wie Verschlüsselung und Entschlüsselung in der Kryptografie. Bei der Dekodierung kann 'a' als 'b' oder als Zeichensalat interpretiert werden, wenn die falschen Dekodierungsregeln verwendet werden.
Zeichensatz (Charset): Er ist eine Sammlung aller von einem System unterstützten abstrakten Zeichen. Zeichen sind ein Oberbegriff für verschiedene Texte und Symbole, einschließlich nationaler Schriften, Satzzeichen, grafischer Symbole, Zahlen usw.
Zeichenkodierung: Sie ist eine Reihe von Regeln, mit denen eine Sammlung von Zeichen aus einer natürlichen Sprache (z. B. ein Alphabet oder eine Silbenschrift) einer anderen Sammlung (z. B. Zahlen oder elektrischen Impulsen) zugeordnet werden kann. Das heißt, sie stellt eine Entsprechung zwischen einem Symbolsatz und einem Zahlensystem her, und sie ist eine grundlegende Technologie in der Informationsverarbeitung. Menschen verwenden üblicherweise Symbolsätze (im Allgemeinen Text), um Informationen auszudrücken. Computergestützte Informationsverarbeitungssysteme verwenden Kombinationen unterschiedlicher Zustände von Komponenten (Hardware), um Informationen zu speichern und zu verarbeiten. Kombinationen unterschiedlicher Zustände von Komponenten können Zahlen in einem Zahlensystem darstellen. Daher ist die Zeichenkodierung die Umwandlung von Symbolen in Zahlen in einem Zahlensystem, das ein Computer akzeptieren kann, was als digitale Codes bezeichnet wird.
2. Gängige Zeichensätze und Zeichenkodierungen
Gängige Namen von Zeichensätzen: ASCII-Zeichensatz, GB2312-Zeichensatz, BIG5-Zeichensatz, GB18030-Zeichensatz, Unicode-Zeichensatz usw. Um Text in verschiedenen Zeichensätzen präzise zu verarbeiten, müssen Computer eine Zeichenkodierung durchführen, damit der Computer verschiedene Texte erkennen und speichern kann.
2.1. ASCII-Zeichensatz & Kodierung
ASCII (American Standard Code for Information Interchange) ist ein Computerkodierungssystem, das auf dem lateinischen Alphabet basiert. Es wird hauptsächlich zur Anzeige von modernem Englisch verwendet, und seine erweiterte Version EASCII kann kaum andere westeuropäische Sprachen anzeigen. Es ist derzeit das gebräuchlichste Ein-Byte-Kodierungssystem (zeigt aber Anzeichen dafür, von Unicode eingeholt zu werden) und entspricht dem internationalen Standard ISO/IEC 646.
ASCII-Zeichensatz: Er umfasst hauptsächlich Steuerzeichen (Wagenrücklauf, Rücktaste, Zeilenvorschub usw.); darstellbare Zeichen (englische Groß- und Kleinbuchstaben, arabische Ziffern und westliche Symbole).
ASCII-Kodierung: Die Regeln zur Umwandlung des ASCII-Zeichensatzes in Zahlen in einem Zahlensystem, das ein Computer akzeptieren kann. Sie verwendet 7 Bits, um ein Zeichen darzustellen, insgesamt 128 Zeichen; ein mit 7 Bits kodierter Zeichensatz kann jedoch nur 128 Zeichen unterstützen. Um häufiger verwendete europäische Zeichen darzustellen, wurde ASCII erweitert. Der erweiterte ASCII-Zeichensatz verwendet 8 Bits, um ein Zeichen darzustellen, insgesamt 256 Zeichen. Die Abbildungsregeln vom ASCII-Zeichensatz auf numerische Codes sind in der folgenden Abbildung dargestellt:
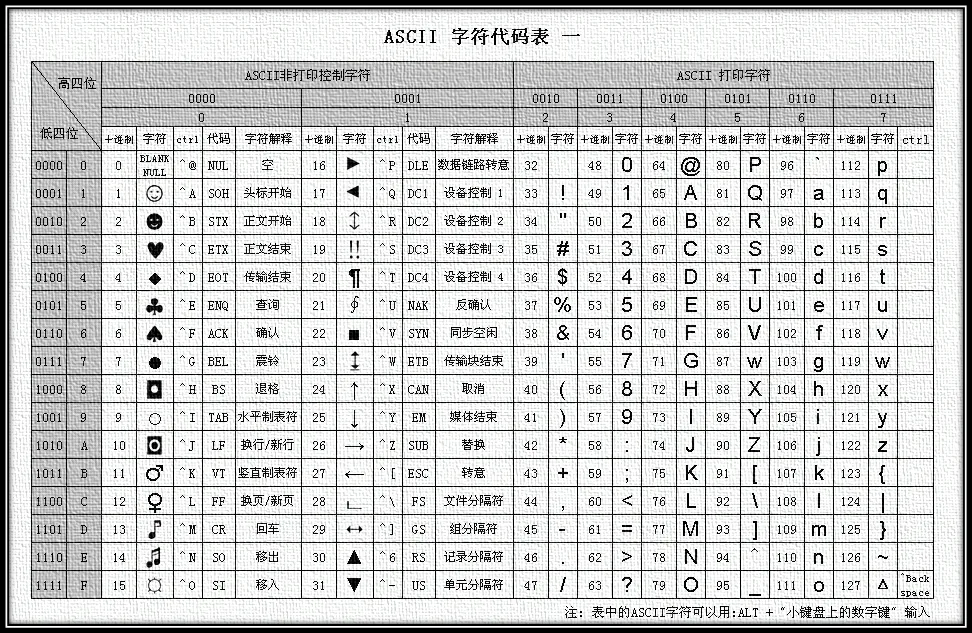
Abbildung 1 ASCII-Kodierungstabelle
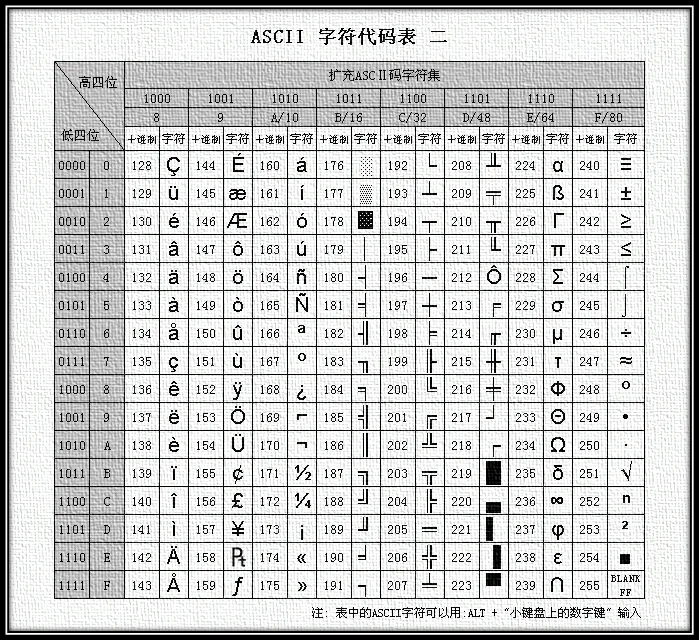
Abbildung 2 Erweiterte ASCII-Kodierungstabelle
Der größte Nachteil von ASCII ist, dass es nur 26 grundlegende lateinische Buchstaben, arabische Ziffern und britische Satzzeichen darstellen kann, sodass es nur zur Anzeige von modernem amerikanischem Englisch verwendet werden kann (und bei der Behandlung von Lehnwörtern im Englischen wie naïve, café, élite usw. müssen alle Akzentzeichen entfernt werden, selbst wenn dies gegen Rechtschreibregeln verstößt). EASCII löst zwar das Anzeigeproblem für einige westeuropäische Sprachen, ist aber für viele andere Sprachen nach wie vor hilflos. Daher haben Apple-Computer inzwischen ASCII aufgegeben und sind zu Unicode gewechselt.
2.2. GBXXXX-Zeichensatz & Kodierung
Zur Zeit der Erfindung des Computers und noch lange danach wurde er nur in den Vereinigten Staaten und einigen entwickelten westlichen Ländern verwendet, und ASCII erfüllte die Bedürfnisse der Nutzer gut. Doch als auch China Computer erhielt, war es zur Anzeige von Chinesisch notwendig, einen Satz von Kodierungsregeln zu entwerfen, um chinesische Schriftzeichen in Zahlen in einem numerischen System umzuwandeln, das Computer akzeptieren können.
Chinesische Experten entfernten die seltsamen Symbole nach 127 (d. h. EASCII) und legten fest: Ein Zeichen kleiner als 127 hat dieselbe Bedeutung wie zuvor, aber wenn zwei Zeichen größer als 127 zusammengefügt werden, stellen sie ein chinesisches Schriftzeichen dar. Das erste Byte (das sogenannte hohe Byte) reicht von 0xA1 bis 0xF7, und das zweite Byte (das niedrige Byte) reicht von 0xA1 bis 0xFE. Auf diese Weise können wir etwa 7.000+ vereinfachte chinesische Schriftzeichen kombinieren. In diesen Kodierungen wurden auch mathematische Symbole, römische und griechische Buchstaben und japanische Kana aufgenommen, und sogar die Zahlen, Satzzeichen und Buchstaben, die bereits in ASCII existierten, wurden alle mit Zwei-Byte-Längen neu kodiert. Diese werden gemeinhin als „Vollbreite“-Zeichen bezeichnet, während die ursprünglich unter 127 liegenden als „Halbbreite“-Zeichen bezeichnet werden.
Die oben genannten Kodierungsregeln sind GB2312. GB2312 oder GB2312-80 ist der chinesische nationale Standard für den vereinfachten chinesischen Zeichensatz, vollständiger Name "Code of Chinese Graphic Character Set for Information Interchange · Basic Set", auch bekannt als GB0, herausgegeben vom National Bureau of Standards of China und umgesetzt am 1. Mai 1981. Die GB2312-Kodierung ist in Festlandchina vorherrschend; Singapur und andere Orte verwenden diese Kodierung ebenfalls. Nahezu alle chinesischen Systeme und internationalisierte Software in Festlandchina unterstützen GB2312. Die Entstehung von GB2312 deckte im Wesentlichen den Bedarf der Computerverarbeitung chinesischer Zeichen, und die enthaltenen chinesischen Zeichen decken 99.75% der Nutzungshäufigkeit in Festlandchina ab. Für seltene Zeichen, die in Personennamen, klassischem Chinesisch usw. vorkommen, kann GB2312 sie nicht verarbeiten, was später zum Aufkommen der chinesischen Zeichensätze GBK und GB 18030 führte. Die folgende Abbildung zeigt den Anfangsteil der GB2312-Kodierung (da sie sehr groß ist, ist nur der Anfangsteil aufgeführt; Einzelheiten siehe die GB2312-Tabelle für vereinfachtes Chinesisch):
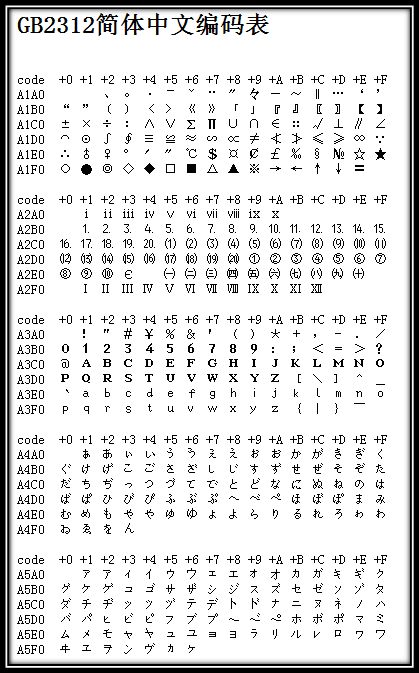
Abbildung 3 Anfangsteil der GB2312-Kodierungstabelle
Da GB 2312-80 nur 6,763 chinesische Schriftzeichen enthält, waren viele chinesische Schriftzeichen nicht enthalten, wie zum Beispiel einige Zeichen, die nach der Einführung von GB 2312-80 vereinfacht wurden (z. B. „啰“), einige in Personennamen verwendete Zeichen (z. B. „镕“ von dem früheren chinesischen Premierminister Zhu Rongji), in Taiwan und Hongkong verwendete traditionelle chinesische Schriftzeichen sowie in Japanisch und Koreanisch verwendete chinesische Schriftzeichen usw. Daher nutzte Microsoft den ungenutzten Codierungsraum in GB 2312-80 und integrierte alle Zeichen von GB 13000.1-93, um die GBK-Codierung zu entwickeln. Laut Microsoft-Dokumentation ist GBK eine Erweiterung von GB2312-80, das heißt eine Erweiterung der CP936-Codepage (zuvor war CP936 genau identisch mit GB 2312-80), erstmals implementiert in der vereinfachtchinesischen Version von Windows 95. Obwohl GBK alle Zeichen von GB 13000.1-93 enthält, ist die Codierungsmethode anders. GBK selbst ist kein nationaler Standard; es wurde lediglich als „technisches Spezifikations-Leitdokument“ von der Abteilung für Standardisierung des ehemaligen Staatlichen Amtes für technische Aufsicht und der Abteilung für Wissenschaft, Technologie und Qualitätsaufsicht des Ministeriums für Elektronikindustrie veröffentlicht. Das ursprüngliche GB13000 wurde von der Industrie nie übernommen, und der nachfolgende nationale Standard GB18030 ist technisch mit GBK statt mit GB13000 kompatibel.
GB 18030, vollständiger Name: Nationaler Standard GB 18030-2005 „Informationstechnik — Chinesischer codierter Zeichensatz“, ist der derzeit neueste interne Zeichensatz der Volksrepublik China. Er ist eine Überarbeitung von GB 18030-2000 „Informationstechnik — Code des chinesischen grafischen Zeichensatzes für den Informationsaustausch — Erweiterung des Basissatzes“. Er ist vollständig kompatibel mit GB 2312-1980, im Wesentlichen kompatibel mit GBK, unterstützt alle vereinheitlichten chinesischen Schriftzeichen in GB 13000 und Unicode und enthält insgesamt 70,244 chinesische Schriftzeichen. GB 18030 weist hauptsächlich folgende Merkmale auf:
- Wie UTF-8 verwendet es Multibyte-Kodierung, und jedes Zeichen kann aus 1, 2 oder 4 Bytes bestehen.
- Der Kodierungsraum ist enorm und kann bis zu 1.61 Millionen Zeichen definieren.
- Es unterstützt die Schriften ethnischer Minderheiten in China, ohne den Private Use Area verwenden zu müssen.
- Der Umfang der erfassten chinesischen Schriftzeichen umfasst traditionelle chinesische Schriftzeichen sowie japanische und koreanische Schriftzeichen (Han-Zeichen).
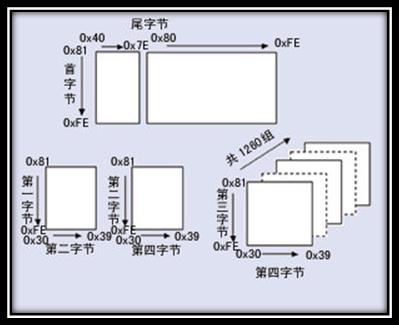
Abbildung 4 Gesamtstruktur der GB18030-Kodierung
Die erste Version dieser Spezifikation wurde vom Institute of Electronic Industry Standardization des Ministeriums für Informationsindustrie der Volksrepublik China entworfen und am 17. März 2000 vom Staatlichen Amt für Qualitäts- und technische Überwachung herausgegeben. Die aktuelle Version wurde am 8. November 2005 von der Generalverwaltung für Qualitätsaufsicht, Inspektion und Quarantäne und der Standardisierungsverwaltung Chinas herausgegeben und am 1. Mai 2006 umgesetzt. Diese Spezifikation ist für alle Softwareprodukte in China verbindlich.
2.3. BIG5-Zeichensatz & Kodierung
. Unicode wird ständig erweitert; jede neue Version fügt weitere neue Zeichen ein. Bis zur aktuellen sechsten Version enthält Unicode bereits mehr als 100,000 Zeichen (im Jahr 2005 wurde Unicodes 100,000stes Zeichen angenommen und als einer der Standards anerkannt), eine Reihe von Code-Diagrammen, die als visuelle Referenzen verwendet werden können, eine Reihe von Kodierungsmethoden und eine Standardzeichenkodierung sowie eine Aufzählung, die Zeicheneigenschaften wie hochgestellte und tiefgestellte Zeichen usw. enthält. Das Unicode-Konsortium wird von einer gemeinnützigen Organisation betrieben und führt Unicodes Weiterentwicklung. Sein Ziel ist es, bestehende Zeichenkodierungsschemata durch Unicode-Kodierungsschemata zu ersetzen, insbesondere weil bestehende Schemata nur begrenzten Platz und Inkompatibilitätsprobleme in mehrsprachigen Umgebungen aufweisen.
Big5 ist ein Doppelbyte-Zeichensatz, der ein Zwei-Acht-Bit-Speicherverfahren verwendet, bei dem ein Zeichen in zwei Bytes abgelegt wird. Das erste Byte wird als „hohes Byte“ (high byte) bezeichnet, das zweite Byte als „niedriges Byte“ (low byte). Das „hohe Byte“ verwendet 0x81-0xFE, und das „niedrige Byte“ verwendet 0x40-0x7E und 0xA1-0xFE. In Big5-Unterteilungen:
| 0x8140-0xA0FE | Reserviert für benutzerdefinierte Zeichen (Zeichenerstellungszone). |
| 0xA140-0xA3BF |
Interpunktion, griechische Buchstaben und Sonderzeichen, einschließlich 0xA259-0xA261, die neun chinesische Maßeinheiten-Zeichen enthalten: 兙兛兞兝兡兣嗧瓩糎. |
| 0xA3C0-0xA3FE | Reserviert. Dieser Bereich ist nicht für benutzerdefinierte Zeichen geöffnet. |
| 0xA440-0xC67E | Gebräuchliche chinesische Schriftzeichen, zuerst nach Strichzahl und dann nach Radikal sortiert. |
| 0xC6A1-0xC8FE | Reserviert für benutzerdefinierte Zeichen (Zeichenerstellungszone). |
| 0xC940-0xF9D5 | Weniger gebräuchliche chinesische Schriftzeichen, ebenfalls zuerst nach Strichzahl und dann nach Radikal sortiert. |
| 0xF9D6-0xFEFE | Reserviert für benutzerdefinierte Zeichen (Zeichenerstellungszone). |
3. Unicode-Zeichensatz & UTF-Kodierung
Die großartige Idee Unicode– Unicode verdient eine eigene separate Diskussion
Wie das Himmlische Reich: Als sich Computer in verschiedene Länder rund um die Welt verbreiteten, wurden, um lokale Sprachen und Schriftzeichen abzubilden, Kodierungsschemata ähnlich wie GB232/GBK/GB18030/BIG5 entworfen und implementiert. So hat jede Region ihr eigenes System; lokal funktioniert es einwandfrei, aber sobald man in einem Netzwerk ist, erscheinen wegen Inkompatibilität verstümmelte Zeichen beim Zugriff auf die Daten der jeweils anderen.
Um dieses Problem zu lösen, wurde eine großartige Idee geboren – Unicode. Das Unicode-Kodierungssystem ist darauf ausgelegt, jedes Zeichen jeder Sprache darzustellen. Es verwendet 4-Byte-Zahlen, um jeden Buchstaben, jedes Symbol oder jedes Ideogramm darzustellen. Jede Zahl repräsentiert ein eindeutiges Symbol, das in mindestens einer Sprache verwendet wird. (Nicht alle Zahlen werden verwendet, aber die Gesamtzahl überschreitet bereits 65,535, sodass Zwei-Byte-Zahlen nicht ausreichen.) Zeichen, die von mehreren Sprachen gemeinsam genutzt werden, werden normalerweise mit derselben Zahl kodiert, es sei denn, es gibt einen vernünftigen etymologischen Grund, dies nicht zu tun. Abgesehen von solchen Fällen entspricht jedes Zeichen einer Zahl und jede Zahl einem Zeichen. Es gibt keine Mehrdeutigkeit. Es ist nicht nötig, "Modus" aufzuzeichnen. U+0041 repräsentiert immer 'A', selbst wenn die Sprache das Zeichen 'A' nicht besitzt.
Auf dem Gebiet der Informatik ist Unicode (统onecode, 万国code, 单onecode, Standard万国code) ein Industriestandard, der es Computern ermöglicht, Systeme von Dutzenden von Schriften aus der ganzen Welt darzustellen. Unicode wurde auf Grundlage des Universal Character Set-Standards entwickelt und wird auch in Buchform veröffentlicht
(Man kann es so verstehen: Unicode ist der Zeichensatz; UTF-32/UTF-16/UTF-8 sind drei Zeichenkodierungsschemata.)
3.1.UCS & UNICODE
Universal Character Set(Universal Character Set,UCS) wird von ISOISO 10646(oderISO/IEC 10646) standarddefinierter Standard-Zeichensatz.
Um 1991 erkannten die Beteiligten beider Projekte, dass die Welt nicht zwei inkompatible Zeichensätze brauchte. Also begannen sie, ihre Arbeitsergebnisse zusammenzuführen und zusammenzuarbeiten, um eine einzige Kodierungstabelle zu erstellen. Ab Unicode 2.0 übernahm Unicode denselben Zeichenvorrat und dieselben Codepunkte wie ISO 10646-1; ISO versprach außerdem, dass ISO 10646 für die UCS-4-Kodierung keine Werte über U+10FFFF hinaus zuweisen würde, um die beiden konsistent zu halten. Beide Projekte existieren weiterhin und veröffentlichen unabhängig ihre eigenen Standards. Aber das Unicode Consortium und ISO/IEC JTC1/SC2 haben vereinbart, die Codetabellen der beiden Standards kompatibel zu halten und alle künftigen Erweiterungen eng abzustimmen. Bei der Veröffentlichung übernimmt Unicode im Allgemeinen die gebräuchlichsten Glyphen für die betreffenden Codepunkte, während ISO 10646 im Allgemeinen so weit wie möglich die Century-Schriftart verwendet.
3.2.UTF-32
Das oben beschriebene Kodierungsschema, das 4-Byte-Zahlen verwendet, um jeden Buchstaben, jedes Symbol oder jedes Ideogramm darzustellen, wobei jede Zahl ein eindeutiges Symbol repräsentiert, das in mindestens einer Sprache verwendet wird, heißt UTF-32. UTF-32 ist auch bekannt alsUCS-4ein Protokoll zur Kodierung von Unicode-Zeichen, das 4 Bytes für jedes Zeichen verwendet. Vom Platzbedarf her ist es sehr ineffizient.
Diese Methode hat ihre Vorteile; der wichtigste ist, dass das N-te Zeichen in einer Zeichenkette in konstanter Zeit gefunden werden kann, weil das N-te Zeichen beim 4×N-ten Byte beginnt. Obwohl es praktisch erscheinen mag, für jeden Codepunkt Bytes fester Länge zu verwenden, ist es nicht so weit verbreitet wie andere Unicode-Kodierungen.
3.3.UTF-16
Obwohl es viele Unicode-Zeichen gibt, verwenden in der Realität die meisten Menschen keine Zeichen jenseits der ersten 65,535. Daher wurde eine andere Unicode-Kodierungsmethode entwickelt, UTF-16 genannt (weil 16 Bit = 2 Bytes). UTF-16 kodiert Zeichen im Bereich 0–65,535 als 2 Bytes. Wenn Sie wirklich diese selten verwendeten Unicode-Zeichen in der "astralen Ebene" jenseits des Bereichs 65,535 darstellen müssen, sind einige knifflige Techniken erforderlich. Der offensichtlichste Vorteil der UTF-16-Kodierung ist, dass sie doppelt so speicherplatzeffizient wie UTF-32 ist, weil jedes Zeichen nur 2 Bytes zum Speichern benötigt (außer jenseits des Bereichs 65,535) statt 4 Bytes in UTF-32. Wenn wir außerdem annehmen, dass eine Zeichenkette keine Zeichen der astralen Ebene enthält, können wir das N-te Zeichen weiterhin in konstanter Zeit finden; solange diese Annahme nicht fehlschlägt, ist dies immer eine gute Schlussfolgerung. Ihre Kodierungsmethode ist:
- Wenn der Zeichencode U kleiner als 0x10000 ist, also im dezimalen Bereich 0 bis 65,535 liegt, wird er direkt durch zwei Bytes dargestellt;
- Wenn der Zeichencode U größer als 0x10000 ist, da der maximale Unicode-Kodierungsbereich 0x10FFFF beträgt, gibt es 0xFFFFF Codes zwischen 0x10000 und 0x10FFFF, was bedeutet, dass nur 20 Bits benötigt werden, um diese Codes darzustellen. U' repräsentiere den Wert zwischen 0 und 0xFFFFF. Nehmen Sie die ersten 10 Bits als die hohen Bits und führen Sie ein logisches ODER mit dem 16-Bit-Wert 0xD800 durch; nehmen Sie die letzten 10 Bits als die niedrigen Bits und führen Sie ein logisches ODER mit 0xDC00 durch. Die resultierenden 4 Bytes bilden die Kodierung von U.
Es gibt weitere weniger offensichtliche Nachteile der UTF-32- und UTF-16-Kodierungsmethoden. Verschiedene Computersysteme speichern Bytes in unterschiedlicher Reihenfolge. Das bedeutet, dass das Zeichen U+4E2D bei UTF-16-Kodierung als 4E 2D oder 2D 4E gespeichert werden kann, je nachdem, ob das System Big-Endian oder Little-Endian verwendet.(Für UTF-32-Kodierung gibt es sogar noch mehr mögliche Byte-Anordnungen.)Solange das Dokument Ihren Computer nicht verlässt, ist es weiterhin sicher – verschiedene Programme auf demselben Computer verwenden dieselbe Byte-Reihenfolge. Wenn wir dieses Dokument jedoch zwischen Systemen übertragen müssen, vielleicht im World Wide Web, benötigen wir eine Methode, um anzugeben, wie unsere Bytes derzeit gespeichert sind. Andernfalls kann der Computer, der das Dokument empfängt, nicht wissen, ob die zwei Bytes 4E 2D U+4E2D oder U+2D4E darstellen.
Um dieses Problem zu lösen, definieren die Mehrbyte-Unicode-Kodierungsmethoden ein „Byte Order Mark“, ein spezielles nicht druckbares Zeichen, das Sie am Anfang eines Dokuments einfügen können, um die von Ihnen verwendete Byte-Reihenfolge anzugeben. Bei UTF-16 lautet das Byte Order Mark U+FEFF. Wenn Sie ein UTF-16-kodiertes Dokument erhalten, das mit den Bytes FF FE beginnt, können Sie feststellen, dass seine Byte-Reihenfolge in der einen Richtung vorliegt; wenn es mit FE FF beginnt, können Sie feststellen, dass die Byte-Reihenfolge umgekehrt ist.
3.4.UTF-8
UTF-8 (8-Bit Unicode Transformation Format) ist eine Zeichenkodierung variabler Länge (Code variabler Länge) für Unicode und außerdem ein Präfixcode. Sie kann verwendet werden, um jedes Zeichen im Unicode-Standard darzustellen, und das erste Byte ihrer Kodierung ist weiterhin mit ASCII kompatibel, wodurch Software, die ursprünglich ASCII-Zeichen verarbeitete, ohne Änderungen oder nur mit geringfügigen Anpassungen weiterverwendet werden kann. Daher ist sie nach und nach zur bevorzugten Kodierung in E-Mail, Webseiten und anderen Anwendungen geworden, die Text speichern oder übertragen. Die Internet Engineering Task Force (IETF) verlangt, dass alle Internetprotokolle die UTF-8-Kodierung unterstützen.
UTF-8 verwendet ein bis vier Bytes, um jedes Zeichen zu kodieren:
- 128 US-ASCII-Zeichen benötigen nur ein Byte zur Kodierung (Unicode-Bereich von U+0000 bis U+007F).
- 2. Lateinisch mit diakritischen Zeichen, Griechisch, Kyrillisch, Armenisch, Hebräisch, Arabisch, Syrisch und Thaana-Buchstaben erfordern eine Zwei-Byte-Kodierung (Unicode-Bereich U+0080 bis U+07FF).
- Andere Zeichen in der Basic Multilingual Plane (BMP) (die die meisten häufig verwendeten Zeichen enthält) verwenden eine Drei-Byte-Kodierung.
- Zeichen in anderen selten verwendeten Unicode-Ergänzungsebenen verwenden eine Vier-Byte-Kodierung.
Es ist sehr effizient im Umgang mit häufig verwendeten ASCII-Zeichen. Im Umgang mit erweiterten lateinischen Zeichensätzen ist es UTF-16 auch nicht unterlegen. Bei chinesischen Zeichen ist es besser als UTF-32. Gleichzeitig (das müssen Sie mir einfach glauben, denn ich habe nicht vor, Ihnen die Mathematik dahinter zu zeigen.) Aufgrund der Natur von Bitoperationen hat UTF-8 das Byte-Reihenfolgeproblem nicht mehr. Ein in UTF-8 kodiertes Dokument ist auf verschiedenen Computern derselbe Bitstrom.
Im Allgemeinen ist es bei einer Unicode-Zeichenkette unmöglich, aus der Anzahl der Codepunkte die für ihre Anzeige benötigte Länge zu bestimmen oder die Position, an der der Cursor nach der Anzeige der Zeichenkette im Textpuffer platziert werden sollte; kombinierende Zeichen, Schriftarten mit variabler Breite, nicht druckbare Zeichen und von rechts nach links verlaufender Text sind allesamt beitragende Faktoren. Obwohl also die Beziehung zwischen der Anzahl der Zeichen und der Anzahl der Codepunkte in UTF-8-Zeichenketten komplexer ist als in UTF-32, gibt es in der Praxis selten Fälle, in denen dies einen Unterschied macht.
Vorteile
- UTF-8 ist eine Obermenge von ASCII. Da eine reine ASCII-Zeichenkette auch eine gültige UTF-8-Zeichenkette ist, muss vorhandener ASCII-Text nicht konvertiert werden. Software, die für traditionelle erweiterte ASCII-Zeichensätze entwickelt wurde, kann in der Regel ohne oder mit nur sehr geringen Änderungen mit UTF-8 arbeiten.
- Das Sortieren von UTF-8 mit standardmäßigen byteorientierten Sortierroutinen liefert dieselben Ergebnisse wie das Sortieren anhand von Unicode-Codepunkten. (Obwohl dies nur von begrenztem Nutzen ist, da es unwahrscheinlich ist, dass in einer bestimmten Sprache oder Kultur eine noch akzeptable Zeichenreihenfolge existiert.)
- Sowohl UTF-8 als auch UTF-16 sind Standardkodierungen für Dokumente der Extensible Markup Language (XML). Alle anderen Kodierungen müssen durch eine explizite oder textuelle Deklaration angegeben werden.
- Jeder byteorientierte Zeichenfolgen-Suchalgorithmus kann auf UTF-8-Daten angewendet werden (solange die Eingabe nur aus vollständigen UTF-8-Zeichen besteht). Bei regulären Ausdrücken oder anderen Konstrukten, die Zeichenzählung enthalten, ist jedoch Vorsicht geboten.
- UTF-8-Zeichenfolgen können mit einem einfachen Algorithmus zuverlässig identifiziert werden. Das heißt, die Wahrscheinlichkeit, dass eine Zeichenfolge in einer anderen Kodierung als gültiges UTF-8 erscheint, ist sehr gering, und sie nimmt mit zunehmender Länge der Zeichenfolge ab. Beispielsweise treten die Zeichenwerte C0, C1, F5 bis FF nie auf. Für mehr Zuverlässigkeit können reguläre Ausdrücke verwendet werden, um illegale überlange und Surrogatwerte zu erkennen (sieheW3 FAQ: Mehrsprachige Formulareder reguläre Ausdruck zum Validieren von UTF-8-Zeichenfolgen auf).
Nachteile
Da jedes Zeichen mit einer unterschiedlichen Anzahl von Bytes kodiert wird, ist das Finden des N-ten Zeichens in einer Zeichenfolge eine Operation mit O(N)-Komplexität – das heißt, je länger die Zeichenfolge ist, desto mehr Zeit wird benötigt, um ein bestimmtes Zeichen zu finden. Gleichzeitig ist auch Bitmanipulation erforderlich, um Zeichen in Bytes zu kodieren und Bytes in Zeichen zu dekodieren.
4.Accept-Charset/Accept-Encoding/Accept-Language/Content-Type/Content-Encoding/Content-Language
In HTTP sind die Nachrichten-Header in Bezug auf Zeichensatz und Zeichenkodierung Accept-Charset/Content-Type; außerdem ist die Hauptunterscheidung zwischen Accept-Charset/Accept-Encoding/Accept-Language/Content-Type/Content-Encoding/Content-Language:
Accept-Charset: Der Browser deklariert den Zeichensatz, den er akzeptiert. Dies sind die verschiedenen Zeichensätze und Zeichenkodierungen, die weiter oben in diesem Artikel vorgestellt wurden, wie gb2312, utf-8 (wenn wir üblicherweise Charset sagen, schließt dies das entsprechende Zeichenkodierungsschema ein);
Accept-Encoding: Der Browser deklariert die Kodierungsmethoden, die er akzeptiert, wobei üblicherweise Komprimierungsmethoden angegeben werden, ob Komprimierung unterstützt wird und welche Komprimierungsmethoden unterstützt werden (gzip, deflate). (Hinweis: Dies ist nicht nur Zeichenkodierung);
Accept-Language: Der Browser gibt die Sprache an, die er akzeptiert. Der Unterschied zwischen Sprache und Zeichensatz: Chinesisch ist eine Sprache, und Chinesisch hat mehrere Zeichensätze, wie big5, gb2312, gbk usw.;
Content-Type: Der Webserver teilt dem Browser den Typ und den Zeichensatz des Objekts in seiner Antwort mit. Zum Beispiel: Content-Type: text/html; charset='gb2312'
Content-Encoding: Der Webserver gibt an, mit welcher Komprimierungsmethode (gzip, deflate) er das Objekt in der Antwort komprimiert hat. Zum Beispiel: Content-Encoding: gzip
Content-Language: Der Webserver teilt dem Browser die Sprache des Objekts in seiner Antwort mit.
5. Referenzen & weiterführende Literatur
- Baidu Baike. Zeichensatz.http://baike.baidu.com/view/51987.htm, 2010-12-28
- Wikipedia. Zeichenkodierung.http://zh.wikipedia.org/wiki/%E5%AD%97%E7%AC%A6%E7%BC%96%E7%A0%81, 2011-1-5
- Wikipedia. ASCII.http://zh.wikipedia.org/wiki/ASCII, 2011-4-5
- Wikipedia. GB2312.http://zh.wikipedia.org/wiki/GB_2312, 2011-3-17
- Wikipedia. GB18030.http://zh.wikipedia.org/wiki/GB_18030, 2010-3-10
- Wikipedia. GBK.http://zh.wikipedia.org/wiki/GBK, 2011-3-7
- Wikipedia. Unicode.http://zh.wikipedia.org/wiki/Unicode, 2011-4-30
- Laruence. Ausführliche Erklärung der Zeichenkodierung (Grundlagen).http://www.laruence.com/2009/08/22/1059.html, 2009-8-22
- Jan Hunt. Zeichensätze und Kodierung für Webdesigner - UCS/UNICODE. http://www.uninetnews.com/other_standards/charset.php
Autor: Wu Qin
Quelle: http://www.cnblogs.com/skynet/archive/2011/05/03/2035105.html