Jeu de caractères et encodage des caractères — Une connaissance que tout développeur de logiciels devrait impérativement maîtriser !
Je pense que tout le monde a déjà ouvert une page web et vu un tas de texte illisible ? Vous souvenez-vous des champs d'en-tête de message dans HTTP tels que Accept-Charset, Accept-Encoding, Accept-Language, Content-Encoding, Content-Language ? C'est ce que nous allons aborder ensuite.
Table des matières :
- 1. Connaissances de base
- 2. Jeux de caractères et encodages de caractères courants
- 2.1. Jeu de caractères & encodage ASCII
- 2.2. Jeu de caractères & encodage GBXXXX
- 2.3. Jeu de caractères & encodage BIG5
- 3. Jeu de caractères Unicode & encodage UTF
- 3.1.UCS & UNICODE
- 3.2.UTF-32
- 3.3.UTF-16
- 3.4.UTF-8
- 4.Accept-Charset/Accept-Encoding/Accept-Language/Content-Type/Content-Encoding/Content-Language
- 5. Références et lectures complémentaires
1. Connaissances de base
Les informations stockées dans un ordinateur sont représentées par des nombres binaires ; les caractères anglais, les caractères chinois et les autres caractères que nous voyons à l'écran sont le résultat de la conversion de nombres binaires. En termes simples, les règles selon lesquelles les caractères sont stockés dans un ordinateur, par exemple par quoi 'a' est représenté, sont appelées « encodage » ; inversement, l'analyse et l'affichage des nombres binaires stockés dans un ordinateur sont appelés « décodage », de manière similaire au chiffrement et au déchiffrement en cryptographie. Lors du décodage, si de mauvaises règles de décodage sont utilisées, 'a' peut être analysé comme 'b' ou comme du texte brouillé.
Jeu de caractères (Charset): Il s'agit d'un ensemble de tous les caractères abstraits pris en charge par un système. Les caractères sont un terme générique désignant divers textes et symboles, y compris les écritures nationales, les signes de ponctuation, les symboles graphiques, les nombres, etc.
Encodage des caractères: Il s'agit d'un ensemble de règles permettant d'associer une collection de caractères d'une langue naturelle (comme un alphabet ou un syllabaire) à une autre collection (comme des nombres ou des impulsions électriques). C'est-à-dire qu'il établit une correspondance entre un ensemble de symboles et un système numérique, et c'est une technologie fondamentale dans le traitement de l'information. Les gens utilisent généralement des ensembles de symboles (généralement du texte) pour exprimer des informations. Les systèmes de traitement de l'information informatisés utilisent des combinaisons de différents états de composants (matériel) pour stocker et traiter l'information. Les combinaisons de différents états de composants peuvent représenter des nombres dans un système numérique. Par conséquent, l'encodage des caractères est la conversion de symboles en nombres dans un système numérique qu'un ordinateur peut accepter, appelés codes numériques.
2. Jeux de caractères et encodages de caractères courants
Noms courants de jeux de caractères : jeu de caractères ASCII, jeu de caractères GB2312, jeu de caractères BIG5, jeu de caractères GB18030, jeu de caractères Unicode, etc. Pour traiter avec précision du texte dans divers jeux de caractères, les ordinateurs doivent effectuer un encodage de caractères afin que l'ordinateur puisse reconnaître et stocker divers textes.
2.1. Jeu de caractères & encodage ASCII
ASCII (American Standard Code for Information Interchange) est un système d'encodage informatique basé sur l'alphabet latin. Il est principalement utilisé pour afficher l'anglais moderne, et sa version étendue EASCII peut à peine afficher d'autres langues d'Europe occidentale. Il est actuellement le système d'encodage à un octet le plus courant (mais montre des signes d'être rattrapé par Unicode) et équivaut à la norme internationale ISO/IEC 646.
Jeu de caractères ASCII: Il comprend principalement des caractères de contrôle (retour chariot, retour arrière, saut de ligne, etc.) ; des caractères affichables (caractères anglais majuscules et minuscules, chiffres arabes et symboles occidentaux).
Encodage ASCII: Les règles de conversion du jeu de caractères ASCII en nombres dans un système numérique que l'ordinateur peut accepter. Il utilise 7 bits pour représenter un caractère, soit 128 caractères au total ; cependant, un jeu de caractères codé sur 7 bits ne peut prendre en charge que 128 caractères. Pour représenter davantage de caractères européens couramment utilisés, l'ASCII a été étendu. Le jeu de caractères ASCII étendu utilise 8 bits pour représenter un caractère, soit 256 caractères au total. Les règles de correspondance du jeu de caractères ASCII vers des codes numériques sont présentées dans la figure suivante :
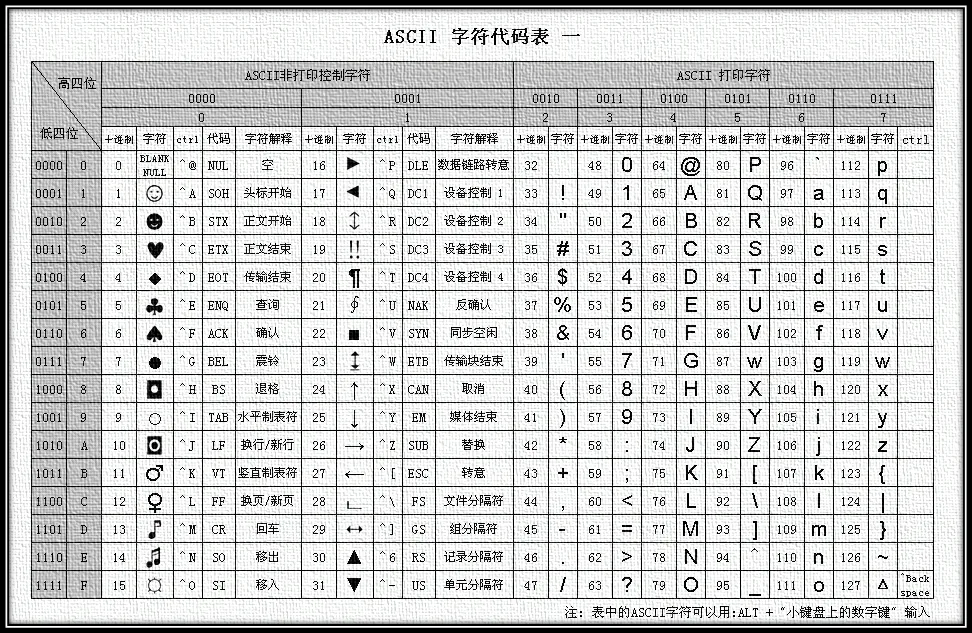
Figure 1 Tableau d'encodage ASCII
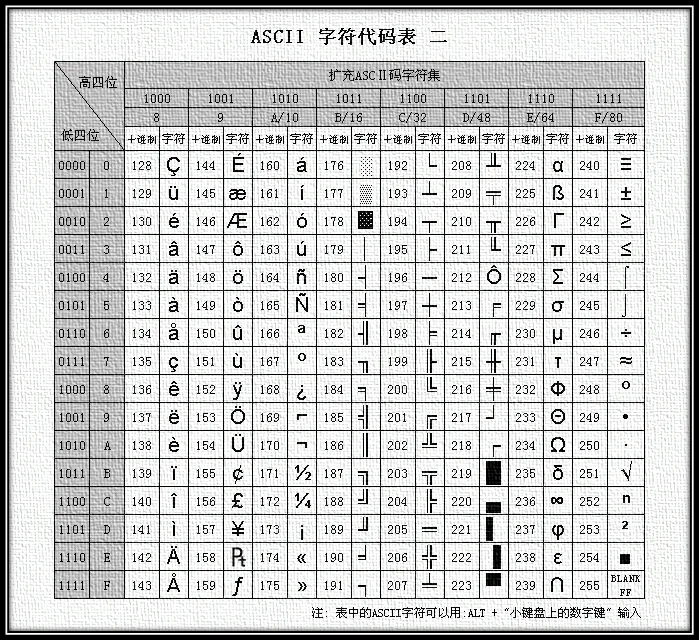
Figure 2 Tableau d'encodage ASCII étendu
Le plus grand inconvénient de l'ASCII est qu'il ne peut afficher que 26 lettres latines de base, les chiffres arabes et la ponctuation britannique, de sorte qu'il ne peut servir qu'à afficher l'anglais américain moderne (et lorsqu'il s'agit de mots d'emprunt en anglais comme naïve, café, élite, etc., tous les signes diacritiques doivent être supprimés, même si cela enfreint les règles orthographiques). L'EASCII, bien qu'il résolve le problème d'affichage de certaines langues d'Europe occidentale, reste impuissant pour de nombreuses autres langues. C'est pourquoi les ordinateurs Apple ont désormais abandonné l'ASCII et sont passés à l'Unicode.
2.2. Jeu de caractères & encodage GBXXXX
À l'époque de l'invention de l'ordinateur et pendant longtemps après, celui-ci n'était utilisé qu'aux États-Unis et dans certains pays occidentaux développés, et l'ASCII satisfaisait bien les besoins des utilisateurs. Mais lorsque la Chine a elle aussi eu des ordinateurs, afin d'afficher le chinois, il a fallu concevoir un ensemble de règles d'encodage pour convertir les caractères chinois en nombres dans un système numérique que les ordinateurs peuvent accepter.
Les experts chinois ont supprimé les symboles étranges après 127 (c'est-à-dire EASCII) et ont stipulé : un caractère inférieur à 127 a la même signification qu'avant, mais lorsque deux caractères supérieurs à 127 sont réunis, ils représentent un caractère chinois. Le premier octet (appelé octet de poids fort) va de 0xA1 à 0xF7, et le second octet (octet de poids faible) va de 0xA1 à 0xFE. De cette façon, on peut combiner environ 7,000+ caractères chinois simplifiés. Dans ces encodages, les symboles mathématiques, les lettres romaines et grecques et les kana japonais étaient également inclus, et même les nombres, la ponctuation et les lettres qui existaient déjà en ASCII ont tous été réencodés avec une longueur de deux octets. On les appelle communément des caractères « pleine largeur », tandis que ceux qui étaient à l'origine inférieurs à 127 sont appelés caractères « demi-largeur ».
Les règles d'encodage ci-dessus sont GB2312. GB2312 ou GB2312-80 est le jeu de caractères chinois simplifiés standard national chinois, nom complet « Code des jeux de caractères graphiques chinois pour l'échange d'informations · Jeu de base », également connu sous le nom de GB0, publié par le Bureau national des normes de Chine et mis en œuvre le 1er mai 1981. L'encodage GB2312 est répandu en Chine continentale ; Singapour et d'autres endroits utilisent également cet encodage. Presque tous les systèmes chinois et logiciels internationalisés en Chine continentale prennent en charge GB2312. L'apparition de GB2312 a fondamentalement répondu aux besoins du traitement informatique des caractères chinois, et les caractères chinois qu'il inclut couvrent 99.75% de la fréquence d'utilisation en Chine continentale. Pour les caractères rares apparaissant dans les noms de personnes, le chinois ancien, etc., GB2312 ne peut pas les traiter, ce qui a conduit à l'apparition ultérieure des jeux de caractères chinois GBK et GB 18030. La figure suivante montre le début de l'encodage GB2312 (comme il est très volumineux, seule la partie initiale est répertoriée ; pour plus de détails, consultez la table d'encodage du chinois simplifié GB2312) :
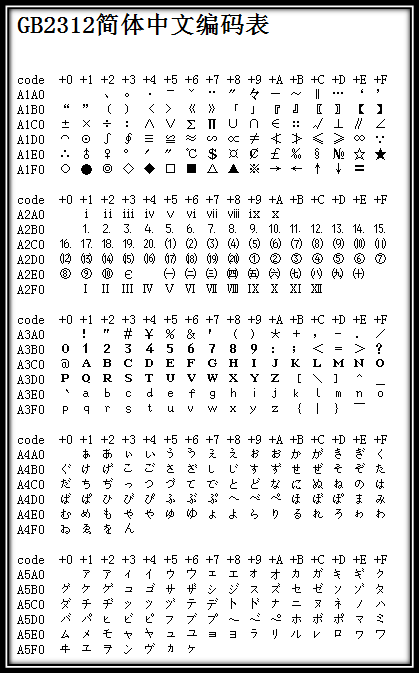
Figure 3 Début de la table d'encodage GB2312
Étant donné que GB 2312-80 ne comprend que 6,763 caractères chinois, de nombreux caractères chinois n'étaient pas inclus, tels que certains caractères simplifiés après l'introduction de GB 2312-80 (par exemple, « 啰 »), certains caractères utilisés dans les noms de personnes (par exemple, « 镕 » de l'ancien Premier ministre chinois Zhu Rongji), les caractères chinois traditionnels utilisés à Taïwan et à Hong Kong, et les caractères chinois utilisés en japonais et en coréen, etc. Par conséquent, Microsoft a tiré parti de l'espace d'encodage inutilisé de GB 2312-80 et a inclus tous les caractères de GB 13000.1-93 pour développer l'encodage GBK. Selon la documentation Microsoft, GBK est une extension de GB2312-80, c'est-à-dire une extension de la page de code CP936 (auparavant, CP936 était exactement identique à GB 2312-80), mise en œuvre pour la première fois dans la version en chinois simplifié de Windows 95. Bien que GBK inclue tous les caractères de GB 13000.1-93, la méthode d'encodage est différente. GBK lui-même n'est pas une norme nationale ; il n'a été publié que comme « document d'orientation de spécification technique » par le Département de la normalisation de l'ancien Bureau national de la supervision technique et le Département de la science, de la technologie et de la supervision de la qualité du ministère de l'Industrie électronique. Le GB13000 original n'a jamais été adopté par l'industrie, et la norme nationale ultérieure GB18030 est techniquement compatible avec GBK plutôt qu'avec GB13000.
GB 18030, nom complet : norme nationale GB 18030-2005 « Technologies de l'information — Jeu de caractères codés chinois », est le jeu de caractères à codage interne le plus récent actuel de la République populaire de Chine. Il s'agit d'une révision de GB 18030-2000 « Technologies de l'information — Code des jeux de caractères graphiques chinois pour l'échange d'informations — Extension du jeu de base ». Il est entièrement compatible avec GB 2312-1980, essentiellement compatible avec GBK, prend en charge tous les caractères chinois unifiés de GB 13000 et Unicode, et contient au total 70,244 caractères chinois. GB 18030 présente principalement les caractéristiques suivantes :
- Comme UTF-8, il utilise un encodage multi-octets, et chaque caractère peut être constitué de 1, 2 ou 4 octets.
- L'espace d'encodage est énorme, capable de définir jusqu'à 1.61 million de caractères.
- Il prend en charge les écritures des minorités ethniques en Chine, sans avoir besoin d'utiliser la zone d'usage privé.
- La portée des caractères chinois collectés comprend les caractères chinois traditionnels ainsi que les caractères chinois japonais et coréens (caractères Han).
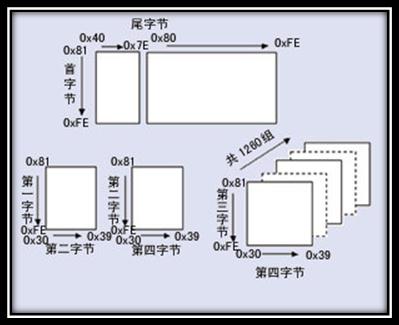
Figure 4 Structure globale du codage GB18030
La première version de cette spécification a été rédigée par l'Institut de normalisation de l'industrie électronique du ministère de l'Industrie de l'information de la République populaire de Chine, et publiée par le Bureau national de supervision de la qualité et de la technique le 17 mars 2000. La version actuelle a été publiée par l'Administration générale de la supervision de la qualité, de l'inspection et de la quarantaine et l'Administration de la normalisation de Chine le 8 novembre 2005, et mise en œuvre le 1er mai 2006. Cette spécification est obligatoire pour tous les produits logiciels en Chine.
2.3. Jeu de caractères & encodage BIG5
. Unicode est en constante expansion ; chaque nouvelle version insère davantage de nouveaux caractères. Jusqu'à la version actuelle, la sixième, Unicode contient déjà plus de 100,000 caractères (en 2005, le 100,000e caractère d'Unicode a été adopté et reconnu comme l'un des standards), un ensemble de tables de codes utilisables comme références visuelles, un ensemble de méthodes d'encodage et un encodage de caractères standard, ainsi qu'une énumération contenant des propriétés de caractères telles que les exposants et les indices, etc. Le Consortium Unicode est géré par une organisation à but non lucratif et dirige le développement futur d'Unicode. Son objectif est de remplacer les schémas d'encodage de caractères existants par les schémas d'encodage Unicode, en particulier parce que les schémas existants n'ont qu'un espace limité et des problèmes d'incompatibilité dans les environnements multilingues.
Big5 est un jeu de caractères à double octet qui utilise une méthode de stockage à deux octets de huit bits, plaçant un caractère sur deux octets. Le premier octet est appelé « octet de poids fort », et le second octet est appelé « octet de poids faible ». L’octet de poids fort utilise 0x81-0xFE, et l’octet de poids faible utilise 0x40-0x7E et 0xA1-0xFE. Dans les partitions Big5 :
| 0x8140-0xA0FE | Réservé aux caractères définis par l’utilisateur (zone de création de caractères). |
| 0xA140-0xA3BF |
Ponctuation, lettres grecques et symboles spéciaux, y compris 0xA259-0xA261, qui contiennent neuf caractères chinois de mesure : 兙兛兞兝兡兣嗧瓩糎. |
| 0xA3C0-0xA3FE | Réservé. Cette zone n’est pas ouverte aux caractères définis par l’utilisateur. |
| 0xA440-0xC67E | Caractères chinois courants, triés d’abord par nombre de traits, puis par radical. |
| 0xC6A1-0xC8FE | Réservé aux caractères définis par l’utilisateur (zone de création de caractères). |
| 0xC940-0xF9D5 | Caractères chinois moins courants, également triés d’abord par nombre de traits, puis par radical. |
| 0xF9D6-0xFEFE | Réservé aux caractères définis par l’utilisateur (zone de création de caractères). |
3. Jeu de caractères Unicode & encodage UTF
La grande idée Unicode— Unicode mérite sa propre discussion séparée
Comme l’Empire céleste, lorsque les ordinateurs se sont répandus dans divers pays du monde, afin de s’adapter aux langues et caractères locaux, des schémas d’encodage similaires à GB232/GBK/GB18030/BIG5 ont été conçus et mis en œuvre. Ainsi, chaque région a son propre système ; localement cela fonctionne bien, mais une fois en réseau, en raison de l’incompatibilité, des caractères illisibles apparaissent lors de l’accès aux données des autres.
Pour résoudre ce problème, une grande idée est née — Unicode. Le système d’encodage Unicode est conçu pour représenter n’importe quel caractère de n’importe quelle langue. Il utilise des nombres de 4 octets pour représenter chaque lettre, symbole ou idéogramme. Chaque nombre représente un symbole unique utilisé dans au moins une langue. (Tous les nombres ne sont pas utilisés, mais le total dépasse déjà 65,535, donc des nombres de deux octets ne suffisent pas.) Les caractères partagés par plusieurs langues sont généralement encodés avec le même nombre, sauf s’il existe une raison étymologique raisonnable de ne pas le faire. En dehors de ces cas, chaque caractère correspond à un nombre, et chaque nombre correspond à un caractère. Il n’y a aucune ambiguïté. Pas besoin d’enregistrer « mode ». U+0041 représente toujours 'A', même si la langue ne possède pas le caractère 'A'.
Dans le domaine de l’informatique, Unicode (code unifié, code universel, code unique, code universel standard) est une norme industrielle qui permet aux ordinateurs de représenter des systèmes de dizaines d’écritures du monde entier. Unicode est développé sur la base de la norme Universal Character Set et est également publié sous forme de livre
(On peut le comprendre ainsi : Unicode est le jeu de caractères ; UTF-32/UTF-16/UTF-8 sont trois schémas d’encodage de caractères.)
3.1.UCS & UNICODE
Universal Character Set(Universal Character Set,UCS) est défini par l’ISOISO 10646(ouISO/IEC 10646) jeu de caractères standard défini par la norme.
Vers 1991, les participants des deux projets ont réalisé que le monde n'avait pas besoin de deux jeux de caractères incompatibles. Ils ont donc commencé à fusionner les résultats de leurs travaux et à collaborer pour créer une table d'encodage unique. À partir d'Unicode 2.0, Unicode a adopté le même répertoire de caractères et les mêmes points de code qu'ISO 10646-1 ; l'ISO a également promis qu'ISO 10646 n'attribuerait pas de valeurs pour l'encodage UCS-4 au-delà de U+10FFFF, afin de maintenir la cohérence entre les deux. Les deux projets existent toujours et publient indépendamment leurs propres normes. Mais le Consortium Unicode et l'ISO/IEC JTC1/SC2 ont convenu de maintenir la compatibilité des tables de codes des deux normes et de coordonner étroitement toute extension future. Lors de la publication, Unicode adopte généralement les glyphes les plus courants pour les points de code concernés, tandis qu'ISO 10646 adopte généralement la police Century autant que possible.
3.2.UTF-32
Le schéma d'encodage décrit ci-dessus, qui utilise des nombres de 4 octets pour représenter chaque lettre, symbole ou idéogramme, où chaque nombre représente un symbole unique utilisé dans au moins une langue, est appelé UTF-32. UTF-32 est également connu sous le nom deUCS-4un protocole d'encodage des caractères Unicode qui utilise 4 octets pour chaque caractère. En termes d'espace, il est très inefficace.
Cette méthode a ses avantages ; le plus important est que le Nième caractère d'une chaîne peut être localisé en temps constant, car le Nième caractère commence au 4×Nième octet. Bien qu'il puisse sembler pratique d'utiliser des octets de longueur fixe pour chaque point de code, elle n'est pas aussi largement utilisée que les autres encodages Unicode.
3.3.UTF-16
Bien qu'il existe de nombreux caractères Unicode, en réalité la plupart des gens n'utilisent pas de caractères au-delà des 65,535 premiers. Par conséquent, une autre méthode d'encodage Unicode a été créée, appelée UTF-16 (parce que 16 bits = 2 octets). UTF-16 encode les caractères compris entre 0–65,535 sur 2 octets. Si vous devez vraiment représenter ces caractères Unicode rarement utilisés dans le « plan astral » au-delà de la plage 65,535, certaines techniques délicates sont nécessaires. L'avantage le plus évident de l'encodage UTF-16 est qu'il est deux fois plus économe en espace que UTF-32, car chaque caractère n'a besoin que de 2 octets pour être stocké (sauf au-delà de la plage 65,535) plutôt que de 4 octets en UTF-32. De plus, si nous supposons qu'une chaîne ne contient aucun caractère du plan astral, nous pouvons toujours trouver le N-ième caractère en temps constant ; tant que cette hypothèse tient, c'est toujours une bonne inférence. Sa méthode d'encodage est :
- Si le code de caractère U est inférieur à 0x10000, c'est-à-dire compris entre 0 et 65,535 en décimal, il est directement représenté par deux octets ;
- Si le code de caractère U est supérieur à 0x10000, étant donné que la plage d'encodage Unicode maximale est 0x10FFFF, il y a 0xFFFFF codes entre 0x10000 et 0x10FFFF, ce qui signifie que seulement 20 bits sont nécessaires pour représenter ces codes. Soit U' la valeur comprise entre 0 et 0xFFFFF. Prenez les 10 premiers bits comme bits de poids fort et effectuez un OU logique avec la valeur 16 bits 0xD800 ; prenez les 10 derniers bits comme bits de poids faible et effectuez un OU logique avec 0xDC00. Les 4 octets résultants constituent l'encodage de U.
Il existe d'autres inconvénients moins évidents des méthodes d'encodage UTF-32 et UTF-16. Différents systèmes informatiques stockent les octets dans des ordres différents. Cela signifie que le caractère U+4E2D en encodage UTF-16 peut être stocké sous la forme 4E 2D ou 2D 4E, selon que le système utilise le gros-boutiste ou le petit-boutiste.(Pour l'encodage UTF-32, il y a encore plus d'arrangements d'octets possibles.)Tant que le document ne quitte pas votre ordinateur, il est toujours sûr—différents programmes sur le même ordinateur utilisent le même ordre d'octets. Mais lorsque nous devons transférer ce document entre systèmes, peut-être sur le World Wide Web, nous avons besoin d'une méthode pour indiquer comment nos octets sont actuellement stockés. Sinon, l'ordinateur qui reçoit le document ne peut pas savoir si les deux octets 4E 2D représentent U+4E2D ou U+2D4E.
Pour résoudre ce problème, les méthodes d'encodage Unicode multioctets définissent une « marque d'ordre des octets », qui est un caractère spécial non imprimable que vous pouvez inclure au début d'un document pour indiquer l'ordre des octets que vous utilisez. Pour UTF-16, la marque d'ordre des octets est U+FEFF. Si vous recevez un document encodé en UTF-16 qui commence par les octets FF FE, vous pouvez déterminer que son ordre d'octets est dans un sens ; s'il commence par FE FF, vous pouvez déterminer que l'ordre des octets est inversé.
3.4.UTF-8
UTF-8 (8-bit Unicode Transformation Format) est un encodage de caractères à longueur variable (code à longueur variable) pour Unicode, et c'est aussi un code préfixe. Il peut être utilisé pour représenter n'importe quel caractère de la norme Unicode, et le premier octet de son encodage est toujours compatible avec ASCII, ce qui permet aux logiciels qui géraient à l'origine des caractères ASCII de continuer à être utilisés sans modification ou avec seulement des modifications mineures. Par conséquent, il est progressivement devenu l'encodage préféré dans le courrier électronique, les pages web et d'autres applications qui stockent ou transmettent du texte. L'Internet Engineering Task Force (IETF) exige que tous les protocoles Internet prennent en charge l'encodage UTF-8.
UTF-8 utilise de un à quatre octets pour encoder chaque caractère :
- 128 caractères US-ASCII n'ont besoin que d'un seul octet pour être encodés (plage Unicode de U+0000 à U+007F).
- 2. Les lettres latines avec signes diacritiques, grecques, cyrilliques, arméniennes, hébraïques, arabes, syriaques et thaana nécessitent un encodage sur deux octets (plage Unicode U+0080 à U+07FF).
- Les autres caractères du plan multilingue de base (BMP) (qui inclut la plupart des caractères couramment utilisés) utilisent un encodage à trois octets.
- Les caractères des autres plans supplémentaires Unicode rarement utilisés utilisent un encodage à quatre octets.
Il est très efficace pour traiter les caractères ASCII fréquemment utilisés. Pour le traitement des jeux de caractères latins étendus, il n'est pas non plus inférieur à UTF-16. Pour les caractères chinois, il est meilleur qu'UTF-32. En même temps, (vous devrez me faire confiance sur ce point, car je n'ai pas l'intention de vous montrer les mathématiques derrière cela.) En raison de la nature des opérations sur les bits, UTF-8 n'a plus le problème d'ordre des octets. Un document encodé en UTF-8 est le même flux binaire d'un ordinateur à l'autre.
En général, dans une chaîne Unicode, il est impossible de déterminer la longueur nécessaire pour l'afficher à partir du nombre de points de code, ni la position où le curseur doit être placé dans le tampon de texte après l'affichage de la chaîne ; les caractères combinants, les polices à largeur variable, les caractères non imprimables et le texte de droite à gauche sont tous des facteurs contributifs. Ainsi, bien que la relation entre le nombre de caractères et le nombre de points de code dans les chaînes UTF-8 soit plus complexe que dans UTF-32, en pratique, les cas où cela fait une différence sont rares.
Avantages
- UTF-8 est un sur-ensemble d'ASCII. Comme une chaîne ASCII pure est aussi une chaîne UTF-8 valide, le texte ASCII existant n'a pas besoin d'être converti. Les logiciels conçus pour les jeux de caractères ASCII étendus traditionnels peuvent généralement fonctionner avec UTF-8 sans modification ou avec très peu de modifications.
- Le tri d'UTF-8 à l'aide de routines de tri standard orientées octets donne les mêmes résultats qu'un tri basé sur les points de code Unicode. (Bien que cela n'ait qu'une utilité limitée, car il est peu probable qu'il existe un ordre de caractères encore acceptable dans une langue ou une culture donnée.)
- UTF-8 et UTF-16 sont tous deux des encodages standard pour les documents Extensible Markup Language (XML). Tous les autres encodages doivent être spécifiés au moyen d'une déclaration explicite ou textuelle.
- Tout algorithme de recherche de chaîne orienté octets peut être utilisé sur des données UTF-8 (tant que l'entrée ne contient que des caractères UTF-8 complets). Cependant, il faut être prudent avec les expressions régulières ou d'autres constructions qui contiennent un comptage de caractères.
- Les chaînes UTF-8 peuvent être identifiées de manière fiable par un algorithme simple. Autrement dit, la probabilité qu'une chaîne dans un autre encodage apparaisse comme UTF-8 valide est très faible, et elle diminue à mesure que la longueur de la chaîne augmente. Par exemple, les valeurs de caractères C0, C1, F5 à FF n'apparaissent jamais. Pour une meilleure fiabilité, des expressions régulières peuvent être utilisées pour détecter les valeurs illégales trop longues et de substitution (voirW3 FAQ : Formulaires multilinguesl'expression régulière pour valider les chaînes UTF-8 sur).
Inconvénients
Parce que chaque caractère est encodé à l'aide d'un nombre d'octets différent, trouver le Nième caractère dans une chaîne est une opération de complexité O(N) — c'est-à-dire que plus la chaîne est longue, plus il faut de temps pour localiser un caractère particulier. En même temps, une manipulation de bits est également nécessaire pour encoder les caractères en octets et décoder les octets en caractères.
4.Accept-Charset/Accept-Encoding/Accept-Language/Content-Type/Content-Encoding/Content-Language
En HTTP, les en-têtes de message liés au jeu de caractères et à l'encodage des caractères sont Accept-Charset/Content-Type ; en outre, la principale distinction entre Accept-Charset/Accept-Encoding/Accept-Language/Content-Type/Content-Encoding/Content-Language est :
Accept-Charset : Le navigateur déclare le jeu de caractères qu'il accepte. Il s'agit des différents jeux de caractères et encodages de caractères introduits plus haut dans cet article, tels que gb2312, utf-8 (généralement, lorsque nous disons Charset, cela inclut le schéma d'encodage de caractères correspondant) ;
Accept-Encoding : Le navigateur déclare les méthodes d'encodage qu'il accepte, en spécifiant généralement les méthodes de compression, si la compression est prise en charge et quelles méthodes de compression sont prises en charge (gzip, deflate). (Remarque : il ne s'agit pas seulement de l'encodage des caractères) ;
Accept-Language: Le navigateur déclare la langue qu'il accepte. La différence entre langue et jeu de caractères : le chinois est une langue, et le chinois possède plusieurs jeux de caractères, tels que big5, gb2312, gbk, etc. ;
Content-Type: Le serveur Web indique au navigateur le type et le jeu de caractères de l'objet dans sa réponse. Par exemple : Content-Type: text/html; charset='gb2312'
Content-Encoding: Le serveur Web indique quelle méthode de compression (gzip, deflate) il a utilisée pour compresser l'objet dans la réponse. Par exemple : Content-Encoding: gzip
Content-Language: Le serveur Web indique au navigateur la langue de l'objet dans sa réponse.
5. Références et lectures complémentaires
- Baidu Baike. Jeu de caractères.http://baike.baidu.com/view/51987.htm, 2010-12-28
- Wikipédia. Codage des caractères.http://zh.wikipedia.org/wiki/%E5%AD%97%E7%AC%A6%E7%BC%96%E7%A0%81, 2011-1-5
- Wikipédia. ASCII.http://zh.wikipedia.org/wiki/ASCII, 2011-4-5
- Wikipédia. GB2312.http://zh.wikipedia.org/wiki/GB_2312, 2011-3-17
- Wikipédia. GB18030.http://zh.wikipedia.org/wiki/GB_18030, 2010-3-10
- Wikipédia. GBK.http://zh.wikipedia.org/wiki/GBK, 2011-3-7
- Wikipédia. Unicode.http://zh.wikipedia.org/wiki/Unicode, 2011-4-30
- Laruence. Explication détaillée du codage des caractères (bases).http://www.laruence.com/2009/08/22/1059.html, 2009-8-22
- Jan Hunt. Jeux de caractères et encodage pour les concepteurs web - UCS/UNICODE. http://www.uninetnews.com/other_standards/charset.php
Auteur : Wu Qin
Source : http://www.cnblogs.com/skynet/archive/2011/05/03/2035105.html