Набор символов и кодирование символов — знания, которые каждый разработчик программного обеспечения должен обязательно освоить!
Я думаю, каждый сталкивался с ситуацией, когда открываешь веб-страницу и видишь кучу кракозябр? Помните поля заголовков сообщений в HTTP, такие как Accept-Charset, Accept-Encoding, Accept-Language, Content-Encoding, Content-Language? Именно о них мы поговорим далее.
Содержание:
- 1. Базовые знания
- 2. Распространённые наборы символов и кодировки символов
- 2.1. Набор символов и кодировка ASCII
- 2.2. Набор символов и кодировка GBXXXX
- 2.3. Набор символов и кодировка BIG5
- 3. Набор символов Unicode и кодировка UTF
- 3.1. UCS и UNICODE
- 3.2. UTF-32
- 3.3. UTF-16
- 3.4. UTF-8
- 4.Accept-Charset/Accept-Encoding/Accept-Language/Content-Type/Content-Encoding/Content-Language
- 5. Ссылки и дополнительная литература
1. Базовые знания
Информация, хранящаяся в компьютере, представляется двоичными числами; английские символы, китайские иероглифы и другие символы, которые мы видим на экране, являются результатом преобразования двоичных чисел. Проще говоря, правила, по которым символы хранятся в компьютере, например, чем представлен символ 'a', называются «кодированием»; наоборот, разбор и отображение двоичных чисел, хранящихся в компьютере, называются «декодированием», подобно шифрованию и дешифрованию в криптографии. При декодировании, если используются неправильные правила декодирования, 'a' может быть разобран как 'b' или как искажённый текст.
Набор символов (Charset): это совокупность всех абстрактных символов, поддерживаемых системой. Символы — это общее название различных текстов и знаков, включая национальные письменности, знаки препинания, графические символы, цифры и т. д.
Кодировка символов: это набор правил, который позволяет сопоставить набор символов из естественного языка (например, алфавита или слогового письма) с другим набором (например, числами или электрическими импульсами). То есть она устанавливает соответствие между набором символов и системой счисления, и это фундаментальная технология в обработке информации. Люди обычно используют наборы символов (как правило, текст) для выражения информации. Компьютерные системы обработки информации используют комбинации различных состояний компонентов (аппаратного обеспечения) для хранения и обработки информации. Комбинации различных состояний компонентов могут представлять числа в системе счисления. Следовательно, кодировка символов — это преобразование символов в числа в системе счисления, которую компьютер может воспринять; эти числа называются цифровыми кодами.
2. Распространённые наборы символов и кодировки символов
Распространённые названия наборов символов: набор символов ASCII, набор символов GB2312, набор символов BIG5, набор символов GB18030, набор символов Unicode и т. д. Чтобы точно обрабатывать текст в различных наборах символов, компьютерам необходимо выполнять кодирование символов, чтобы компьютер мог распознавать и хранить различные тексты.
2.1. Набор символов и кодировка ASCII
ASCII (American Standard Code for Information Interchange) — это компьютерная система кодирования, основанная на латинском алфавите. Она в основном используется для отображения современного английского языка, а её расширенная версия EASCII едва может отображать другие западноевропейские языки. В настоящее время это наиболее распространённая система однобайтового кодирования (но есть признаки того, что её догоняет Unicode), и она эквивалентна международному стандарту ISO/IEC 646.
Набор символов ASCII: в основном включает управляющие символы (возврат каретки, возврат на один символ, перевод строки и т. д.); отображаемые символы (английские прописные и строчные буквы, арабские цифры и западные символы).
Кодирование ASCII: правила преобразования набора символов ASCII в числа в числовой системе, которую может принимать компьютер. Оно использует 7 бит для представления одного символа, всего 128 символов; однако 7-битный кодированный набор символов может поддерживать только 128 символов. Чтобы представить более часто используемые европейские символы, ASCII был расширен. Расширенный набор символов ASCII использует 8 бит для представления одного символа, всего 256 символов. Правила сопоставления набора символов ASCII с числовыми кодами показаны на следующем рисунке:
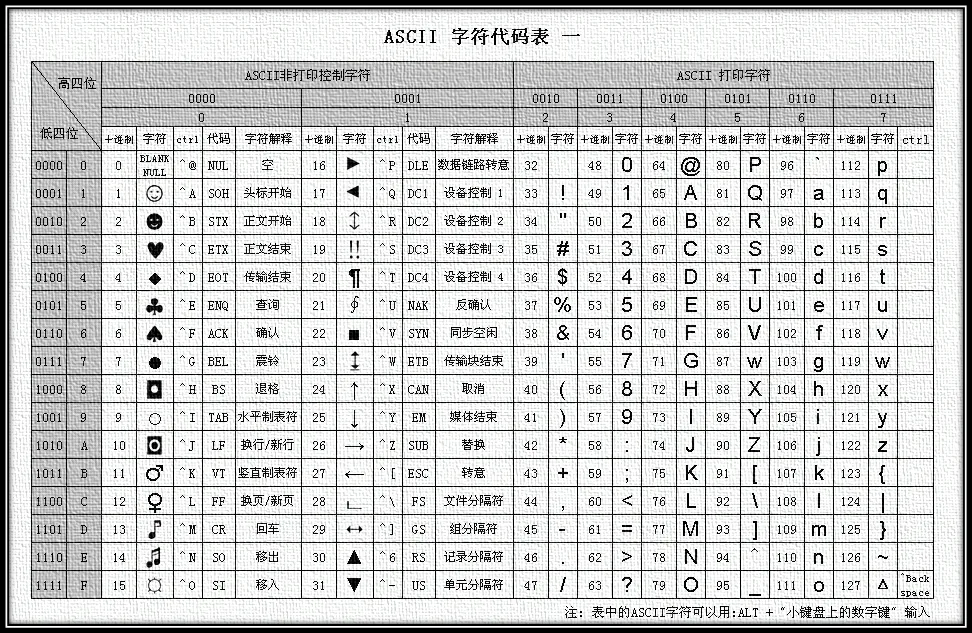
Рисунок 1. Таблица кодировки ASCII
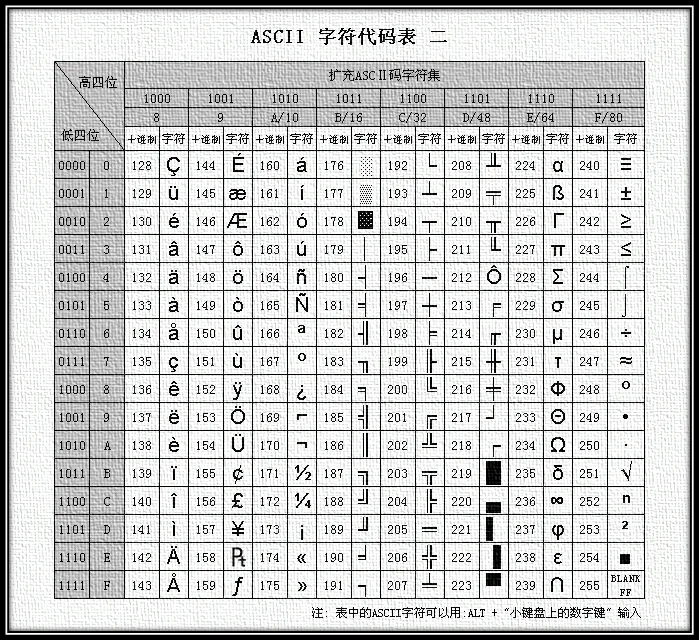
Рисунок 2. Таблица кодирования расширенного ASCII
ASCII's biggest drawback is that it can only display 26 basic Latin letters, Arabic numerals, and British punctuation marks, so it can only be used to display modern American English (and when dealing with loanwords in English such as naïve, café, élite, etc., all accent marks have to be removed, even if doing so violates spelling rules). EASCII, although it solves the display problem for some Western European languages, is still helpless for many other languages. Therefore, Apple computers have now abandoned ASCII and switched to Unicode.
2.2. Набор символов и кодировка GBXXXX
At the time of the invention of the computer and for a long time afterward, it was only used in the United States and some developed Western countries, and ASCII satisfied users' needs well. But when China also got computers, in order to display Chinese, it was necessary to design a set of encoding rules to convert Chinese characters into numbers in a numerical system that computers can accept.
Chinese experts removed the strange symbols after 127 (i.e., EASCII) and stipulated: a character less than 127 has the same meaning as before, but when two characters greater than 127 are joined together, they represent a Chinese character. The first byte (called the high byte) ranges from 0xA1 to 0xF7, and the second byte (low byte) ranges from 0xA1 to 0xFE. In this way, we can combine about 7,000+ simplified Chinese characters. In these encodings, mathematical symbols, Roman and Greek letters, and Japanese kana were also included, and even the numbers, punctuation, and letters that already existed in ASCII were all re-encoded with two-byte lengths. These are commonly called "full-width" characters, while those originally below 127 are called "half-width" characters.
Приведённые выше правила кодирования — это GB2312. GB2312 или GB2312-80 — это национальный стандарт Китая для набора упрощённых китайских иероглифов, полное название «Код набора китайских графических символов для обмена информацией · Базовый набор», также известный как GB0, выпущенный Национальным бюро стандартов Китая и введённый в действие 1 мая 1981 г. Кодировка GB2312 распространена в материковом Китае; Сингапур и другие регионы также используют эту кодировку. Почти все китайские системы и интернационализированное программное обеспечение в материковом Китае поддерживают GB2312. Появление GB2312 в основном удовлетворило потребности компьютерной обработки китайских иероглифов, а включённые в него китайские иероглифы покрывают 99.75% частоты использования в материковом Китае. Для редких иероглифов, встречающихся в личных именах, древнекитайских текстах и т. п., GB2312 не может их обработать, что впоследствии привело к появлению наборов китайских иероглифов GBK и GB 18030. На следующем рисунке показана начальная часть кодировки GB2312 (поскольку она очень большая, приведена только начальная часть; подробнее см. таблицу кодирования упрощённых китайских иероглифов GB2312):
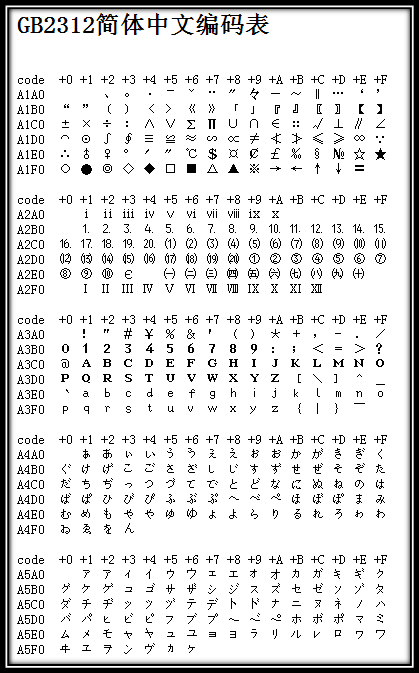
Рисунок 3. Начальная часть таблицы кодирования GB2312
Поскольку GB 2312-80 содержит только 6,763 китайских иероглифа, многие китайские иероглифы не были включены, например некоторые иероглифы, упрощённые после введения GB 2312-80 (например, «啰»), некоторые иероглифы, используемые в личных именах (например, «镕» бывшего премьера КНР Чжу Жунцзи), традиционные китайские иероглифы, используемые на Тайване и в Гонконге, а также китайские иероглифы, используемые в японском и корейском языках, и т. д. Поэтому Microsoft воспользовалась неиспользуемым кодовым пространством в GB 2312-80 и включила все символы GB 13000.1-93, чтобы разработать кодировку GBK. Согласно документации Microsoft, GBK является расширением GB2312-80, то есть расширением кодовой страницы CP936 (ранее CP936 полностью совпадала с GB 2312-80), впервые реализованным в версии Windows 95 для упрощённого китайского языка. Хотя GBK включает все символы GB 13000.1-93, способ кодирования отличается. Сам GBK не является национальным стандартом; он был опубликован лишь как «руководящий документ по техническим спецификациям» Департаментом стандартизации бывшего Государственного бюро технического надзора и Департаментом науки, техники и надзора за качеством Министерства электронной промышленности. Исходный GB13000 так и не был принят отраслью, а последующий национальный стандарт GB18030 технически совместим с GBK, а не с GB13000.
GB 18030, полное название: Национальный стандарт GB 18030-2005 «Информационные технологии — Кодированный набор китайских иероглифов», — это текущий новейший внутренний кодированный набор символов Китайской Народной Республики. Он является пересмотром GB 18030-2000 «Информационные технологии — Код набора китайских графических символов для обмена информацией — Расширение базового набора». Он полностью совместим с GB 2312-1980, в основном совместим с GBK, поддерживает все унифицированные китайские иероглифы в GB 13000 и Unicode и содержит в общей сложности 70,244 китайских иероглифа. GB 18030 в основном имеет следующие характеристики:
- Как и UTF-8, он использует многобайтовую кодировку, и каждый символ может состоять из 1, 2 или 4 байтов.
- Пространство кодирования огромно и позволяет определить до 1.61 миллиона символов.
- Он поддерживает письменности этнических меньшинств Китая без необходимости использовать область частного использования.
- Охват собранных китайских иероглифов включает традиционные китайские иероглифы, а также японские и корейские иероглифы (ханьские иероглифы).
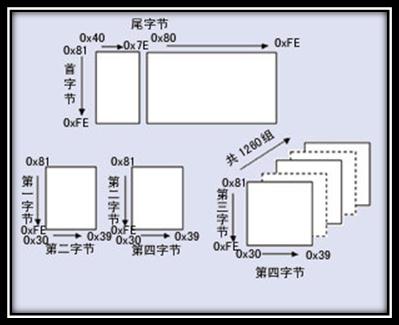
Рисунок 4. Общая структура кодировки GB18030
Первая версия этой спецификации была разработана Институтом стандартизации электронной промышленности Министерства информационной промышленности Китайской Народной Республики и выпущена Государственным бюро по надзору за качеством и техническому надзору 17 марта 2000 года. Текущая версия была выпущена Главным управлением по надзору за качеством, инспекции и карантину и Администрацией по стандартизации Китая 8 ноября 2005 года и введена в действие 1 мая 2006 года. Данная спецификация обязательна для всех программных продуктов на территории Китая.
2.3. Набор символов и кодировка BIG5
. Unicode постоянно расширяется; каждая новая версия добавляет всё больше новых символов. По состоянию на текущую шестую версию Unicode уже содержит более 100,000 символов (в 2005 году 100,000-й символ Unicode был принят и признан одним из стандартов), набор кодовых таблиц, которые можно использовать в качестве визуальных справочников, набор методов кодирования и стандартную кодировку символов, а также перечисление, содержащее свойства символов, такие как верхние и нижние индексы, и т. д. Консорциум Unicode управляется некоммерческой организацией и руководит дальнейшим развитием Unicode. Его цель — заменить существующие схемы кодирования символов схемами кодирования Unicode, особенно потому, что существующие схемы имеют лишь ограниченное пространство и проблемы несовместимости в многоязычных средах.
Big5 — это двухбайтовый набор символов, использующий метод хранения с двумя восьмибитными байтами, при котором один символ занимает два байта. Первый байт называется «старшим байтом», а второй — «младшим байтом». «Старший байт» использует 0x81-0xFE, а «младший байт» использует 0x40-0x7E и 0xA1-0xFE. В разделах Big5:
| 0x8140-0xA0FE | Зарезервировано для пользовательских символов (зона создания символов). |
| 0xA140-0xA3BF |
Пунктуация, греческие буквы и специальные символы, включая 0xA259-0xA261, которые содержат девять китайских иероглифов единиц измерения: 兙兛兞兝兡兣嗧瓩糎. |
| 0xA3C0-0xA3FE | Зарезервировано. Эта зона не открыта для пользовательских символов. |
| 0xA440-0xC67E | Часто используемые китайские иероглифы, отсортированные сначала по числу черт, затем по радикалу. |
| 0xC6A1-0xC8FE | Зарезервировано для пользовательских символов (зона создания символов). |
| 0xC940-0xF9D5 | Менее распространённые китайские иероглифы, также отсортированные сначала по числу черт, затем по радикалу. |
| 0xF9D6-0xFEFE | Зарезервировано для пользовательских символов (зона создания символов). |
3. Набор символов Unicode и кодировка UTF
Великая идея Unicode— Unicode заслуживает отдельного обсуждения
Подобно Небесной империи, когда компьютеры распространились по разным странам мира, чтобы приспособиться к местным языкам и символам, были разработаны и внедрены схемы кодирования, подобные GB232/GBK/GB18030/BIG5. Так у каждого региона появилась своя система; локально она работает нормально, но как только дело доходит до сети, из-за несовместимости при доступе к данным друг друга появляются искажённые символы.
Чтобы решить эту проблему, родилась великая идея — Unicode. Система кодирования Unicode предназначена для представления любого символа любого языка. Она использует 4-байтовые числа для представления каждой буквы, символа или идеограммы. Каждое число представляет уникальный символ, используемый как минимум в одном языке. (Не все числа используются, но их общее количество уже превышает 65,535, поэтому двухбайтовых чисел недостаточно.) Символы, общие для нескольких языков, обычно кодируются одним и тем же числом, если только нет разумной этимологической причины этого не делать. Помимо таких случаев, каждый символ соответствует числу, и каждое число соответствует символу. Никакой неоднозначности. Не нужно записывать «режим». U+0041 всегда обозначает 'A', даже если в языке нет символа 'A'.
В области компьютерных наук Unicode (统onecode, 万国code, 单onecode, Standard万国code) — это промышленный стандарт, позволяющий компьютерам представлять системы десятков письменностей со всего мира. Unicode разработан на основе стандарта Universal Character Set и также публикуется в виде книги
(Это можно понять так: Unicode — это набор символов; UTF-32/UTF-16/UTF-8 — три схемы кодирования символов.)
3.1. UCS и UNICODE
Universal Character Set(Universal Character Set,UCS) сформулирован ISOISO 10646(илиISO/IEC 10646) — стандартный набор символов, определённый стандартом.
Примерно в 1991 году участники обоих проектов осознали, что миру не нужны два несовместимых набора символов. Поэтому они начали объединять результаты своей работы и сотрудничать для создания единой таблицы кодирования. Начиная с Unicode 2.0, Unicode принял тот же репертуар символов и кодовые точки, что и ISO 10646-1; ISO также пообещала, что ISO 10646 не будет присваивать значения для кодировки UCS-4 за пределами U+10FFFF, чтобы сохранить согласованность между ними. Оба проекта всё ещё существуют и независимо публикуют собственные стандарты. Но Консорциум Unicode и ISO/IEC JTC1/SC2 договорились поддерживать совместимость кодовых таблиц двух стандартов и тесно координировать любые будущие расширения. При публикации Unicode обычно использует наиболее распространённые глифы для соответствующих кодовых точек, тогда как ISO 10646 по возможности обычно использует гарнитуру Century.
3.2. UTF-32
Описанная выше схема кодирования, в которой для представления каждой буквы, символа или идеограммы используются 4-байтовые числа, причём каждое число представляет уникальный символ, используемый хотя бы в одном языке, называется UTF-32. UTF-32 также известна какUCS-4протокол кодирования символов Unicode, использующий 4 байта для каждого символа. С точки зрения занимаемого пространства он очень неэффективен.
У этого метода есть свои преимущества; самое важное — то, что N-й символ в строке можно определить за постоянное время, потому что N-й символ начинается с 4×N-го байта. Хотя использование байтов фиксированной длины для каждой кодовой точки может показаться удобным, этот метод не используется так широко, как другие кодировки Unicode.
3.3. UTF-16
Хотя существует множество символов Unicode, в действительности большинство людей не использует символы за пределами первых 65,535. Поэтому был создан ещё один метод кодирования Unicode, называемый UTF-16 (потому что 16 бит = 2 байта). UTF-16 кодирует символы в диапазоне 0–65,535 как 2 байта. Если вам действительно нужно представить те редко используемые символы Unicode в «астральной плоскости» за пределами диапазона 65,535, потребуются некоторые хитроумные приёмы. Самое очевидное преимущество кодировки UTF-16 состоит в том, что она в два раза экономичнее по пространству, чем UTF-32, поскольку для хранения каждого символа требуется всего 2 байта (кроме диапазона свыше 65,535), а не 4 байта в UTF-32. Кроме того, если предположить, что строка не содержит символов из астральной плоскости, мы всё ещё можем найти N-й символ за постоянное время; пока это предположение не нарушится, это всегда хороший вывод. Её метод кодирования таков:
- Если код символа U меньше 0x10000, то есть в десятичном диапазоне от 0 до 65,535, он напрямую представляется двумя байтами;
- Если код символа U больше 0x10000, поскольку максимальный диапазон кодирования Unicode — 0x10FFFF, между 0x10000 и 0x10FFFF находится 0xFFFFF кодов, то есть для представления этих кодов требуется всего 20 бит. Пусть U' обозначает значение от 0 до 0xFFFFF. Возьмите первые 10 бит в качестве старших битов и выполните логическое ИЛИ с 16-битным значением 0xD800; возьмите последние 10 бит в качестве младших битов и выполните логическое ИЛИ с 0xDC00. Полученные 4 байта составляют кодировку U.
У методов кодирования UTF-32 и UTF-16 есть и другие, менее очевидные недостатки. Разные компьютерные системы хранят байты в разном порядке. Это означает, что символ U+4E2D в кодировке UTF-16 может храниться как 4E 2D или 2D 4E, в зависимости от того, использует ли система big-endian или little-endian.(Для кодировки UTF-32 возможно ещё больше вариантов расположения байтов.)Пока документ не покидает ваш компьютер, это всё ещё безопасно — разные программы на одном компьютере используют один и тот же порядок байтов. Но когда нам нужно передать этот документ между системами, возможно, во Всемирной паутине, нам нужен способ указать, как в данный момент хранятся наши байты. Иначе компьютер, получающий документ, не сможет узнать, представляют ли два байта 4E 2D символ U+4E2D или U+2D4E.
Чтобы решить эту проблему, методы многобайтовой кодировки Unicode определяют «метку порядка байтов» (Byte Order Mark) — специальный непечатаемый символ, который можно включить в начало документа, чтобы указать используемый порядок байтов. Для UTF-16 метка порядка байтов — U+FEFF. Если вы получаете документ в кодировке UTF-16, начинающийся с байтов FF FE, вы можете определить, что его порядок байтов прямой; если он начинается с FE FF, вы можете определить, что порядок байтов обратный.
3.4. UTF-8
UTF-8 (8-битный формат преобразования Unicode) — это кодировка символов переменной длины (код переменной длины) для Unicode, а также префиксный код. Она может использоваться для представления любого символа стандарта Unicode, и первый байт её кодирования по-прежнему совместим с ASCII, что позволяет продолжать использовать программное обеспечение, изначально работавшее с символами ASCII, без изменений или лишь с незначительными изменениями. Поэтому она постепенно стала предпочтительной кодировкой в электронной почте, веб-страницах и других приложениях, которые хранят или передают текст. Internet Engineering Task Force (IETF) требует, чтобы все интернет-протоколы поддерживали кодировку UTF-8.
UTF-8 использует от одного до четырёх байтов для кодирования каждого символа:
- Для кодирования 128 символов US-ASCII требуется только один байт (диапазон Unicode от U+0000 до U+007F).
- 2. Латинские буквы с диакритическими знаками, а также буквы греческого, кириллического, армянского, еврейского, арабского, сирийского письма и письма тана требуют двухбайтового кодирования (диапазон Unicode от U+0080 до U+07FF).
- Остальные символы в Основной многоязычной плоскости (BMP) (которая включает большинство часто используемых символов) используют трёхбайтовую кодировку.
- Символы в других редко используемых дополнительных плоскостях Unicode используют четырёхбайтовую кодировку.
Он очень эффективен при обработке часто используемых символов ASCII. При обработке расширенных наборов латинских символов он также не уступает UTF-16. Для китайских иероглифов он лучше, чем UTF-32. В то же время (вам придётся поверить мне на слово, потому что я не собираюсь показывать вам математику, стоящую за этим.) Благодаря природе побитовых операций в UTF-8 больше нет проблемы порядка байтов. Документ, закодированный в UTF-8, представляет собой один и тот же битовый поток на разных компьютерах.
В целом в строке Unicode невозможно определить длину, необходимую для её отображения, по количеству кодовых точек или позицию, в которой следует разместить курсор в текстовом буфере после отображения строки; комбинирующиеся символы, шрифты переменной ширины, непечатаемые символы и текст, написанный справа налево, — всё это влияющие факторы. Поэтому, хотя соотношение между количеством символов и количеством кодовых точек в строках UTF-8 сложнее, чем в UTF-32, на практике редко встречаются случаи, когда это имеет значение.
Преимущества
- UTF-8 является надмножеством ASCII. Поскольку чистая строка ASCII также является допустимой строкой UTF-8, существующий текст ASCII не нуждается в преобразовании. Программное обеспечение, предназначенное для традиционных расширенных наборов символов ASCII, обычно может работать с UTF-8 без изменений или с очень небольшими изменениями.
- Сортировка UTF-8 с использованием стандартных байт-ориентированных процедур сортировки даёт те же результаты, что и сортировка на основе кодовых точек Unicode. (Хотя это лишь ограниченно полезно, потому что маловероятно, что в каком-либо конкретном языке или культуре существует по-прежнему приемлемый порядок символов.)
- И UTF-8, и UTF-16 являются стандартными кодировками для документов Extensible Markup Language (XML). Все другие кодировки должны быть указаны посредством явного или текстового объявления.
- Любой алгоритм поиска по строке, ориентированный на байты, можно применять к данным UTF-8 (при условии, что входные данные состоят только из полных символов UTF-8). Однако следует соблюдать осторожность с регулярными выражениями или другими конструкциями, которые включают подсчёт символов.
- Строки UTF-8 можно надёжно распознать с помощью простого алгоритма. То есть вероятность того, что строка в любой другой кодировке окажется допустимой UTF-8, очень мала, и она уменьшается с ростом длины строки. Например, значения символов C0, C1, F5–FF никогда не встречаются. Для большей надёжности можно использовать регулярные выражения для обнаружения недопустимых избыточно длинных и суррогатных значений (см.W3 FAQ: Многоязычные формырегулярное выражение для проверки строк UTF-8 на).
Недостатки
Поскольку каждый символ кодируется с использованием разного числа байтов, поиск N-го символа в строке — это операция сложности O(N), то есть чем длиннее строка, тем больше времени требуется для нахождения конкретного символа. В то же время для кодирования символов в байты и декодирования байтов в символы также требуется побитовая обработка.
4.Accept-Charset/Accept-Encoding/Accept-Language/Content-Type/Content-Encoding/Content-Language
В HTTP заголовки сообщения, связанные с набором символов и кодировкой символов, — это Accept-Charset/Content-Type; кроме того, основное различие между Accept-Charset/Accept-Encoding/Accept-Language/Content-Type/Content-Encoding/Content-Language состоит в следующем:
Accept-Charset: браузер сообщает, какой набор символов он принимает. Это различные наборы символов и кодировки символов, представленные ранее в этой статье, такие как gb2312, utf-8 (обычно, когда мы говорим Charset, подразумевается соответствующая схема кодирования символов);
Accept-Encoding: браузер сообщает, какие методы кодирования он принимает, обычно указывая методы сжатия, поддерживается ли сжатие и какие методы сжатия поддерживаются (gzip, deflate). (Примечание: это не только кодировка символов);
Accept-Language: Браузер сообщает, какой язык он принимает. Разница между языком и набором символов: китайский — это язык, и у китайского есть несколько наборов символов, таких как big5, gb2312, gbk и т. д.;
Content-Type: Веб-сервер сообщает браузеру тип и набор символов объекта в своём ответе. Например: Content-Type: text/html; charset='gb2312'
Content-Encoding: Веб-сервер указывает, какой метод сжатия (gzip, deflate) он использовал для сжатия объекта в ответе. Например: Content-Encoding: gzip
Content-Language: Веб-сервер сообщает браузеру язык объекта в своём ответе.
5. Ссылки и дополнительная литература
- Байду Байкэ. Набор символов.http://baike.baidu.com/view/51987.htm, 2010-12-28
- Википедия. Кодировка символов.http://zh.wikipedia.org/wiki/%E5%AD%97%E7%AC%A6%E7%BC%96%E7%A0%81, 2011-1-5
- Википедия. ASCII.http://zh.wikipedia.org/wiki/ASCII, 2011-4-5
- Википедия. GB2312.http://zh.wikipedia.org/wiki/GB_2312, 2011-3-17
- Википедия. GB18030.http://zh.wikipedia.org/wiki/GB_18030, 2010-3-10
- Википедия. GBK.http://zh.wikipedia.org/wiki/GBK, 2011-3-7
- Википедия. Unicode.http://zh.wikipedia.org/wiki/Unicode, 2011-4-30
- Laruence. Подробное объяснение кодировки символов (основы).http://www.laruence.com/2009/08/22/1059.html, 2009-8-22
- Jan Hunt. Наборы символов и кодировка для веб-дизайнеров - UCS/UNICODE. http://www.uninetnews.com/other_standards/charset.php
Автор: Wu Qin
Источник: http://www.cnblogs.com/skynet/archive/2011/05/03/2035105.html