Conjuntos de caracteres y codificación de caracteres: ¡conocimientos que todo desarrollador de software debería dominar sin condiciones!
Estoy seguro de que todos se han encontrado con alguna página web que se muestra como un montón de caracteres ilegibles. ¿Recuerdan los campos de cabecera de mensaje en HTTP como Accept-Charset, Accept-Encoding, Accept-Language, Content-Encoding, Content-Language? Estos son los temas que vamos a explorar a continuación.
Índice:
- 1. Conocimientos básicos
- 2. Conjuntos de caracteres y codificaciones de caracteres comunes
- 2.1. Conjunto de caracteres y codificación ASCII
- 2.2. Conjunto de caracteres y codificación GBXXXX
- 2.3. Conjunto de caracteres y codificación BIG5
- 3. Conjunto de caracteres Unicode y codificación UTF
- 3.1.UCS & UNICODE
- 3.2.UTF-32
- 3.3.UTF-16
- 3.4.UTF-8
- 4.Accept-Charset/Accept-Encoding/Accept-Language/Content-Type/Content-Encoding/Content-Language
- 5. Referencias y lectura adicional
1. Conocimientos básicos
La información almacenada en una computadora se representa mediante números binarios; los caracteres que vemos en la pantalla, como letras inglesas y caracteres chinos, son el resultado de convertir números binarios. En términos simples, las reglas según las cuales se almacenan los caracteres en la computadora, como qué representa a 'a', se denominan "codificación"; a la inversa, interpretar y mostrar los números binarios almacenados en la computadora se denomina "decodificación", similar al cifrado y descifrado en criptografía. Durante la decodificación, si se utilizan reglas de decodificación incorrectas, 'a' podría interpretarse como 'b' o como caracteres ilegibles.
Conjunto de caracteres (Charset): es el conjunto de todos los caracteres abstractos que soporta un sistema. Los caracteres son el término general para varios tipos de texto y símbolos, incluidos los idiomas de cada país, signos de puntuación, símbolos gráficos, números, etc.
Codificación de caracteres (Character Encoding): es un conjunto de reglas que permite emparejar un conjunto de caracteres de un lenguaje natural (como un alfabeto o un silabario) con otro conjunto de elementos (como números o pulsos eléctricos). Es decir, establece una correspondencia entre el conjunto de símbolos y el sistema numérico; es una tecnología básica del procesamiento de información. Generalmente, las personas utilizan conjuntos de símbolos (normalmente texto) para expresar información. Los sistemas de procesamiento de información basados en computadoras utilizan combinaciones de diferentes estados de componentes (hardware) para almacenar y procesar información. Las combinaciones de diferentes estados de los componentes pueden representar números en el sistema numérico, por lo que la codificación de caracteres consiste en convertir símbolos en números del sistema numérico que la computadora puede aceptar, denominados códigos numéricos.
2. Conjuntos de caracteres y codificaciones de caracteres comunes
Nombres comunes de conjuntos de caracteres: conjunto de caracteres ASCII, conjunto de caracteres GB2312, conjunto de caracteres BIG5, conjunto de caracteres GB18030, conjunto de caracteres Unicode, etc. Para que una computadora procese con precisión texto de varios conjuntos de caracteres, es necesario realizar la codificación de caracteres, de modo que la computadora pueda reconocer y almacenar varios tipos de texto.
2.1. Conjunto de caracteres y codificación ASCII
ASCII (American Standard Code for Information Interchange, Código Estándar Estadounidense para el Intercambio de Información) es un sistema de codificación informática basado en el alfabeto latino. Se utiliza principalmente para mostrar inglés moderno, mientras que su versión extendida, EASCII, puede mostrar aproximadamente otros idiomas de Europa occidental. Es el sistema de codificación de un solo byte más utilizado en la actualidad (aunque hay indicios de que Unicode lo está alcanzando) y equivale al estándar internacional ISO/IEC 646.
Conjunto de caracteres ASCII: incluye principalmente caracteres de control (tecla de retorno, retroceso, tecla de nueva línea, etc.); caracteres visualizables (letras mayúsculas y minúsculas en inglés, números arábigos y símbolos occidentales).
Codificación ASCII: las reglas para convertir el conjunto de caracteres ASCII en números del sistema numérico que la computadora puede aceptar. Se utilizan 7 bits para representar un carácter, con un total de 128 caracteres; sin embargo, el conjunto de caracteres codificado con 7 bits solo puede soportar 128 caracteres. Para representar más caracteres europeos de uso común, se extendió ASCII; el conjunto de caracteres ASCII extendido utiliza 8 bits para representar un carácter, con un total de 256 caracteres. El mapeo del conjunto de caracteres ASCII a las reglas de codificación numérica se muestra en la siguiente figura:
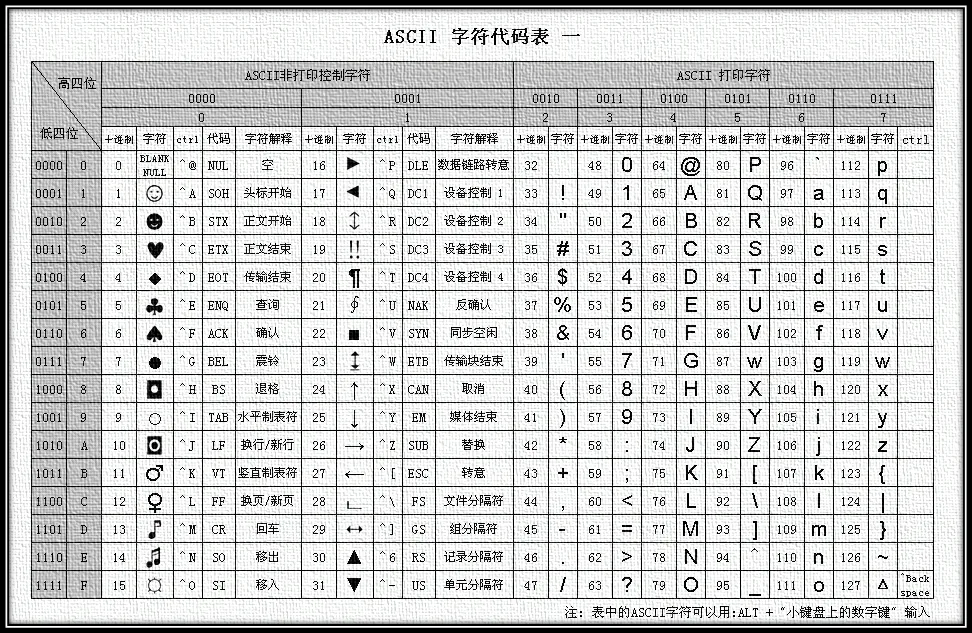
Figura 1 Tabla de codificación ASCII
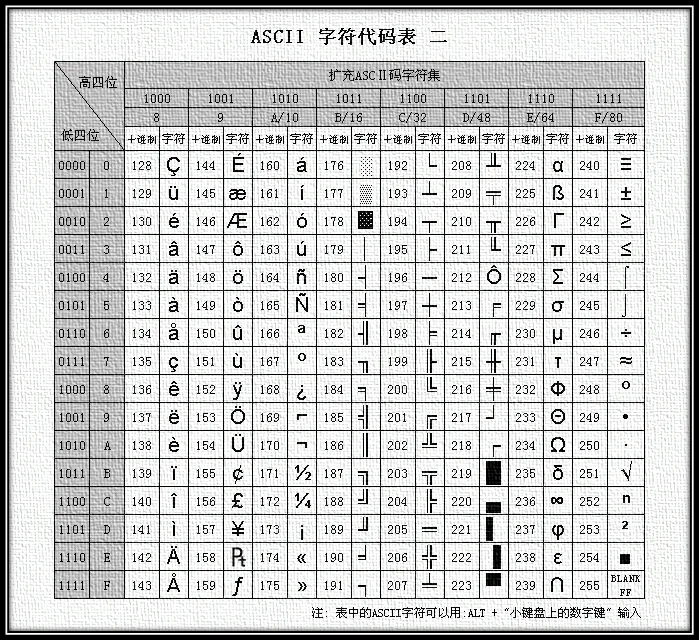
Figura 2 Tabla de codificación ASCII extendida
La mayor desventaja de ASCII es que solo puede mostrar las 26 letras latinas básicas, números arábigos y signos de puntuación británicos, por lo que solo se puede utilizar para mostrar inglés estadounidense moderno (y al procesar palabras extranjeras en inglés como naïve, café, élite, etc., todos los signos de acentuación deben eliminarse, incluso si esto viola las reglas ortográficas). Aunque EASCII resolvió el problema de visualización de algunos idiomas de Europa occidental, sigue siendo incapaz de manejar muchos otros idiomas. Por lo tanto, las computadoras Apple actuales ya han abandonado ASCII y han cambiado a Unicode.
2.2. Conjunto de caracteres y codificación GBXXXX
Cuando se inventó la computadora y durante mucho tiempo después, solo se utilizaba en Estados Unidos y algunos países desarrollados occidentales, y ASCII podía satisfacer bien las necesidades de los usuarios. Pero cuando el Reino Celestial (China) también tuvo computadoras, para poder mostrar chino, fue necesario diseñar un conjunto de reglas de codificación para convertir los caracteres chinos en números del sistema numérico que la computadora pudiera aceptar.
Los expertos del Reino Celestial eliminaron los símbolos extraños después del 127 (es decir, EASCII) y estipularon: un carácter menor que 127 tiene el mismo significado que antes, pero cuando dos caracteres mayores que 127 se juntan, representan un carácter chino. El primer byte (que llaman byte alto) va de 0xA1 a 0xF7, y el segundo byte (byte bajo) va de 0xA1 a 0xFE; de esta manera se pueden combinar aproximadamente más de 7000 caracteres chinos simplificados. En estas codificaciones también se incluyeron símbolos matemáticos, letras romanas y griegas, y kana japoneses; incluso los números, signos de puntuación y letras que ya existían en ASCII fueron recodificados con códigos de dos bytes de longitud. Esto es lo que comúnmente se llama caracteres de "ancho completo", mientras que los que estaban por debajo del 127 se denominan caracteres de "medio ancho".
La regla de codificación anterior es GB2312. GB2312 o GB2312-80 es el conjunto de caracteres chinos simplificados estándar nacional de China, cuyo nombre completo es "Conjunto de caracteres codificados para el intercambio de información en chino · Conjunto básico", también conocido como GB0. Fue publicado por la Administración Nacional de Normas de China e implementado el 1 de mayo de 1981. La codificación GB2312 se utiliza ampliamente en la China continental; Singapur y otros lugares también adoptan esta codificación. Casi todos los sistemas chinos y software internacionalizado en la China continental soportan GB2312. La aparición de GB2312 básicamente satisfizo las necesidades del procesamiento informático de caracteres chinos; los caracteres chinos que incluye cubren el 99.75% de la frecuencia de uso en la China continental. Para caracteres poco comunes que aparecen en nombres personales y chino clásico, GB2312 no puede manejarlos, lo que llevó a la aparición posterior de los conjuntos de caracteres chinos GBK y GB 18030. La siguiente figura muestra la parte inicial de la codificación GB2312 (debido a su gran tamaño, solo se enumera la parte inicial; para más detalles, se puede consultar la tabla de codificación GB2312 de chino simplificado):
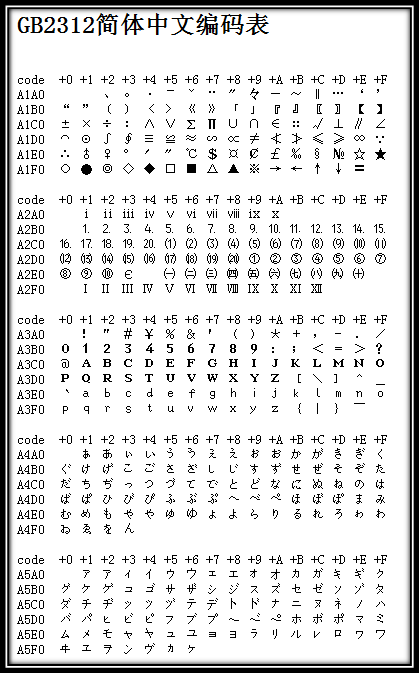
Figura 3 Parte inicial de la tabla de codificación GB2312
Dado que GB 2312-80 solo incluye 6763 caracteres chinos, muchos caracteres no están incluidos, como algunos caracteres chinos simplificados después del lanzamiento de GB 2312-80 (como "啰"), algunos caracteres utilizados en nombres personales (como "镕" del ex primer ministro chino Zhu Rongji), los caracteres tradicionales utilizados en Taiwán y Hong Kong, y los caracteres chinos japoneses y coreanos. Por lo tanto, Microsoft, utilizando el espacio de codificación no utilizado de GB 2312-80 e incluyendo todos los caracteres de GB 13000.1-93, creó la codificación GBK. Según la documentación de Microsoft, GBK es una extensión de GB2312-80, es decir, una extensión de la tabla de códigos CP936 (Code Page 936) (anteriormente, CP936 y GB 2312-80 eran idénticas), implementada por primera vez en la versión simplificada china de Windows 95. Aunque GBK incluye todos los caracteres de GB 13000.1-93, el método de codificación no es el mismo. GBK en sí no es un estándar nacional; solo fue publicado como "documento directriz de especificación técnica" por el Departamento de Normalización de la Administración Nacional de Supervisión Técnica y el Departamento de Ciencia, Tecnología y Supervisión de Calidad del Ministerio de Industria Electrónica. El GB13000 original nunca fue adoptado por la industria; el estándar nacional posterior GB18030 es técnicamente compatible con GBK, no con GB13000.
GB 18030, nombre completo: Norma Nacional GB 18030-2005 "Tecnología de la información: Conjunto de caracteres chinos codificados", es el conjunto de caracteres internos más reciente de la República Popular China y es una revisión de la GB 18030-2000 "Tecnología de la información: Conjunto de caracteres chinos codificados para intercambio de información: ampliación del conjunto básico". Es completamente compatible con GB 2312-1980, básicamente compatible con GBK, y soporta todos los caracteres chinos unificados de GB 13000 y Unicode, con un total de 70 244 caracteres chinos. GB 18030 tiene principalmente las siguientes características:
- Igual que UTF-8, utiliza codificación multibyte; cada carácter puede estar compuesto por 1, 2 o 4 bytes.
- El espacio de codificación es enorme; se pueden definir hasta 1,61 millones de caracteres.
- Soporta los escritos de las minorías étnicas de China, sin necesidad de utilizar áreas de creación de caracteres.
- El alcance de inclusión de caracteres chinos abarca caracteres tradicionales y caracteres chinos japoneses y coreanos.
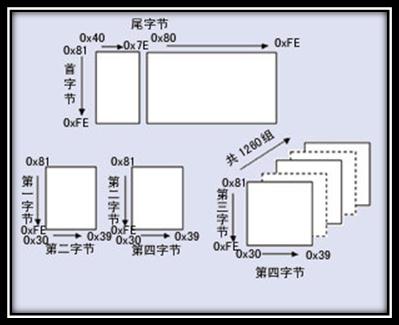
Figura 4 Estructura general de codificación GB18030
El borrador inicial de esta especificación fue elaborado por el Instituto de Estandarización de la Industria Electrónica del Ministerio de Industria de la Información de la República Popular China y publicado por la Administración Nacional de Supervisión de Calidad y Tecnología el 17 de marzo de 2000. La versión actual fue publicada por la Administración General de Supervisión de Calidad, Inspección y Cuarentena y la Administración Nacional de Normalización de China el 8 de noviembre de 2005, e implementada el 1 de mayo de 2006. Esta especificación es obligatoria para todos los productos de software dentro del territorio de China.
2.3. Conjunto de caracteres y codificación BIG5
Publicación externa. Unicode no deja de ampliarse; cada nueva versión incorpora más caracteres nuevos. Hasta la sexta versión actual, Unicode ya incluye más de cien mil caracteres (en 2005, el carácter número cien mil de Unicode fue adoptado y reconocido como parte del estándar), un conjunto de tablas de códigos que sirven como referencia visual, un método de codificación y un conjunto de codificaciones de caracteres estándar, una enumeración que incluye propiedades de caracteres como superíndices, subíndices, etc. La organización Unicode (The Unicode Consortium) es gestionada por una entidad sin fines de lucro y lidera el desarrollo posterior de Unicode; su objetivo es: reemplazar los esquemas de codificación de caracteres existentes con el esquema de codificación Unicode, especialmente porque los esquemas existentes, en entornos multilingües, solo tienen espacio limitado y problemas de incompatibilidad.
El código Big5 es un conjunto de caracteres de doble byte, que utiliza un método de almacenamiento de doble octeto, almacenando un carácter en dos bytes. El primer byte se denomina "byte alto" y el segundo byte se denomina "byte bajo". El "byte alto" utiliza 0x81-0xFE, y el "byte bajo" utiliza 0x40-0x7E, así como 0xA1-0xFE. En la partición de Big5:
| 0x8140-0xA0FE | Reservado para caracteres definidos por el usuario (zona de creación de caracteres). |
| 0xA140-0xA3BF |
Signos de puntuación, letras griegas y símbolos especiales, incluidos en 0xA259-0xA261, donde se colocan nueve caracteres chinos de medida: 兙兛兞兝兡兣嗧瓩糎. |
| 0xA3C0-0xA3FE | Reservado. Esta zona no está abierta para su uso como zona de creación de caracteres. |
| 0xA440-0xC67E | Caracteres chinos de uso común, ordenados primero por trazos y luego por radicales. |
| 0xC6A1-0xC8FE | Reservado para caracteres definidos por el usuario (zona de creación de caracteres). |
| 0xC940-0xF9D5 | Caracteres chinos de uso secundario, también ordenados primero por trazos y luego por radicales. |
| 0xF9D6-0xFEFE | Reservado para caracteres definidos por el usuario (zona de creación de caracteres). |
3. Conjunto de caracteres Unicode y codificación UTF
El gran concepto Unicode——Es necesario hablar de Unicode por separado.
Al igual que en el Imperio Celestial, cuando las computadoras llegaron a los distintos países del mundo, para adaptarse a los idiomas y caracteres locales, se diseñaron e implementaron esquemas de codificación similares a GB232/GBK/GB18030/BIG5. Así, cada uno hizo lo suyo; su uso local no presenta problemas, pero una vez que aparecen en la red, debido a la incompatibilidad, al acceder entre sí se producen caracteres ilegibles (mojibake).
Para resolver este problema, surgió una gran idea: Unicode. El sistema de codificación Unicode está diseñado para expresar cualquier carácter de cualquier idioma. Utiliza números de 4 bytes para representar cada letra, símbolo o ideograma (ideograph). Cada número representa un símbolo único que se utiliza al menos en algún idioma. (No todos los números se utilizan, pero el total ya supera los 65535, por lo que los números de 2 bytes no son suficientes). Los caracteres compartidos por varios idiomas suelen codificarse con el mismo número, a menos que exista una razón etimológica (etymological) legítima para no hacerlo. Sin tener en cuenta este caso, cada carácter corresponde a un número y cada número corresponde a un carácter. Es decir, no existe ambigüedad. Ya no es necesario registrar "modos". U+0041 siempre representa 'A', incluso si ese idioma no tiene el carácter 'A'.
En el campo de la informática, Unicode (código unificado, código universal, código único, código universal estándar) es un estándar de la industria que permite a las computadoras representar los sistemas de decenas de escrituras del mundo. Unicode se desarrolla sobre la base del estándar del Conjunto Universal de Caracteres (Universal Character Set) y también en forma de libro
(Se puede entender así: Unicode es un conjunto de caracteres; UTF-32/UTF-16/UTF-8 son tres esquemas de codificación de caracteres.)
3.1.UCS & UNICODE
conjunto universal de caracteres(Universal Character Set,UCS) es establecido por ISOISO 10646(o llamadoISO/IEC 10646) el conjunto de caracteres estándar definido por la norma. Históricamente existieron dos organizaciones que intentaron de manera independiente crear un único conjunto de caracteres: la Organización Internacional de Normalización (ISO) y el Consorcio Unicode, formado por fabricantes de software multilingüe. La primera desarrolló el proyecto ISO/IEC 10646; la segunda desarrolló el proyecto Unicode. Por lo tanto, inicialmente se establecieron normas diferentes.
Alrededor de 1991, los participantes de ambos proyectos reconocieron que el mundo no necesitaba dos conjuntos de caracteres incompatibles. Así pues, comenzaron a fusionar los resultados de sus trabajos y a colaborar para crear una única tabla de codificación. A partir de Unicode 2.0, Unicode adoptó el mismo repertorio de caracteres y códigos que ISO 10646-1; ISO también se comprometió a que ISO 10646 no asignaría valores a codificaciones UCS-4 más allá de U+10FFFF, a fin de mantener la coherencia entre ambos. Ambos proyectos siguen existiendo y publican sus estándares de forma independiente. Sin embargo, el Consorcio Unicode y el ISO/IEC JTC1/SC2 acordaron mantener la compatibilidad de las tablas de códigos de ambos estándares y ajustar conjuntamente cualquier extensión futura. En el momento de la publicación, Unicode generalmente adopta la forma glífica más común para los códigos correspondientes, mientras que ISO 10646, por lo general, procura utilizar glifos de estilo Century.
3.2.UTF-32
El esquema de codificación mencionado anteriormente, que utiliza números de 4 bytes para representar cada letra, símbolo o ideograma (ideograph), donde cada número representa un símbolo único utilizado al menos en algún idioma, se denomina UTF-32. UTF-32 también se conoce comoUCS-4Es un acuerdo para codificar caracteres Unicode que utiliza 4 bytes para cada carácter. En términos de espacio, es muy ineficiente.
Este método tiene sus ventajas; la más importante es que se puede localizar el enésimo carácter de una cadena en tiempo constante, porque el enésimo carácter comienza en el byte 4×N. Aunque usar un número fijo de bytes para cada punto de código parece conveniente, no se utiliza tan ampliamente como otras codificaciones Unicode.
3.3.UTF-16
Aunque los caracteres Unicode son muchísimos, en realidad la mayoría de las personas no llegan a usar caracteres más allá de los primeros 65535. Por lo tanto, existe otra forma de codificación Unicode, llamada UTF-16 (porque 16 bits = 2 bytes). UTF-16 codifica los caracteres en el rango de 0 a 65535 en 2 bytes; si realmente se necesita expresar esos caracteres Unicode poco utilizados dentro del "plano astral" (astral plane), más allá del rango de 65535, se requieren algunas técnicas especiales. La ventaja más obvia de la codificación UTF-16 es que es el doble de eficiente en espacio que UTF-32, porque cada carácter solo necesita 2 bytes para almacenarse (excepto fuera del rango de 65535), en lugar de los 4 bytes de UTF-32. Además, si suponemos que una cadena no contiene ningún carácter del plano astral, podemos seguir encontrando el enésimo carácter en tiempo constante; hasta que esa suposición deje de cumplirse, siempre es una buena inferencia. Su método de codificación es:
- Si el código de carácter U es menor que 0x10000, es decir, dentro del rango decimal de 0 a 65535, se representa directamente con dos bytes;
- Si el código de carácter U es mayor que 0x10000, dado que el rango máximo de codificación Unicode es 0x10FFFF, entre 0x10000 y 0x10FFFF hay un total de 0xFFFFF códigos, es decir, se necesitan 20 bits para representar estos códigos. Sea U' el valor entre 0 y 0xFFFFF; se toman sus primeros 10 bits como parte alta y se realiza una operación lógica OR con el valor de 16 bits 0xD800; se toman los últimos 10 bits como parte baja y se realiza una operación lógica OR con 0xDC00; los 4 bytes así formados constituyen la codificación de U.
Las codificaciones UTF-32 y UTF-16 tienen otras desventajas no tan evidentes. Los diferentes sistemas informáticos guardan los bytes en órdenes distintos. Esto significa que el carácter U+4E2D en codificación UTF-16 puede guardarse como 4E 2D o 2D 4E, dependiendo de si el sistema utiliza big-endian (extremo grande) o little-endian (extremo pequeño).(Para la codificación UTF-32, hay más posibles ordenaciones de bytes.)Mientras el documento no salga de tu computadora, sigue siendo seguro: los diferentes programas de la misma máquina usan el mismo orden de bytes (byte order). Pero cuando necesitamos transferir este documento entre sistemas, quizás en la World Wide Web, necesitamos un método para indicar cómo están almacenados nuestros bytes actualmente. De lo contrario, la computadora que recibe el documento no podrá saber si esos dos bytes 4E 2D representan U+4E2D o U+2D4E.
Para resolver este problema, las codificaciones Unicode multibyte definen una "marca de orden de bytes" (Byte Order Mark), un carácter especial no imprimible que puedes incluir al principio del documento para indicar el orden de bytes que estás utilizando. Para UTF-16, la marca de orden de bytes es U+FEFF. Si recibes un documento codificado en UTF-16 que comienza con los bytes FF FE, puedes determinar que su orden de bytes es en un sentido (one way); si comienza con FE FF, puedes determinar que el orden de bytes está invertido.
3.4.UTF-8
UTF-8 (formato de transformación Unicode de 8 bits) es una codificación de caracteres de longitud variable (código de longitud fija) para Unicode, y también es un código de prefijo. Puede utilizarse para representar cualquier carácter del estándar Unicode, y el primer byte de su codificación sigue siendo compatible con ASCII, lo que permite que el software que originalmente procesaba caracteres ASCII pueda seguir usándose sin modificaciones o con solo unas pocas modificaciones. Por lo tanto, se ha convertido gradualmente en la codificación preferida en el correo electrónico, las páginas web y otras aplicaciones que almacenan o transmiten texto. El Grupo de Trabajo de Ingeniería de Internet (IETF) exige que todos los protocolos de Internet sean compatibles con la codificación UTF-8.
UTF-8 utiliza de uno a cuatro bytes para codificar cada carácter:
- 128 caracteres US-ASCII solo necesitan un byte de codificación (rango Unicode de U+0000 a U+007F).
- 2. El latín con diacríticos, el griego, el cirílico, el armenio, el hebreo, el árabe, el siríaco y el alfabeto thaana requieren codificación de dos bytes (rango Unicode de U+0080 a U+07FF).
- Otros caracteres del plano básico multilingüe (BMP) (que incluye la mayoría de los caracteres comunes) se codifican con tres bytes.
- Otros caracteres de los planos suplementarios de Unicode, que se usan muy raramente, se codifican con cuatro bytes.
Es muy eficiente para el manejo de los caracteres ASCII que se usan con frecuencia. En el manejo de los conjuntos de caracteres latinos extendidos, tampoco es inferior a UTF-16. Para los caracteres chinos, es mejor que UTF-32. Al mismo tiempo, (en este punto tienes que creerme, porque no pretendo mostrarte sus principios matemáticos.) Debido a la naturaleza de las operaciones de bits, con UTF-8 ya no existe el problema del orden de bytes. Un documento codificado en UTF-8 es el mismo flujo de bits entre diferentes computadoras.
En general, en una cadena Unicode no es posible determinar la longitud necesaria para mostrarla a partir del número de puntos de código, ni la posición donde debería colocarse el cursor en el búfer de texto después de mostrar la cadena; los caracteres combinados, las fuentes de ancho variable, los caracteres no imprimibles y los textos de derecha a izquierda son sus causas. Así que aunque en las cadenas UTF-8 la relación entre el número de caracteres y el número de puntos de código es más compleja que en UTF-32, en la práctica rara vez se encuentran situaciones diferentes.
Ventajas
- UTF-8 es un superconjunto de ASCII. Dado que una cadena ASCII pura también es una cadena UTF-8 válida, el texto ASCII existente no necesita conversión. El software diseñado para los conjuntos de caracteres ASCII extendidos tradicionales normalmente puede funcionar con UTF-8 sin modificaciones o con muy pocas modificaciones.
- Ordenar UTF-8 con rutinas de ordenación estándar orientadas a bytes producirá los mismos resultados que ordenar según los puntos de código Unicode. (Aunque esto solo tiene una utilidad limitada, porque en cualquier idioma o cultura concreta es poco probable que haya un orden de clasificación de texto que siga siendo aceptable.)
- UTF-8 y UTF-16 son ambas codificaciones estándar para documentos XML. Todas las demás codificaciones deben especificarse mediante una declaración explícita o de texto.
- Cualquier algoritmo de búsqueda de cadenas orientado a bytes puede utilizarse con datos UTF-8 (siempre que la entrada consista únicamente en caracteres UTF-8 completos). Sin embargo, se debe tener cuidado con las expresiones regulares u otras estructuras que contengan conteo de caracteres.
- Las cadenas UTF-8 pueden reconocerse de forma fiable mediante un algoritmo simple. Es decir, la probabilidad de que una cadena en cualquier otra codificación parezca un UTF-8 válido es muy baja, y disminuye a medida que aumenta la longitud de la cadena. Por ejemplo, los valores de carácter C0, C1, F5 a FF nunca aparecen. Para una mayor fiabilidad, se pueden usar expresiones regulares para detectar sobrelongitudes ilegales y valores sustitutos (se puede consultarW3 FAQ: Multilingual Formsla expresión regular para validar cadenas UTF-8 en).
Desventajas
Debido a que cada carácter se codifica con una cantidad diferente de bytes, encontrar el enésimo carácter en una cadena es una operación de complejidad O(N) — es decir, cuanto más larga es la cadena, más tiempo se necesita para localizar un carácter concreto. Además, se requieren manipulaciones de bits para codificar caracteres en bytes y decodificar bytes en caracteres.
4.Accept-Charset/Accept-Encoding/Accept-Language/Content-Type/Content-Encoding/Content-Language
En HTTP, las cabeceras de mensaje relacionadas con el conjunto de caracteres y la codificación de caracteres son Accept-Charset/Content-Type; además, se distinguen principalmente Accept-Charset/Accept-Encoding/Accept-Language/Content-Type/Content-Encoding/Content-Language:
Accept-Charset: el navegador declara el conjunto de caracteres que acepta; estos son los diversos conjuntos de caracteres y codificaciones de caracteres presentados anteriormente en este artículo, como gb2312, utf-8 (normalmente decimos que Charset incluye el esquema de codificación de caracteres correspondiente);
Accept-Encoding: el navegador declara los métodos de codificación que acepta; normalmente especifica el método de compresión, si admite compresión y qué métodos de compresión admite (gzip, deflate). (Nota: esto no se refiere a la codificación de caracteres);
Accept-Language: el navegador declara los idiomas que acepta. La diferencia entre idioma y conjunto de caracteres: el chino es un idioma, y el chino tiene varios conjuntos de caracteres, como big5, gb2312, gbk, etc.;
Content-Type: el servidor WEB le indica al navegador el tipo y el conjunto de caracteres del objeto de su respuesta. Por ejemplo: Content-Type: text/html; charset='gb2312'
Content-Encoding: el servidor WEB indica qué método de compresión (gzip, deflate) utilizó para comprimir los objetos en la respuesta. Por ejemplo: Content-Encoding: gzip
Content-Language: el servidor WEB le dice al navegador el idioma del objeto de su respuesta.
5. Referencias y lectura adicional
- Baidu Baike. Conjunto de caracteres.http://baike.baidu.com/view/51987.htm, 2010-12-28
- Wikipedia. Codificación de caracteres.http://zh.wikipedia.org/wiki/%E5%AD%97%E7%AC%A6%E7%BC%96%E7%A0%81, 2011-1-5
- Wikipedia. ASCII.http://zh.wikipedia.org/wiki/ASCII, 2011-4-5
- Wikipedia. GB2312.http://zh.wikipedia.org/wiki/GB_2312, 2011-3-17
- Wikipedia. GB18030.http://zh.wikipedia.org/wiki/GB_18030, 2010-3-10
- Wikipedia. GBK.http://zh.wikipedia.org/wiki/GBK, 2011-3-7
- Wikipedia. Unicode.http://zh.wikipedia.org/wiki/Unicode, 2011-4-30
- Laruence. Explicación detallada de la codificación de caracteres (básico).http://www.laruence.com/2009/08/22/1059.html, 2009-8-22
- Jan Hunt. Character Sets and Encoding for Web Designers - UCS/UNICODE. http://www.uninetnews.com/other_standards/charset.php
Autor: Wu Qin
Fuente: http://www.cnblogs.com/skynet/archive/2011/05/03/2035105.html