Der sogenannte Index ist eine spezifische algorithmische Sortierung für bestimmte MySQL-Felder, wie z. B. den Binärbaumalgorithmus und den Hash-Algorithmus. Der Hash-Algorithmus erstellt Merkmalswerte und findet dann anhand der Merkmalswerte schnell. Der am häufigsten verwendete und von MySQL standardmäßig verwendete Algorithmus ist der Binärbaumalgorithmus BTREE. Bei Feldern, die mit dem BTREE-Algorithmus indiziert sind, kann beispielsweise das Scannen von 20 Zeilen Ergebnisse liefern, für die ohne BTREE das Scannen von 2^20 Zeilen erforderlich wäre.
EXPLAIN-Optimierung der Abfrageerkennung
EXPLAIN kann Entwicklern helfen, SQL-Probleme zu analysieren. EXPLAIN zeigt, wie MySQL Indizes verwendet, um SELECT-Anweisungen und Tabellenjoins zu verarbeiten, und kann helfen, bessere Indizes auszuwählen und optimiertere Abfrageanweisungen zu schreiben.
Verwendung: Fügen Sie einfach EXPLAIN vor der SELECT-Anweisung hinzu:
Explain select * from blog where false;
Bevor eine Abfrage ausgeführt wird, analysiert MySQL jede gesendete SQL-Anweisung, um zu entscheiden, ob ein Index verwendet oder ein vollständiger Tabellenscan durchgeführt werden soll. Wenn Sie `select * from blog where false` senden, führt MySQL die Abfrage nicht aus, denn nach der Analyse durch den SQL-Analysator weiß MySQL bereits, dass keine Zeilen die Bedingung erfüllen werden.
Beispiel
mysql> EXPLAIN SELECT `birday` FROM `user` WHERE `birthday` < "1990/2/2";
-- 结果:
id: 1

select_type: SIMPLE -- 查询类型(简单查询、联合查询、子查询)

table: user -- 显示这一行的数据是关于哪张表的 。

type: range -- 区间索引(在小于1990/2/2区间的数据),这是重要的列,显示连接使用了何种类型。从最好到最差的连接类型为system > const > eq_ref > ref > fulltext > ref_or_null > index_merge > unique_subquery > index_subquery > range > index > ALL,const代表一次就命中,ALL代表扫描了全表才确定结果。一般来说,得保证查询至少达到range级别,最好能达到ref.

possible_keys: birthday  -- 指出MySQL能使用哪个索引在该表中找到行。如果是空的,没有相关的索引。这时要提高性能,可通过检验WHERE子句,看是否引用某些字段,或者检查字段不是适合索引。

key: birthday -- 实际使用到的索引。如果为NULL,则没有使用索引。如果为primary的话,表示使用了主键。

key_len: 4 -- 最长的索引宽度。如果键是NULL,长度就是NULL。在不损失精确性的情况下,长度越短越好。

ref: const -- 显示哪个字段或常数与key一起被使用。

rows: 1 -- 这个数表示mysql要遍历多少数据才能找到,在innodb上是不准确的。

Extra: Using where; Using index -- 执行状态说明,这里可以看到的坏的例子是Using temporary和Using
select_type
- simple: einfaches SELECT (verwendet weder UNION noch Unterabfragen).
- primary: das äußerste SELECT.
- union: die zweite oder nachfolgende SELECT-Anweisung in einem UNION.
- dependent union: die zweite oder nachfolgende SELECT-Anweisung in einem UNION, abhängig von der äußeren Abfrage.
- union result: das Ergebnis eines UNION.
- subquery: das erste SELECT in einer Unterabfrage.
- dependent subquery: das erste SELECT in einer Unterabfrage, abhängig von der äußeren Abfrage.
- derived: das SELECT einer abgeleiteten Tabelle (Unterabfrage in der FROM-Klausel).
Weitere Hinweise
- Distinct: Sobald MySQL eine Zeile findet, die zum Join passt, sucht es nicht weiter.
- Not exists: MySQL optimiert LEFT JOIN; sobald es eine Zeile findet, die die Kriterien des LEFT JOIN erfüllt, sucht es nicht weiter.
- Range checked for each Record (index map:#): Es wurde kein idealer Index gefunden, daher prüft MySQL für jede Zeilenkombination aus der vorherigen Tabelle, welcher Index verwendet werden soll, und verwendet ihn, um Zeilen aus der Tabelle zurückzugeben. Dies ist einer der langsamsten Joins, die Indizes verwenden.
- Using filesort: Wenn Sie dies sehen, muss die Abfrage optimiert werden. MySQL benötigt einen zusätzlichen Schritt, um herauszufinden, wie die zurückgegebenen Zeilen sortiert werden. Es sortiert alle Zeilen basierend auf dem Join-Typ und den Zeilenzeigern für alle Zeilen, die Sortierschlüsselwerte speichern und den Bedingungen entsprechen.
- Using index: Spaltendaten werden aus einer Tabelle nur unter Verwendung von Informationen im Index zurückgegeben, ohne tatsächliche Zeilen zu lesen. Dies geschieht, wenn alle angeforderten Spalten für die Tabelle Teil desselben Index sind.
- Using temporary: Wenn Sie dies sehen, muss die Abfrage optimiert werden. Hier muss MySQL eine temporäre Tabelle erstellen, um Ergebnisse zu speichern, was normalerweise geschieht, wenn sich ORDER BY auf eine andere Spaltenmenge bezieht als GROUP BY.
- Where used: Die WHERE-Klausel wird verwendet, um einzuschränken, welche Zeilen zur nächsten Tabelle passen oder an den Benutzer zurückgegeben werden. Dies tritt auf, wenn Sie nicht alle Zeilen aus der Tabelle zurückgeben möchten und der Join-Typ ALL oder index ist, oder wenn ein Problem mit der Abfrage vorliegt. Erklärung der verschiedenen Join-Typen (geordnet von hoher bis niedriger Effizienz).
- system: Die Tabelle hat nur eine Zeile: Systemtabelle. Dies ist ein Sonderfall des Join-Typs const.
- const: Höchstens ein Datensatz in der Tabelle kann dieser Abfrage entsprechen (der Index kann ein Primärschlüssel oder eindeutiger Index sein). Da es nur eine Zeile gibt, ist dieser Wert tatsächlich eine Konstante, denn MySQL liest diesen Wert zuerst und behandelt ihn dann als Konstante.
- eq_ref: In einem Join liest MySQL während der Abfrage für jede Datensatzkombination aus der vorherigen Tabelle einen Datensatz aus der Tabelle. Er wird verwendet, wenn die Abfrage einen Index verwendet, der vollständig ein Primärschlüssel oder ein eindeutiger Schlüssel ist.
- ref: Dieser Join-Typ tritt nur auf, wenn die Abfrage einen Schlüssel verwendet, der nicht eindeutig oder kein Primärschlüssel ist, oder einen Teil dieser Typen (zum Beispiel unter Verwendung des am weitesten links stehenden Präfixes). Für jede Zeilenkombination aus der vorherigen Tabelle werden alle passenden Datensätze aus der Tabelle gelesen. Dieser Typ hängt stark davon ab, wie viele Datensätze der Index trifft; je weniger, desto besser.
- range: Dieser Join-Typ verwendet einen Index, um Zeilen in einem Bereich zurückzugeben, etwa wenn mit > oder < gesucht wird.
- index: Dieser Join-Typ führt für jede Datensatzkombination aus der vorherigen Tabelle einen vollständigen Scan durch (besser als ALL, weil der Index im Allgemeinen kleiner als die Tabellendaten ist).
- ALL: Dieser Join-Typ führt für jede Datensatzkombination aus der vorherigen Tabelle einen vollständigen Scan durch. Das ist im Allgemeinen schlecht und sollte so weit wie möglich vermieden werden.
Darunter type:
- Wenn dort 'Only index' steht, bedeutet das, dass die Informationen nur unter Verwendung der Informationen im Indexbaum abgerufen werden, was schneller ist als das Scannen der gesamten Tabelle.
- Wenn dort 'where used' steht, bedeutet das, dass die WHERE-Einschränkung verwendet wird.
- Wenn dort 'impossible where' steht, bedeutet das, dass WHERE unnötig ist; im Allgemeinen wurde nichts gefunden.
- Wenn diese Information Using filesort oder Using temporary anzeigt, wird es sehr mühsam. Indizes für WHERE und ORDER BY können oft nicht beide erfüllt werden. Wenn man den Index anhand von WHERE festlegt, führt dies bei ORDER BY unweigerlich zu Using filesort. Es hängt davon ab, ob es kostengünstiger ist, zuerst zu filtern und dann zu sortieren, oder zuerst zu sortieren und dann zu filtern.
Index-Typen
UNIQUE-Index
Doppelte Werte sind nicht erlaubt, aber NULL-Werte sind erlaubt.
INDEX normaler Index
Doppelter Indexinhalt ist erlaubt.
PRIMARY KEY-Index
Doppelte Werte sind nicht erlaubt, und NULL-Werte sind ebenfalls nicht erlaubt. Eine Tabelle kann nur einen primary_key-Index haben.
Fulltext-Index
Die oben genannten drei Indexarten wirken auf die Werte von Spalten, aber der Fulltext-Index kann auf ein bestimmtes Wort im Wert abzielen, z. B. auf ein Wort in einem Artikel. Er ist jedoch nutzlos, weil nur MyISAM und Englisch unterstützt werden und die Effizienz nicht beeindruckend ist. Aber Drittanbieter-Anwendungen wie Coreseek und Xunsearch können verwendet werden, um diese Anforderung zu erfüllen.
Index CURD
Indizes erstellen
ALTER TABLE
Geeignet zum Hinzufügen, nachdem die Tabelle erstellt wurde.
`ALTER TABLE table_name ADD index_type (unique, primary key, fulltext, index) [index_name] (field_name)`
ALTER TABLE `table_name` ADD INDEX `index_name` (`column_list`) -- 索引名,可要可不要;如果不要,当前的索引名就是该字段名。
ALTER TABLE `table_name` ADD UNIQUE (`column_list`)
ALTER TABLE `table_name` ADD PRIMARY KEY (`column_list`)
ALTER TABLE `table_name` ADD FULLTEXT KEY (`column_list`)
CREATE INDEX
`CREATE INDEX` kann einer Tabelle einen normalen Index oder einen UNIQUE-Index hinzufügen.
--例:只能添加这两种索引
CREATE INDEX index_name ON table_name (column_list)
CREATE UNIQUE INDEX index_name ON table_name (column_list)
Darüber hinaus können Sie sie auch beim Erstellen der Tabelle hinzufügen:
CREATE TABLE `test1` (
  `id` smallint(5) UNSIGNED AUTO_INCREMENT NOT NULL, -- 注意,下面创建了主键索引,这里就不用创建了
  `username` varchar(64) NOT NULL COMMENT '用户名',
  `nickname` varchar(50) NOT NULL COMMENT '昵称/姓名',
  `intro` text,
  PRIMARY KEY (`id`),
  UNIQUE KEY `unique1` (`username`), -- 索引名称,可要可不要,不要就是和列名一样
  KEY `index1` (`nickname`),
  FULLTEXT KEY `intro` (`intro`)
) ENGINE=MyISAM AUTO_INCREMENT=4 DEFAULT CHARSET=utf8 COMMENT='后台用户表';
Löschen von Indizes
DROP INDEX `index_name` ON `talbe_name`
ALTER TABLE `table_name` DROP INDEX `index_name`
-- 这两句都是等价的,都是删除掉table_name中的索引index_name;

ALTER TABLE `table_name` DROP PRIMARY KEY -- 删除主键索引,注意主键索引只能用这种方式删除
Anzeigen von Indizes
show index from tablename;
Ändern von Indizes
Ändern? Auf keinen Fall. Löschen Sie ihn einfach und erstellen Sie einen neuen.
Tipps zum Erstellen von Indizes
- Erstellen Sie Indizes für Spalten mit hoher Kardinalität.
- In einer Datenspalte,die Anzahl der nicht duplizierten Werte,die vorkommen. Je höher diese Zahl, desto höher die Kardinalität.
- Wenn sich beispielsweise 8 Datenzeilen a,b,c,d,a,b,c,d in der Tabelle befinden, beträgt die Kardinalität dieser Tabelle 4.
- Indizes sollten für Spalten mit hoher Kardinalität erstellt werden, wie z. B. Alter und Geschlecht; Alter hat eine höhere Kardinalität als Geschlecht.
- Spalten wie gender eignen sich nicht für die Indizierung, weil die Kardinalität zu niedrig ist.
- Verwende Indizes für Spalten, die in WHERE, ON, GROUP BY und ORDER BY vorkommen.
- Verwende Indizes für kleinere Datenspalten; dadurch wird die Indexdatei kleiner und außerdem können mehr Indexschlüssel in den Speicher geladen werden.
- Verwende Präfixindizes für längere Zeichenketten.
- Erstelle nicht zu viele Indizes. Abgesehen davon, dass zusätzlicher Speicherplatz auf der Festplatte benötigt wird, beeinträchtigt dies die Geschwindigkeit von DML-Operationen stark, weil jedes Einfügen, Löschen oder Aktualisieren einen Neuaufbau des Index erfordert.
- Die Verwendung zusammengesetzter Indizes kann die Größe der Indexdatei verringern und ist bei der Nutzung schneller als mehrere Einspaltenindizes.
Zusammengesetzter Index und Präfixindex
Hinweis: Diese beiden Begriffe bezeichnen Indexierungstechniken, nicht Arten von Indizes.
Zusammengesetzter Index
Was genau ist der Unterschied zwischen MySQL-Einspaltenindizes und zusammengesetzten Indizes?
Um die beiden anschaulich zu vergleichen, erstelle zuerst eine Tabelle:
CREATE TABLE `myIndex` (
  `i_testID` INT NOT NULL AUTO_INCREMENT,
  `vc_Name` VARCHAR(50) NOT NULL,
  `vc_City` VARCHAR(50) NOT NULL,
  `i_Age` INT NOT NULL,
  `i_SchoolID` INT NOT NULL,
  PRIMARY KEY (`i_testID`)
);
Angenommen, die Tabelle hat bereits 1000 Datenzeilen. Unter diesen 10,000 Datensätzen sind 5 Datensätze mit vc_Name="erquan" hier und da verstreut, aber die Kombinationen aus city, age und school sind jeweils unterschiedlich. Sieh dir dieses T-SQL an:
SELECT `i_testID` FROM `myIndex` WHERE `vc_Name`='erquan' AND `vc_City`='郑州' AND `i_Age`=25; -- 关联搜索;
Ziehe zunächst in Betracht, einen MySQL-Einspaltenindex zu erstellen:
Ein Index wurde auf der Spalte vc_Name erstellt. Bei der Ausführung von T-SQL hat MySQL schnell die 5 Datensätze mit vc_Name='erquan' gefunden, sie herausgenommen und in eine Zwischenergebnismenge gelegt. In dieser Ergebnismenge wurden zuerst Datensätze ausgeschlossen, bei denen vc_City nicht gleich "Zhengzhou" war, dann Datensätze ausgeschlossen, bei denen i_Age nicht gleich 25 war, und schließlich der einzige passende Datensatz herausgefiltert. Obwohl ein Index auf vc_Name erstellt wurde, muss MySQL bei Abfragen nicht die gesamte Tabelle durchsuchen, sodass die Effizienz verbessert wurde, aber sie ist immer noch ein Stück von unseren Anforderungen entfernt. Ähnlich verhält es sich mit der Effizienz von Einzelspaltenindizes, die separat auf vc_City und i_Age erstellt wurden.
Um die Effizienz aus MySQL weiter herauszuholen, müssen wir in Betracht ziehen, einen zusammengesetzten Index zu erstellen. Das heißt, vc_Name, vc_City und i_Age in einen Index zu packen:
ALTER TABLE `myIndex` ADD INDEX `name_city_age` (vc_Name(10),vc_City,i_Age);
Beim Erstellen der Tabelle beträgt die Länge von vc_Name 50. Warum wird hier 10 verwendet? Das ist der weiter unten erwähnte Präfixindex, denn unter normalen Umständen wird die Länge eines Namens 10 nicht überschreiten. Dies beschleunigt die Indexabfrageleistung, reduziert die Größe der Indexdatei und verbessert die Geschwindigkeit von INSERT-Aktualisierungen.
Bei der Ausführung von T-SQL kann MySQL den einzigen Datensatz finden, ohne irgendwelche Datensätze zu scannen!
Wenn separate Einzelspaltenindizes auf vc_Name, vc_City und i_Age erstellt werden, sodass die Tabelle 3 Einzelspaltenindizes hat, wird die Abfrageeffizienz dann dieselbe sein wie bei dem obigen zusammengesetzten Index? Die Antwort ist völlig anders, weit niedriger als bei unserem zusammengesetzten Index. Obwohl es jetzt drei Indizes gibt, kann MySQL nur denjenigen verwenden, den es für den effizientesten Einzelspaltenindex hält; die anderen beiden können nicht verwendet werden. Mit anderen Worten, es ist immer noch ein vollständiger Tabellenscanvorgang.
Das Erstellen eines solchen zusammengesetzten Indexes entspricht tatsächlich dem separaten Erstellen von:
- vc_Name,vc_City,i_Age
- vc_Name,vc_City
- vc_Name
Diese drei zusammengesetzten Indizes! Warum gibt es keinen zusammengesetzten Index wie vc_City, i_Age? Das liegt am Ergebnis des "Leftmost Prefix" bei zusammengesetzten MySQL-Indizes. Ein einfaches Verständnis ist, dass die Kombination nur von der äußersten linken Seite aus beginnt. Nicht jede Abfrage, die diese drei Spalten enthält, verwendet den zusammengesetzten Index. Die folgenden T-SQL-Anweisungen verwenden ihn:
SELECT * FROM myIndex WHREE vc_Name=”erquan” AND vc_City=”郑州” SELECT * FROM myIndex WHREE vc_Name=”erquan”
Die folgenden verwenden ihn jedoch nicht:
SELECT * FROM myIndex WHREE i_Age=20 AND vc_City=”郑州” SELECT * FROM myIndex WHREE vc_City=”郑州”
Das heißt, name_city_age(vc_Name(10), vc_City, i_Age) führt die Indizierung von links nach rechts durch. Wenn kein linker Präfixindex vorhanden ist, führt MySQL keine Indexabfrage aus.
Präfixindex
Wenn die indizierte Spalte zu lang ist, erzeugt die Indizierung einer solchen Spalte eine sehr große Indexdatei und ist unbequem zu handhaben. Sie können die Präfixindex-Methode verwenden. Der Präfixindex sollte an einem geeigneten Punkt kontrolliert werden, etwa beim goldenen Wert von 0.31 (wenn er größer als dieser Wert ist, können Sie ihn erstellen).
SELECT COUNT(DISTINCT(LEFT(`title`,10)))/COUNT(*) FROM Arctic; — Wenn dieser Wert größer als 0.31 ist, können Sie einen Präfixindex erstellen. DISTINCT entfernt Duplikate. ALTER TABLE `user` ADD INDEX `uname`(title(10)); — SQL zum Hinzufügen eines Präfixindex, der den Index für den Namen auf den ersten 10 Zeichen setzt. Dies reduziert die Größe der Indexdatei und beschleunigt Indexabfragen.
Welche Art von SQL verwendet keine Indizes
Versuchen Sie, diese SQL-Anweisungen zu vermeiden, die keine Indizes verwenden.
SELECT `sname` FROM `stu` WHERE `age`+10=30;-- 不会使用索引,因为所有索引列参与了计算

SELECT `sname` FROM `stu` WHERE LEFT(`date`,4) <1990; -- 不会使用索引,因为使用了函数运算,原理与上面相同

SELECT * FROM `houdunwang` WHERE `uname` LIKE'后盾%' -- 走索引

SELECT * FROM `houdunwang` WHERE `uname` LIKE "%后盾%" -- 不走索引

-- 正则表达式不使用索引,这应该很好理解,所以为什么在SQL中很难看到regexp关键字的原因

-- 字符串与数字比较不使用索引;
CREATE TABLE `a` (`a` char(10));
EXPLAIN SELECT * FROM `a` WHERE `a`="1" -- 走索引
EXPLAIN SELECT * FROM `a` WHERE `a`=1 -- 不走索引

select * from dept where dname='xxx' or loc='xx' or deptno=45 --如果条件中有or,即使其中有条件带索引也不会使用。换言之,就是要求使用的所有字段,都必须建立索引,我们建议大家尽量避免使用or 关键字

-- 如果mysql估计使用全表扫描要比使用索引快,则不使用索引
Indexeffizienz bei Multi-Table-Joins
- SELECT `sname` FROM `stu` WHERE LEFT(`date`,4) < 1990; — Dies verwendet den Index nicht, weil eine Funktionsoperation verwendet wird; das Prinzip ist dasselbe wie oben.
- SELECT * FROM `houdunwang` WHERE `uname` LIKE 'after盾%' — verwendet den Index
- SELECT * FROM `houdunwang` WHERE `uname` LIKE '%after盾%' — verwendet den Index nicht
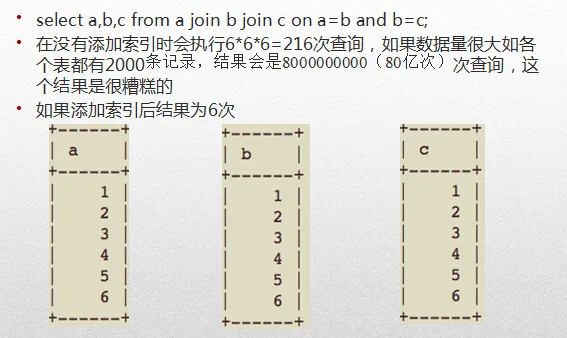
Aus der obigen Abbildung können wir ersehen, dass der Typ aller Tabellen "all" ist, was auf einen vollständigen Tabellenscan hindeutet. Das heißt, 6 6 6, insgesamt 216 Traversierungsabfragen.
Mit Ausnahme der ersten Tabelle, bei der es sich um einen vollständigen Tabellenscan handelt (notwendig, da sie verwendet wird, um die anderen Tabellen zu verknüpfen), sind die übrigen "range" (über Indexbereich abgerufen), d. h. 6+1+1+1, insgesamt 9 Traversierungsabfragen.
Daher empfehlen wir, bei Mehrtabellen-Joins so wenige Tabellen wie möglich zu verknüpfen, denn wenn man nicht aufpasst, wird daraus ein erschreckender kartesischer Produktscan. Darüber hinaus empfehlen wir, möglichst LEFT JOIN zu verwenden und von der kleineren Tabelle zur größeren zu verknüpfen. Denn bei Verwendung von JOIN muss die erste Tabelle vollständig gescannt werden, und die Verwendung der kleineren Tabelle zum Ansteuern der größeren kann diese Anzahl von Scans reduzieren.
Nachteile von Indizes
Erstellen Sie nicht blind Indizes. Erstellen Sie Indizes nur für Spalten, die häufig in Abfrageoperationen verwendet werden. Das Erstellen eines Index beschleunigt Abfrageoperationen, verlangsamt jedoch Einfüge-, Lösch- und Aktualisierungsvorgänge, da für diese Vorgänge auch eine Neusortierung oder Aktualisierung der Indexdatei erforderlich ist.
In Internetanwendungen überwiegen jedoch Abfrageanweisungen bei Weitem die DML-Anweisungen, sogar 80 % bis 90 %. Machen Sie sich also nicht zu viele Sorgen. Beim Importieren großer Datenmengen können Sie zuerst den Index löschen, dann die Daten stapelweise einfügen und schließlich den Index erneut hinzufügen.