Ce qu'on appelle un index consiste à effectuer un tri selon un algorithme spécifique pour des champs MySQL particuliers, comme l'algorithme d'arbre binaire et l'algorithme de hachage. L'algorithme de hachage établit des valeurs caractéristiques, puis effectue une recherche rapide à partir de ces valeurs caractéristiques. L'algorithme le plus utilisé, et celui par défaut de MySQL, est l'algorithme d'arbre binaire BTREE. Pour les champs indexés à l'aide de l'algorithme BTREE, par exemple, le scan de 20 lignes peut obtenir des résultats qui nécessiteraient le scan de 2^20 lignes sans BTREE.
Détection d'optimisation de requêtes avec Explain
EXPLAIN peut aider les développeurs à analyser les problèmes SQL. explain montre comment MySQL utilise les index pour traiter les instructions SELECT et effectuer des jointures entre tables, et peut aider à choisir de meilleurs index et à écrire des requêtes plus optimisées.
Utilisation : ajoutez simplement EXPLAIN avant l'instruction SELECT :
Explain select * from blog where false;
Avant d'exécuter une requête, MySQL analyse chaque instruction SQL envoyée pour décider s'il faut utiliser un index ou effectuer un parcours complet de table. Si vous envoyez un `select * from blog where false`, MySQL n'exécutera pas la requête, car après analyse par l'analyseur SQL, MySQL sait déjà qu'aucune ligne ne correspondra à la condition.
Exemple
mysql> EXPLAIN SELECT `birday` FROM `user` WHERE `birthday` < "1990/2/2";
-- 结果:
id: 1

select_type: SIMPLE -- 查询类型(简单查询、联合查询、子查询)

table: user -- 显示这一行的数据是关于哪张表的 。

type: range -- 区间索引(在小于1990/2/2区间的数据),这是重要的列,显示连接使用了何种类型。从最好到最差的连接类型为system > const > eq_ref > ref > fulltext > ref_or_null > index_merge > unique_subquery > index_subquery > range > index > ALL,const代表一次就命中,ALL代表扫描了全表才确定结果。一般来说,得保证查询至少达到range级别,最好能达到ref.

possible_keys: birthday  -- 指出MySQL能使用哪个索引在该表中找到行。如果是空的,没有相关的索引。这时要提高性能,可通过检验WHERE子句,看是否引用某些字段,或者检查字段不是适合索引。

key: birthday -- 实际使用到的索引。如果为NULL,则没有使用索引。如果为primary的话,表示使用了主键。

key_len: 4 -- 最长的索引宽度。如果键是NULL,长度就是NULL。在不损失精确性的情况下,长度越短越好。

ref: const -- 显示哪个字段或常数与key一起被使用。

rows: 1 -- 这个数表示mysql要遍历多少数据才能找到,在innodb上是不准确的。

Extra: Using where; Using index -- 执行状态说明,这里可以看到的坏的例子是Using temporary和Using
select_type
- simple : SELECT simple (n'utilise pas UNION ni de sous-requêtes).
- primary : le SELECT le plus externe.
- union : la deuxième instruction SELECT ou une instruction suivante dans un UNION.
- dependent union : la deuxième instruction SELECT ou une instruction suivante dans un UNION, dépendante de la requête externe.
- union result : le résultat d'un UNION.
- subquery : le premier SELECT d’une sous-requête.
- dependent subquery : le premier SELECT d’une sous-requête, dépendant de la requête externe.
- derived : le SELECT d’une table dérivée (sous-requête dans la clause FROM).
Autres notes
- Distinct : une fois que MySQL trouve une ligne qui correspond à la jointure, il ne cherche plus.
- Not exists : MySQL optimise LEFT JOIN ; une fois qu’il trouve une ligne correspondant aux critères du LEFT JOIN, il ne cherche plus.
- Range checked for each Record (index map:#) : aucun index idéal n’a été trouvé, donc pour chaque combinaison de lignes de la table précédente, MySQL vérifie quel index utiliser et l’utilise pour renvoyer des lignes de la table. C’est l’une des jointures utilisant des index les plus lentes.
- Using filesort : lorsque vous voyez cela, la requête doit être optimisée. MySQL a besoin d’une étape supplémentaire pour déterminer comment trier les lignes renvoyées. Il trie toutes les lignes en fonction du type de jointure et des pointeurs de ligne pour toutes les lignes qui stockent les valeurs de clé de tri et correspondent aux conditions.
- Using index : les données de colonne sont renvoyées depuis une table en utilisant uniquement les informations de l’index sans lire les lignes réelles. Cela se produit lorsque toutes les colonnes demandées pour la table font partie du même index.
- Using temporary : lorsque vous voyez cela, la requête doit être optimisée. Ici, MySQL doit créer une table temporaire pour stocker les résultats, ce qui se produit généralement lorsque ORDER BY porte sur un ensemble de colonnes différent de GROUP BY.
- Where used : la clause WHERE est utilisée pour restreindre les lignes qui correspondront à la table suivante ou qui seront renvoyées à l’utilisateur. Cela se produit si vous ne voulez pas renvoyer toutes les lignes de la table et que le type de jointure est ALL ou index, ou s’il y a un problème avec la requête. Explication des différents types de jointure (classés de l’efficacité la plus élevée à la plus faible).
- system : la table n’a qu’une seule ligne : table système. C’est un cas particulier du type de jointure const.
- const : Au maximum un enregistrement dans la table peut correspondre à cette requête (l'index peut être une clé primaire ou un index unique). Comme il n'y a qu'une seule ligne, cette valeur est en fait une constante, car MySQL lit d'abord cette valeur puis la traite comme une constante.
- eq_ref : Dans une jointure, MySQL lit un enregistrement de la table pour chaque combinaison d'enregistrements de la table précédente pendant la requête. Il est utilisé lorsque la requête utilise un index qui est entièrement une clé primaire ou une clé unique.
- ref : Ce type de jointure ne se produit que lorsque la requête utilise une clé qui n'est pas unique ou une clé primaire, ou une partie partielle de ces types (par exemple, en utilisant le préfixe le plus à gauche). Pour chaque combinaison de lignes de la table précédente, tous les enregistrements correspondants seront lus dans la table. Ce type dépend fortement du nombre d'enregistrements que l'index correspond ; moins il y en a, mieux c'est.
- range : Ce type de jointure utilise un index pour renvoyer des lignes dans un intervalle, par exemple lorsque vous utilisez > ou < pour rechercher des choses.
- index : Ce type de jointure effectue un balayage complet pour chaque combinaison d'enregistrements de la table précédente (mieux que ALL, car l'index est généralement plus petit que les données de la table).
- ALL : Ce type de jointure effectue un balayage complet pour chaque combinaison d'enregistrements de la table précédente. C'est généralement mauvais et doit être évité autant que possible.
Parmi ceux-ci, type :
- S'il s'agit de 'Only index', cela signifie que les informations sont récupérées en utilisant uniquement les informations de l'arbre d'index, ce qui est plus rapide que de parcourir toute la table.
- S'il s'agit de 'where used', cela signifie que la restriction WHERE est utilisée.
- S'il s'agit de 'impossible where', cela signifie que WHERE est inutile ; généralement, rien n'a été trouvé.
- Si ces informations affichent Using filesort ou Using temporary, ce sera très laborieux. Les index pour WHERE et ORDER BY ne peuvent souvent pas satisfaire les deux à la fois. Si vous déterminez l'index en fonction de WHERE, alors lors de l'exécution de ORDER BY, cela entraînera inévitablement Using filesort. Cela dépend si filtrer d'abord puis trier est plus rentable, ou trier d'abord puis filtrer est plus rentable.
Types d'index
Index UNIQUE
Les valeurs dupliquées ne sont pas autorisées, mais les valeurs NULL sont autorisées.
INDEX index normal
Le contenu d'index dupliqué est autorisé.
Index PRIMARY KEY
Les valeurs dupliquées ne sont pas autorisées, et les valeurs NULL ne sont pas non plus autorisées. Une table ne peut avoir qu'un seul index primary_key.
Index fulltext
Les trois types d'index ci-dessus agissent sur les valeurs des colonnes, mais l'index fulltext peut cibler un mot précis dans la valeur, comme un mot dans un article. Cependant, il est inutile, car seuls MyISAM et l'anglais sont pris en charge, et l'efficacité n'est pas impressionnante. Mais des applications tierces telles que Coreseek et Xunsearch peuvent être utilisées pour répondre à ce besoin.
CURD des index
Création d'index
ALTER TABLE
Convient pour un ajout après la création de la table.
`ALTER TABLE table_name ADD index_type (unique, primary key, fulltext, index) [index_name] (field_name)`
ALTER TABLE `table_name` ADD INDEX `index_name` (`column_list`) -- 索引名,可要可不要;如果不要,当前的索引名就是该字段名。
ALTER TABLE `table_name` ADD UNIQUE (`column_list`)
ALTER TABLE `table_name` ADD PRIMARY KEY (`column_list`)
ALTER TABLE `table_name` ADD FULLTEXT KEY (`column_list`)
CREATE INDEX
`CREATE INDEX` peut ajouter un index normal ou un index UNIQUE à une table.
--例:只能添加这两种索引
CREATE INDEX index_name ON table_name (column_list)
CREATE UNIQUE INDEX index_name ON table_name (column_list)
De plus, vous pouvez aussi en ajouter lors de la création de la table :
CREATE TABLE `test1` (
  `id` smallint(5) UNSIGNED AUTO_INCREMENT NOT NULL, -- 注意,下面创建了主键索引,这里就不用创建了
  `username` varchar(64) NOT NULL COMMENT '用户名',
  `nickname` varchar(50) NOT NULL COMMENT '昵称/姓名',
  `intro` text,
  PRIMARY KEY (`id`),
  UNIQUE KEY `unique1` (`username`), -- 索引名称,可要可不要,不要就是和列名一样
  KEY `index1` (`nickname`),
  FULLTEXT KEY `intro` (`intro`)
) ENGINE=MyISAM AUTO_INCREMENT=4 DEFAULT CHARSET=utf8 COMMENT='后台用户表';
Suppression d'index
DROP INDEX `index_name` ON `talbe_name`
ALTER TABLE `table_name` DROP INDEX `index_name`
-- 这两句都是等价的,都是删除掉table_name中的索引index_name;

ALTER TABLE `table_name` DROP PRIMARY KEY -- 删除主键索引,注意主键索引只能用这种方式删除
Affichage des index
show index from tablename;
Modification des index
Changer ? Pas question. Il suffit de le supprimer et d'en recréer un.
Conseils pour la création d'index
- Créez des index pour les colonnes à cardinalité élevée.
- Dans une colonne de données,le nombre de valeurs non dupliquéesapparaissant. Plus ce nombre est élevé, plus la cardinalité est élevée.
- Par exemple, si la table contient 8 lignes de données a,b,c,d,a,b,c,d, la cardinalité de cette table est de 4.
- Les index doivent être créés pour les colonnes à cardinalité élevée, telles que l'âge et le sexe ; l'âge a une cardinalité plus élevée que le sexe.
- Les colonnes comme le genre ne conviennent pas à l'indexation car la cardinalité est trop faible.
- Utilisez des index pour les colonnes qui apparaissent dans WHERE, ON, GROUP BY et ORDER BY.
- Utilisez des index sur des colonnes de données plus petites, ce qui rend le fichier d'index plus petit et permet également de charger davantage de clés d'index en mémoire.
- Utilisez des index de préfixe pour les chaînes plus longues.
- Ne créez pas trop d'index. En plus d'augmenter l'espace disque supplémentaire, cela affecte grandement la vitesse des opérations DML, car chaque insertion, suppression ou mise à jour nécessite la reconstruction de l'index.
- L'utilisation d'index composites peut réduire la taille du fichier d'index et est plus rapide à l'usage que plusieurs index à colonne unique.
Index composite et index de préfixe
Remarque : ces deux termes désignent des techniques d'indexation, et non des types d'index.
Index composite
Quelle est exactement la différence entre les index MySQL à colonne unique et les index composites ?
Pour comparer concrètement les deux, créez d'abord une table :
CREATE TABLE `myIndex` (
  `i_testID` INT NOT NULL AUTO_INCREMENT,
  `vc_Name` VARCHAR(50) NOT NULL,
  `vc_City` VARCHAR(50) NOT NULL,
  `i_Age` INT NOT NULL,
  `i_SchoolID` INT NOT NULL,
  PRIMARY KEY (`i_testID`)
);
Supposons que la table ait déjà 1000 lignes de données. Parmi ces 10,000 enregistrements, 5 enregistrements avec vc_Name="erquan" sont dispersés çà et là, mais les combinaisons de city, age et school sont toutes différentes. Jetez un coup d'œil à ce T-SQL :
SELECT `i_testID` FROM `myIndex` WHERE `vc_Name`='erquan' AND `vc_City`='郑州' AND `i_Age`=25; -- 关联搜索;
Envisagez d'abord de créer un index MySQL à colonne unique :
Un index a été créé sur la colonne vc_Name. Lors de l’exécution de T-SQL, MySQL s’est rapidement positionné sur les 5 enregistrements avec vc_Name='erquan', les a extraits et les a placés dans un ensemble de résultats intermédiaire. Dans cet ensemble de résultats, il a d’abord exclu les enregistrements dont vc_City n’était pas égal à « Zhengzhou », puis exclu les enregistrements dont i_Age n’était pas égal à 25, et a enfin filtré le seul enregistrement correspondant. Bien qu’un index ait été créé sur vc_Name, MySQL n’a pas besoin de parcourir toute la table lors des requêtes, donc l’efficacité s’est améliorée, mais cela reste encore loin de nos exigences. De même, l’efficacité des index à colonne unique créés séparément sur vc_City et i_Age est similaire.
Pour tirer davantage d’efficacité de MySQL, nous devons envisager de créer un index composite. C’est-à-dire mettre vc_Name, vc_City et i_Age dans un seul index :
ALTER TABLE `myIndex` ADD INDEX `name_city_age` (vc_Name(10),vc_City,i_Age);
Lors de la création de la table, la longueur de vc_Name est de 50. Pourquoi utiliser 10 ici ? Il s’agit de l’index de préfixe mentionné ci-dessous, car dans des circonstances normales, la longueur d’un nom ne dépassera pas 10. Cela accélère les performances de requête d’index, réduit la taille du fichier d’index et améliore la vitesse des mises à jour INSERT.
Lors de l’exécution de T-SQL, MySQL peut trouver le seul enregistrement sans parcourir aucun enregistrement !
Si des index à colonne unique sont créés séparément sur vc_Name, vc_City et i_Age, ce qui donne à la table 3 index à colonne unique, l’efficacité des requêtes sera-t-elle la même que celle de l’index composite ci-dessus ? La réponse est complètement différente, bien inférieure à notre index composite. Bien qu’il y ait maintenant trois index, MySQL ne peut utiliser que celui qu’il considère comme l’index à colonne unique le plus efficace ; les deux autres ne peuvent pas être utilisés. Autrement dit, il s’agit toujours d’un processus de parcours complet de la table.
Créer un tel index composite équivaut en fait à créer séparément :
- vc_Name,vc_City,i_Age
- vc_Name,vc_City
- vc_Name
Ces trois index composites ! Pourquoi n'y a-t-il pas d'index composite comme vc_City, i_Age ? C'est à cause du résultat du « préfixe le plus à gauche » des index composites MySQL. Une compréhension simple est que la combinaison ne commence qu'à partir du côté le plus à gauche. Les requêtes qui incluent ces trois colonnes n'utiliseront pas toutes l'index composite. Les instructions T-SQL suivantes l'utiliseront :
SELECT * FROM myIndex WHREE vc_Name=”erquan” AND vc_City=”郑州” SELECT * FROM myIndex WHREE vc_Name=”erquan”
Mais les suivantes ne l'utiliseront pas :
SELECT * FROM myIndex WHREE i_Age=20 AND vc_City=”郑州” SELECT * FROM myIndex WHREE vc_City=”郑州”
C'est-à-dire que name_city_age(vc_Name(10), vc_City, i_Age) effectue une indexation de gauche à droite. S'il n'y a pas d'index de préfixe gauche, MySQL n'exécute pas de requête d'index.
Index de préfixe
Si la colonne indexée est trop longue, indexer une telle colonne produira un fichier d'index très volumineux et sera peu pratique à exploiter. Vous pouvez utiliser la méthode de l'index de préfixe. L'index de préfixe doit être contrôlé à un point approprié, autour de la valeur d'or de 0.31 (si elle est supérieure à cette valeur, vous pouvez le créer).
SELECT COUNT(DISTINCT(LEFT(`title`,10)))/COUNT(*) FROM Arctic; — Si cette valeur est supérieure à 0.31, vous pouvez créer un index de préfixe. DISTINCT supprime les doublons. ALTER TABLE `user` ADD INDEX `uname`(title(10)); — Ajouter une instruction SQL d'index de préfixe, en définissant l'index pour le nom sur les 10 premiers caractères. Cela réduit la taille du fichier d'index et accélère les requêtes d'index.
Quel type de SQL n'utilise pas d'index
Essayez d'éviter ces instructions SQL qui n'utilisent pas d'index.
SELECT `sname` FROM `stu` WHERE `age`+10=30;-- 不会使用索引,因为所有索引列参与了计算

SELECT `sname` FROM `stu` WHERE LEFT(`date`,4) <1990; -- 不会使用索引,因为使用了函数运算,原理与上面相同

SELECT * FROM `houdunwang` WHERE `uname` LIKE'后盾%' -- 走索引

SELECT * FROM `houdunwang` WHERE `uname` LIKE "%后盾%" -- 不走索引

-- 正则表达式不使用索引,这应该很好理解,所以为什么在SQL中很难看到regexp关键字的原因

-- 字符串与数字比较不使用索引;
CREATE TABLE `a` (`a` char(10));
EXPLAIN SELECT * FROM `a` WHERE `a`="1" -- 走索引
EXPLAIN SELECT * FROM `a` WHERE `a`=1 -- 不走索引

select * from dept where dname='xxx' or loc='xx' or deptno=45 --如果条件中有or,即使其中有条件带索引也不会使用。换言之,就是要求使用的所有字段,都必须建立索引,我们建议大家尽量避免使用or 关键字

-- 如果mysql估计使用全表扫描要比使用索引快,则不使用索引
Efficacité des index dans les jointures multi-tables
- SELECT `sname` FROM `stu` WHERE LEFT(`date`,4) < 1990; — Cela n'utilisera pas l'index car une opération de fonction est utilisée ; le principe est le même que ci-dessus.
- SELECT * FROM `houdunwang` WHERE `uname` LIKE 'after盾%' — utilise l'index
- SELECT * FROM `houdunwang` WHERE `uname` LIKE '%after盾%' — n'utilise pas l'index
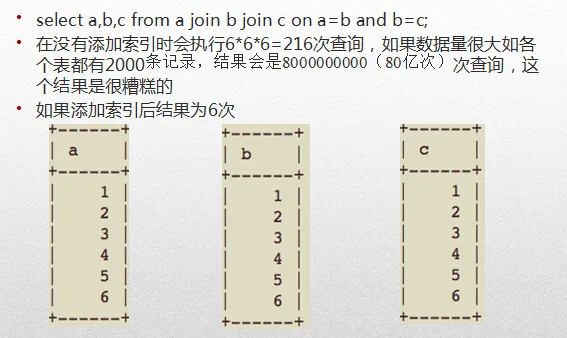
D'après la figure ci-dessus, nous pouvons voir que le type de toutes les tables est « all », ce qui indique un balayage complet de table. C'est-à-dire, 6 6 6, pour un total de 216 requêtes de parcours.
À l'exception de la première table, qui fait l'objet d'un balayage complet de table (nécessaire, car elle sert à associer les autres tables), les autres sont « range » (obtenues via une plage d'index), c'est-à-dire 6+1+1+1, pour un total de 9 requêtes de parcours.
Par conséquent, nous suggérons de joindre aussi peu de tables que possible dans les jointures multi-tables, car si vous n'êtes pas prudent, cela devient un effrayant balayage de produit cartésien. De plus, nous suggérons également d'utiliser LEFT JOIN autant que possible, en associant de la plus petite table vers la plus grande. Car lors de l'utilisation de JOIN, la première table doit être entièrement balayée, et utiliser la plus petite table pour piloter la plus grande peut réduire ce nombre de balayages.
Inconvénients des index
Ne créez pas d'index à l'aveugle. Ne créez des index que sur les colonnes fréquemment utilisées dans les opérations de requête. Créer un index rend les opérations de requête plus rapides, mais ralentit les opérations d'insertion, de suppression et de mise à jour, car l'exécution de ces opérations nécessite également un re-tri ou une mise à jour du fichier d'index.
Cependant, dans les applications Internet, les instructions de requête sont bien plus nombreuses que les instructions DML, représentant même 80% à 90%. Ne vous en préoccupez donc pas trop. Lors de l'importation de grandes quantités de données, vous pouvez d'abord supprimer l'index, puis insérer les données par lots, et enfin ajouter à nouveau l'index.