Так называемый индекс — это выполнение некоторой специфической алгоритмической сортировки для конкретных полей MySQL, например алгоритма бинарного дерева и хеш-алгоритма. Хеш-алгоритм создаёт значения признаков и затем быстро находит по этим значениям. Наиболее используемым и заданным в MySQL по умолчанию является алгоритм бинарного дерева BTREE. Для полей, индексируемых с помощью алгоритма BTREE, например, сканирование 20 строк может дать результаты, для получения которых без BTREE потребовалось бы просканировать 2^20 строк.
Диагностика оптимизации запросов с помощью EXPLAIN
EXPLAIN может помочь разработчикам анализировать проблемы SQL. EXPLAIN показывает, как MySQL использует индексы для обработки операторов SELECT и соединения таблиц, и может помочь выбрать лучшие индексы и писать более оптимизированные запросы.
Использование: просто добавьте EXPLAIN перед оператором SELECT:
Explain select * from blog where false;
Перед выполнением запроса MySQL анализирует каждый отправленный SQL-оператор, чтобы решить, использовать индекс или выполнить полное сканирование таблицы. Если вы отправите `select * from blog where false`, MySQL не выполнит запрос, потому что после анализа SQL-анализатором MySQL уже знает, что ни одна строка не будет соответствовать условию.
Пример
mysql> EXPLAIN SELECT `birday` FROM `user` WHERE `birthday` < "1990/2/2";
-- 结果:
id: 1

select_type: SIMPLE -- 查询类型(简单查询、联合查询、子查询)

table: user -- 显示这一行的数据是关于哪张表的 。

type: range -- 区间索引(在小于1990/2/2区间的数据),这是重要的列,显示连接使用了何种类型。从最好到最差的连接类型为system > const > eq_ref > ref > fulltext > ref_or_null > index_merge > unique_subquery > index_subquery > range > index > ALL,const代表一次就命中,ALL代表扫描了全表才确定结果。一般来说,得保证查询至少达到range级别,最好能达到ref.

possible_keys: birthday  -- 指出MySQL能使用哪个索引在该表中找到行。如果是空的,没有相关的索引。这时要提高性能,可通过检验WHERE子句,看是否引用某些字段,或者检查字段不是适合索引。

key: birthday -- 实际使用到的索引。如果为NULL,则没有使用索引。如果为primary的话,表示使用了主键。

key_len: 4 -- 最长的索引宽度。如果键是NULL,长度就是NULL。在不损失精确性的情况下,长度越短越好。

ref: const -- 显示哪个字段或常数与key一起被使用。

rows: 1 -- 这个数表示mysql要遍历多少数据才能找到,在innodb上是不准确的。

Extra: Using where; Using index -- 执行状态说明,这里可以看到的坏的例子是Using temporary和Using
select_type
- simple: простой SELECT (не использует UNION или подзапросы).
- primary: самый внешний SELECT.
- union: второй или последующий оператор SELECT в UNION.
- dependent union: второй или последующий оператор SELECT в UNION, зависимый от внешнего запроса.
- union result: результат UNION.
- subquery: первый SELECT в подзапросе.
- dependent subquery: первый SELECT в подзапросе, зависящем от внешнего запроса.
- derived: SELECT производной таблицы (подзапрос в предложении FROM).
Прочие примечания
- Distinct: Как только MySQL находит строку, соответствующую соединению, он больше не ищет.
- Not exists: MySQL оптимизирует LEFT JOIN; как только он находит строку, соответствующую критериям LEFT JOIN, он больше не ищет.
- Range checked for each Record (index map:#): Идеальный индекс не найден, поэтому для каждой комбинации строк из предыдущей таблицы MySQL проверяет, какой индекс использовать, и использует его для возврата строк из таблицы. Это одно из самых медленных соединений с использованием индексов.
- Using filesort: Если вы видите это, запрос нуждается в оптимизации. MySQL нужен дополнительный шаг, чтобы определить, как сортировать возвращённые строки. Он сортирует все строки на основе типа соединения и указателей строк для всех строк, которые хранят значения ключа сортировки и соответствуют условиям.
- Using index: Данные столбца возвращаются из таблицы с использованием только информации в индексе, без чтения фактических строк. Это происходит, когда все запрошенные столбцы таблицы являются частью одного и того же индекса.
- Using temporary: Если вы видите это, запрос нуждается в оптимизации. Здесь MySQL нужно создать временную таблицу для хранения результатов; обычно это происходит, когда ORDER BY применяется к другому набору столбцов, чем GROUP BY.
- Where used: Предложение WHERE используется, чтобы ограничить, какие строки будут соответствовать следующей таблице или будут возвращены пользователю. Это происходит, если вы не хотите возвращать все строки из таблицы, а тип соединения — ALL или index, либо есть проблема с запросом. Объяснение различных типов соединения (упорядочены от высокой к низкой эффективности).
- system: Таблица содержит только одну строку: системная таблица. Это особый случай типа соединения const.
- const: С этой выборкой в таблице может совпасть не более одной записи (индекс может быть первичным или уникальным). Поскольку строка только одна, это значение фактически является константой, так как MySQL сначала считывает это значение, а затем обращается с ним как с константой.
- eq_ref: В соединении MySQL считывает одну запись из таблицы для каждой комбинации записей из предыдущей таблицы во время запроса. Используется, когда запрос использует индекс, который полностью является первичным ключом или уникальным ключом.
- ref: Этот тип соединения возникает только когда запрос использует ключ, который не является уникальным или первичным ключом, либо частичную часть таких типов (например, используя самый левый префикс). Для каждой комбинации строк из предыдущей таблицы из таблицы будут прочитаны все совпадающие записи. Этот тип сильно зависит от того, скольким записям соответствует индекс; чем меньше, тем лучше.
- range: Этот тип соединения использует индекс для возврата строк в диапазоне, например при использовании > или < для поиска.
- index: Этот тип соединения выполняет полное сканирование для каждой комбинации записей из предыдущей таблицы (лучше, чем ALL, потому что индекс обычно меньше данных таблицы).
- ALL: Этот тип соединения выполняет полное сканирование для каждой комбинации записей из предыдущей таблицы. Обычно это плохо, и этого следует по возможности избегать.
Среди них type:
- Если это 'Only index', это означает, что информация извлекается только с использованием информации в дереве индекса, что быстрее, чем сканирование всей таблицы.
- Если это 'where used', это означает, что используется ограничение WHERE.
- Если это 'impossible where', это означает, что WHERE не нужен; обычно ничего не найдено.
- Если в этой информации отображается Using filesort или Using temporary, это будет очень тяжело. Индексы для WHERE и ORDER BY часто не могут быть удовлетворены одновременно. Если вы определяете индекс на основе WHERE, то при выполнении ORDER BY это неизбежно вызовет Using filesort. Это зависит от того, что более выгодно: сначала фильтровать, а затем сортировать, или сначала сортировать, а затем фильтровать.
Типы индексов
Индекс UNIQUE
Дублирующиеся значения не допускаются, но значения NULL допускаются.
INDEX обычный индекс
Дублирование содержимого индекса допускается.
Индекс PRIMARY KEY
Дублирующиеся значения не допускаются, и значения NULL также не допускаются. Таблица может иметь только один индекс primary_key.
Индекс fulltext
Три вышеуказанных типа индексов работают со значениями столбцов, но индекс fulltext может нацеливаться на определённое слово в значении, например, слово в статье. Однако он бесполезен, потому что поддерживаются только MyISAM и английский язык, а эффективность не впечатляет. Но для выполнения этого требования можно использовать сторонние приложения, такие как Coreseek и Xunsearch.
CURD индексов
Создание индексов
ALTER TABLE
Подходит для добавления после создания таблицы.
`ALTER TABLE table_name ADD index_type (unique, primary key, fulltext, index) [index_name] (field_name)`
ALTER TABLE `table_name` ADD INDEX `index_name` (`column_list`) -- 索引名,可要可不要;如果不要,当前的索引名就是该字段名。
ALTER TABLE `table_name` ADD UNIQUE (`column_list`)
ALTER TABLE `table_name` ADD PRIMARY KEY (`column_list`)
ALTER TABLE `table_name` ADD FULLTEXT KEY (`column_list`)
CREATE INDEX
`CREATE INDEX` может добавить к таблице обычный индекс или UNIQUE-индекс.
--例:只能添加这两种索引
CREATE INDEX index_name ON table_name (column_list)
CREATE UNIQUE INDEX index_name ON table_name (column_list)
Кроме того, можно также добавить при создании таблицы:
CREATE TABLE `test1` (
  `id` smallint(5) UNSIGNED AUTO_INCREMENT NOT NULL, -- 注意,下面创建了主键索引,这里就不用创建了
  `username` varchar(64) NOT NULL COMMENT '用户名',
  `nickname` varchar(50) NOT NULL COMMENT '昵称/姓名',
  `intro` text,
  PRIMARY KEY (`id`),
  UNIQUE KEY `unique1` (`username`), -- 索引名称,可要可不要,不要就是和列名一样
  KEY `index1` (`nickname`),
  FULLTEXT KEY `intro` (`intro`)
) ENGINE=MyISAM AUTO_INCREMENT=4 DEFAULT CHARSET=utf8 COMMENT='后台用户表';
Удаление индексов
DROP INDEX `index_name` ON `talbe_name`
ALTER TABLE `table_name` DROP INDEX `index_name`
-- 这两句都是等价的,都是删除掉table_name中的索引index_name;

ALTER TABLE `table_name` DROP PRIMARY KEY -- 删除主键索引,注意主键索引只能用这种方式删除
Просмотр индексов
show index from tablename;
Изменение индексов
Изменить? Не получится. Просто удалите его и создайте заново.
Советы по созданию индексов
- Создавайте индексы для столбцов с высокой кардинальностью.
- В столбце данных,количество неповторяющихся значений,которые встречаются. Чем выше это число, тем выше кардинальность.
- Например, если в таблице есть 8 строк данных a,b,c,d,a,b,c,d, то кардинальность этой таблицы равна 4.
- Индексы следует создавать для столбцов с высокой кардинальностью, таких как возраст и пол; возраст имеет более высокую кардинальность, чем пол.
- Столбцы вроде gender не подходят для индексирования, потому что кардинальность слишком низкая.
- Используйте индексы для столбцов, которые встречаются в WHERE, ON, GROUP BY и ORDER BY.
- Используйте индексы по столбцам с меньшим объёмом данных: это делает файл индекса меньше и позволяет загрузить в память больше ключей индекса.
- Используйте префиксные индексы для более длинных строк.
- Не создавайте слишком много индексов. Помимо дополнительного расхода дискового пространства, это сильно влияет на скорость операций DML, потому что каждая вставка, удаление или обновление требует перестроения индекса.
- Использование составных индексов может уменьшить размер файла индекса, и при использовании они быстрее нескольких одноколоночных индексов.
Составной индекс и префиксный индекс
Примечание: эти два термина — названия приёмов индексирования, а не типов индексов.
Составной индекс
В чём именно разница между одноколоночными индексами MySQL и составными индексами?
Чтобы наглядно сравнить оба, сначала создайте таблицу:
CREATE TABLE `myIndex` (
  `i_testID` INT NOT NULL AUTO_INCREMENT,
  `vc_Name` VARCHAR(50) NOT NULL,
  `vc_City` VARCHAR(50) NOT NULL,
  `i_Age` INT NOT NULL,
  `i_SchoolID` INT NOT NULL,
  PRIMARY KEY (`i_testID`)
);
Предположим, в таблице уже есть 1000 строк данных. Среди этих 10,000 записей 5 записей с vc_Name="erquan" разбросаны тут и там, но комбинации city, age и school у каждой разные. Взгляните на этот T-SQL:
SELECT `i_testID` FROM `myIndex` WHERE `vc_Name`='erquan' AND `vc_City`='郑州' AND `i_Age`=25; -- 关联搜索;
Сначала рассмотрим создание одноколоночного индекса MySQL:
Индекс был создан для столбца vc_Name. При выполнении T-SQL MySQL быстро нашёл 5 записей с vc_Name='erquan', извлёк их и поместил в промежуточный результирующий набор. В этом результирующем наборе он сначала исключил записи, в которых vc_City не равно "Zhengzhou", затем исключил записи, в которых i_Age не равно 25, и наконец выбрал единственную подходящую запись. Хотя индекс был создан для vc_Name, MySQL не нужно сканировать всю таблицу во время запросов, поэтому эффективность повысилась, но она всё ещё несколько далека от наших требований. Аналогично, эффективность одностолбцовых индексов, созданных отдельно для vc_City и i_Age, примерно такая же.
Чтобы выжать из MySQL ещё больше эффективности, нужно рассмотреть создание составного индекса. То есть поместить vc_Name, vc_City и i_Age в один индекс:
ALTER TABLE `myIndex` ADD INDEX `name_city_age` (vc_Name(10),vc_City,i_Age);
При создании таблицы длина vc_Name равна 50. Почему здесь используется 10? Это упомянутый ниже префиксный индекс, потому что в обычных условиях длина имени не превышает 10. Это ускоряет выполнение индексных запросов, уменьшает размер индексного файла и повышает скорость обновлений INSERT.
При выполнении T-SQL MySQL может найти единственную запись, не сканируя ни одной записи!
Если одностолбцовые индексы созданы по отдельности для vc_Name, vc_City и i_Age, что даёт таблице 3 одностолбцовых индекса, будет ли эффективность запроса такой же, как у составного индекса выше? Ответ совсем другой — она намного ниже, чем у нашего составного индекса. Хотя теперь есть три индекса, MySQL может использовать только тот одностолбцовый индекс, который считает наиболее эффективным; два других использованы быть не могут. Иными словами, это по-прежнему процесс полного сканирования таблицы.
Создание такого составного индекса фактически эквивалентно отдельному созданию:
- vc_Name,vc_City,i_Age
- vc_Name,vc_City
- vc_Name
Эти три составных индекса! Почему нет составного индекса вроде vc_City, i_Age? Это объясняется действием «левостороннего префикса» составных индексов MySQL. Простое понимание: комбинация начинается только с самой левой стороны. Не каждый запрос, включающий эти три столбца, будет использовать составной индекс. Следующие T-SQL-инструкции будут его использовать:
SELECT * FROM myIndex WHREE vc_Name=”erquan” AND vc_City=”郑州” SELECT * FROM myIndex WHREE vc_Name=”erquan”
Но следующие не будут его использовать:
SELECT * FROM myIndex WHREE i_Age=20 AND vc_City=”郑州” SELECT * FROM myIndex WHREE vc_City=”郑州”
То есть name_city_age(vc_Name(10), vc_City, i_Age) выполняет индексацию слева направо. Если нет индекса по левому префиксу, MySQL не выполняет запрос по индексу.
Префиксный индекс
Если индексируемый столбец слишком длинный, индексация такого столбца создаст очень большой индексный файл, и с ним неудобно работать. Можно использовать метод префиксного индекса. Префиксный индекс следует задавать на подходящем уровне, около золотого значения 0.31 (если больше этого значения, его можно создавать).
SELECT COUNT(DISTINCT(LEFT(`title`,10)))/COUNT(*) FROM Arctic; — Если это значение больше 0.31, можно создать префиксный индекс. DISTINCT удаляет дубликаты. ALTER TABLE `user` ADD INDEX `uname`(title(10)); — SQL добавления префиксного индекса, устанавливая индекс для имени по первым 10 символам. Это уменьшает размер индексного файла и ускоряет индексные запросы.
Какой SQL не использует индексы
Старайтесь избегать этих SQL-инструкций, которые не используют индексы.
SELECT `sname` FROM `stu` WHERE `age`+10=30;-- 不会使用索引,因为所有索引列参与了计算

SELECT `sname` FROM `stu` WHERE LEFT(`date`,4) <1990; -- 不会使用索引,因为使用了函数运算,原理与上面相同

SELECT * FROM `houdunwang` WHERE `uname` LIKE'后盾%' -- 走索引

SELECT * FROM `houdunwang` WHERE `uname` LIKE "%后盾%" -- 不走索引

-- 正则表达式不使用索引,这应该很好理解,所以为什么在SQL中很难看到regexp关键字的原因

-- 字符串与数字比较不使用索引;
CREATE TABLE `a` (`a` char(10));
EXPLAIN SELECT * FROM `a` WHERE `a`="1" -- 走索引
EXPLAIN SELECT * FROM `a` WHERE `a`=1 -- 不走索引

select * from dept where dname='xxx' or loc='xx' or deptno=45 --如果条件中有or,即使其中有条件带索引也不会使用。换言之,就是要求使用的所有字段,都必须建立索引,我们建议大家尽量避免使用or 关键字

-- 如果mysql估计使用全表扫描要比使用索引快,则不使用索引
Эффективность индексов при соединении нескольких таблиц
- SELECT `sname` FROM `stu` WHERE LEFT(`date`,4) < 1990; — Здесь индекс не будет использоваться, потому что применяется функция; принцип тот же, что и выше.
- SELECT * FROM `houdunwang` WHERE `uname` LIKE 'after盾%' — использует индекс
- SELECT * FROM `houdunwang` WHERE `uname` LIKE '%after盾%' — не использует индекс
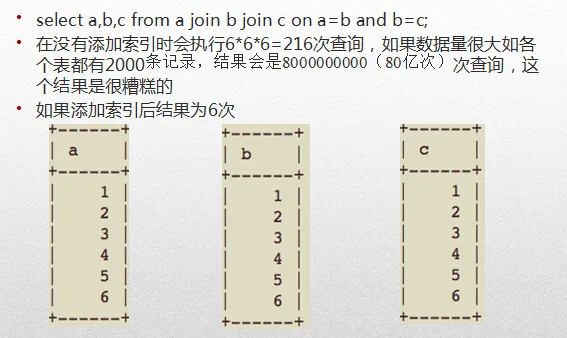
Из приведённого выше рисунка видно, что тип всех таблиц — "all", что указывает на полное сканирование таблицы. То есть 6 6 6, всего 216 обходных запросов.
За исключением первой таблицы, для которой выполняется полное сканирование таблицы (это необходимо, поскольку она используется для связи с другими таблицами), остальные имеют тип "range" (получены через диапазон индекса), то есть 6+1+1+1, всего 9 обходных запросов.
Поэтому мы рекомендуем объединять как можно меньше таблиц при многотабличных соединениях, потому что если не быть осторожным, это превращается в пугающее сканирование декартова произведения. Кроме того, мы также рекомендуем по возможности использовать LEFT JOIN, связывая из меньшей таблицы с большей. Потому что при использовании JOIN первая таблица должна быть полностью просканирована, а использование меньшей таблицы в качестве ведущей для большей позволяет сократить количество сканирований.
Недостатки индексов
Не создавайте индексы вслепую. Создавайте индексы только для столбцов, которые часто используются в операциях запроса. Создание индекса ускоряет операции запроса, но замедляет операции вставки, удаления и обновления, потому что выполнение этих операций также требует повторной сортировки или обновления файла индекса.
Однако в интернет-приложениях запросы по количеству значительно превосходят DML-операторы, занимая даже 80%–90%. Так что не стоит слишком беспокоиться об этом. При импорте больших объёмов данных можно сначала удалить индекс, затем пакетно вставить данные и наконец снова добавить индекс.