El llamado índice consiste en aplicar ciertos algoritmos de ordenamiento específicos a campos concretos de MySQL, como el algoritmo de árbol binario y el algoritmo hash. El algoritmo hash crea valores característicos y luego busca rápidamente según esos valores. Pero el más utilizado, y el predeterminado en MySQL, es el algoritmo de árbol binario BTREE. Con un campo indexado mediante el algoritmo BTREE, por ejemplo, escaneando 20 filas se obtiene el resultado que sin usar BTREE requeriría escanear 2^20 filas.
Explain: detección y optimización de consultas
EXPLAIN ayuda a los desarrolladores a analizar problemas de SQL. explain muestra cómo MySQL utiliza los índices para procesar sentencias SELECT y tablas de unión, lo que ayuda a elegir mejores índices y a escribir consultas más optimizadas.
Método de uso: basta con anteponer EXPLAIN a la sentencia SELECT:
Explain select * from blog where false;
Antes de ejecutar una consulta, MySQL analiza cada sentencia SQL enviada y decide si usar un índice o un escaneo completo de la tabla. Si se envía un `select * from blog where false`, MySQL no ejecutará la consulta, porque tras el análisis del analizador SQL, MySQL ya sabe que ninguna fila cumplirá la condición.
Ejemplo
mysql> EXPLAIN SELECT `birday` FROM `user` WHERE `birthday` < "1990/2/2";
-- 结果:
id: 1

select_type: SIMPLE -- 查询类型(简单查询、联合查询、子查询)

table: user -- 显示这一行的数据是关于哪张表的 。

type: range -- 区间索引(在小于1990/2/2区间的数据),这是重要的列,显示连接使用了何种类型。从最好到最差的连接类型为system > const > eq_ref > ref > fulltext > ref_or_null > index_merge > unique_subquery > index_subquery > range > index > ALL,const代表一次就命中,ALL代表扫描了全表才确定结果。一般来说,得保证查询至少达到range级别,最好能达到ref.

possible_keys: birthday  -- 指出MySQL能使用哪个索引在该表中找到行。如果是空的,没有相关的索引。这时要提高性能,可通过检验WHERE子句,看是否引用某些字段,或者检查字段不是适合索引。

key: birthday -- 实际使用到的索引。如果为NULL,则没有使用索引。如果为primary的话,表示使用了主键。

key_len: 4 -- 最长的索引宽度。如果键是NULL,长度就是NULL。在不损失精确性的情况下,长度越短越好。

ref: const -- 显示哪个字段或常数与key一起被使用。

rows: 1 -- 这个数表示mysql要遍历多少数据才能找到,在innodb上是不准确的。

Extra: Using where; Using index -- 执行状态说明,这里可以看到的坏的例子是Using temporary和Using
select_type
- simple: SELECT simple (sin usar UNION ni subconsultas).
- primary: el SELECT más externo.
- union: la segunda sentencia SELECT o las siguientes en una UNION.
- dependent union: la segunda sentencia SELECT o las siguientes en una UNION, que dependen de la consulta externa.
- union result: el resultado de la UNION.
- subquery: el primer SELECT de una subconsulta.
- dependent subquery: el primer SELECT de una subconsulta, que depende de la consulta externa.
- derived: el SELECT de la tabla derivada (subconsulta en la cláusula FROM).
Otras explicaciones
- Distinct: una vez que MYSQL encuentra las filas que coinciden con la unión, deja de buscar.
- Not exists: MYSQL optimiza LEFT JOIN; una vez que encuentra una fila que cumple el estándar de LEFT JOIN, deja de buscar.
- Range checked for each Record (index map:#): no se encontró el índice ideal, por lo tanto, para cada combinación de filas de la tabla anterior, MYSQL comprueba qué índice usar y lo utiliza para devolver filas de la tabla. Esta es una de las uniones más lentas que usan índices.
- Using filesort: al ver esto, la consulta necesita optimización. MYSQL necesita un paso adicional para descubrir cómo ordenar las filas devueltas. Ordena todas las filas según el tipo de unión y los punteros a las filas que almacenan los valores de las claves de ordenación y todas las filas que coinciden con la condición.
- Using index: los datos de las columnas se devuelven de la tabla usando únicamente la información del índice sin leer las filas reales. Esto ocurre cuando todas las columnas solicitadas de la tabla son parte del mismo índice.
- Using temporary: al ver esto, la consulta necesita optimización. Aquí, MYSQL necesita crear una tabla temporal para almacenar el resultado. Esto suele ocurrir al hacer ORDER BY sobre conjuntos de columnas diferentes, en lugar de GROUP BY.
- Where used: se utiliza la cláusula WHERE para limitar qué filas coincidirán con la siguiente tabla o se devolverán al usuario. Esto ocurre si no se desea devolver todas las filas de la tabla y el tipo de unión es ALL o index, o si hay un problema con la consulta. Explicación de los diferentes tipos de unión (ordenados de mayor a menor eficiencia).
- system: la tabla tiene solo una fila: tabla system. Es un caso especial del tipo de unión const.
- const: el valor máximo de un registro en la tabla puede coincidir con esta consulta (el índice puede ser una clave primaria o un índice único). Como solo hay una fila, este valor es en realidad una constante, porque MYSQL primero lee este valor y luego lo trata como una constante.
- eq_ref: en la unión, al realizar la consulta, MYSQL lee desde la tabla anterior un registro por cada combinación de registros, y se usa cuando la consulta utiliza como índice una clave primaria o una clave única en su totalidad.
- ref: este tipo de unión ocurre solo cuando la consulta usa una clave que no es única ni primaria, o una parte de estos tipos (por ejemplo, utilizando el prefijo más a la izquierda). Para cada combinación de filas de la tabla anterior, se leerán todos los registros de la tabla. Este tipo depende en gran medida de cuántos registros coinciden con el índice; cuantos menos, mejor.
- range: este tipo de unión utiliza el índice para devolver filas dentro de un rango, como cuando se usa > o < para buscar algo.
- index: este tipo de unión realiza un escaneo completo para cada combinación de registros de la tabla anterior (mejor que ALL, porque el índice generalmente es más pequeño que los datos de la tabla).
- ALL: este tipo de unión realiza un escaneo completo para cada combinación de registros de la tabla anterior. Generalmente es bastante malo y se debe evitar en lo posible.
Donde type:
- Si es "Only index", significa que la información se recupera únicamente con la información del árbol de índice, lo cual es más rápido que escanear toda la tabla.
- Si es "where used", significa que se ha utilizado la restricción WHERE.
- Si es "impossible where", indica que no es necesario usar WHERE; generalmente significa que no se encontró nada.
- Si esta información muestra "Using filesort" o "Using temporary", será muy costoso. Los índices de WHERE y ORDER BY a menudo no pueden cubrirse ambos. Si se determina el índice según WHERE, entonces al hacer ORDER BY inevitablemente se producirá "Using filesort". Hay que evaluar si es más conveniente filtrar primero y luego ordenar, u ordenar primero y luego filtrar.
Tipos de índices
Índice único UNIQUE
No pueden aparecer valores duplicados, pero puede tener valores NULL.
Índice normal INDEX
Permite que aparezcan contenidos de índice duplicados.
Índice de clave primaria PRIMARY KEY
No permite valores duplicados ni valores NULL. Una tabla solo puede tener un índice primary_key.
Índice de texto completo fulltext index
Los tres tipos de índices anteriores actúan sobre los valores de las columnas, pero el índice de texto completo puede actuar sobre una palabra dentro del valor, como una palabra en un artículo. Sin embargo, no sirve de mucho, porque solo MyISAM y el inglés lo admiten, y su eficiencia deja mucho que desear. Pero se pueden usar aplicaciones de terceros como coreseek y xunsearch para cubrir esta necesidad.
CURD de índices
Creación de índices
ALTER TABLE
Apto para agregar después de que la tabla esté creada.
`ALTER TABLE nombre_tabla ADD tipo_indice (unique, primary key, fulltext, index) [nombre_indice] (nombre_campo)`
ALTER TABLE `table_name` ADD INDEX `index_name` (`column_list`) -- 索引名,可要可不要;如果不要,当前的索引名就是该字段名。
ALTER TABLE `table_name` ADD UNIQUE (`column_list`)
ALTER TABLE `table_name` ADD PRIMARY KEY (`column_list`)
ALTER TABLE `table_name` ADD FULLTEXT KEY (`column_list`)
CREATE INDEX
CREATE INDEX puede agregar un índice normal o un índice UNIQUE a una tabla.
--例:只能添加这两种索引
CREATE INDEX index_name ON table_name (column_list)
CREATE UNIQUE INDEX index_name ON table_name (column_list)
Además, también se puede agregar al crear la tabla:
CREATE TABLE `test1` (
  `id` smallint(5) UNSIGNED AUTO_INCREMENT NOT NULL, -- 注意,下面创建了主键索引,这里就不用创建了
  `username` varchar(64) NOT NULL COMMENT '用户名',
  `nickname` varchar(50) NOT NULL COMMENT '昵称/姓名',
  `intro` text,
  PRIMARY KEY (`id`),
  UNIQUE KEY `unique1` (`username`), -- 索引名称,可要可不要,不要就是和列名一样
  KEY `index1` (`nickname`),
  FULLTEXT KEY `intro` (`intro`)
) ENGINE=MyISAM AUTO_INCREMENT=4 DEFAULT CHARSET=utf8 COMMENT='后台用户表';
Eliminación de índices
DROP INDEX `index_name` ON `talbe_name`
ALTER TABLE `table_name` DROP INDEX `index_name`
-- 这两句都是等价的,都是删除掉table_name中的索引index_name;

ALTER TABLE `table_name` DROP PRIMARY KEY -- 删除主键索引,注意主键索引只能用这种方式删除
Visualización de índices
show index from tablename;
Modificación de índices
¿Modificar? Ni de broma. Elimínalo y vuelve a crear uno.
Consejos para crear índices
- Crear índices en columnas con alta cardinalidad.
- En las columnas de datos,los valores no duplicadosel número de apariciones; cuanto mayor sea este número, mayor será la cardinalidad.
- Por ejemplo, si en la tabla de datos hay 8 filas: a, b, c, d, a, b, c, d, la cardinalidad de esta tabla es 4.
- Se deben crear índices para columnas con cardinalidad alta, como sexo y edad; la cardinalidad de la edad es mayor que la del sexo.
- Columnas como sexo no son adecuadas para crear índices porque su cardinalidad es demasiado baja.
- Usar índices en las columnas que aparecen en WHERE, ON, GROUP BY, ORDER BY.
- Usar índices en columnas de datos más pequeñas, así el archivo de índice será más pequeño y también se podrán cargar más claves de índice en memoria.
- Usar índices de prefijo para cadenas largas.
- No crear demasiados índices. Además de ocupar espacio adicional en disco, afecta en gran medida la velocidad de las operaciones DML, porque cada vez que se inserta, elimina o modifica, hay que reconstruir el índice.
- Usar índices compuestos puede reducir el tamaño del archivo de índice y, al usarlos, la velocidad es mejor que con varios índices de una sola columna.
Índices compuestos e índices de prefijo
Nota: estos dos nombres son una forma de referirse a técnicas de creación de índices, no son tipos de índices.
Índice compuesto
¿Cuál es realmente la diferencia entre un índice de una sola columna y un índice compuesto en MySQL?
Para compararlos de forma ilustrativa, primero creamos una tabla:
CREATE TABLE `myIndex` (
  `i_testID` INT NOT NULL AUTO_INCREMENT,
  `vc_Name` VARCHAR(50) NOT NULL,
  `vc_City` VARCHAR(50) NOT NULL,
  `i_Age` INT NOT NULL,
  `i_SchoolID` INT NOT NULL,
  PRIMARY KEY (`i_testID`)
);
Supongamos que la tabla ya tiene 1000 registros. Entre estos 10000 registros, hay 5 registros con vc_Name=”erquan” distribuidos de forma irregular, solo que las combinaciones de city, age, school son diferentes. Veamos esta T-SQL:
SELECT `i_testID` FROM `myIndex` WHERE `vc_Name`='erquan' AND `vc_City`='郑州' AND `i_Age`=25; -- 关联搜索;
Primero consideremos crear un índice de una sola columna en MySQL:
Se creó un índice en la columna vc_Name. Al ejecutar T-SQL, MySQL rápidamente localizó los 5 registros con vc_Name=erquan, los tomó y los colocó en un conjunto de resultados intermedio. En este conjunto de resultados, primero excluyó los registros cuyo vc_City no era “Zhengzhou”, luego excluyó los registros cuyo i_Age no era 25, y finalmente filtró el único registro que cumplía las condiciones. Aunque se creó un índice en vc_Name, MySQL no necesita escanear toda la tabla durante la consulta, la eficiencia ha mejorado, pero aún está lejos de nuestros requisitos. De manera similar, la eficiencia de los índices de una sola columna creados por separado en vc_City e i_Age es similar.
Para exprimir aún más la eficiencia de MySQL, hay que considerar la creación de un índice compuesto. Es decir, poner vc_Name, vc_City e i_Age en un solo índice:
ALTER TABLE `myIndex` ADD INDEX `name_city_age` (vc_Name(10),vc_City,i_Age);
Al crear la tabla, la longitud de vc_Name es 50. ¿Por qué usar 10 aquí? Esto es el índice de prefijo que se mencionará más adelante, porque en circunstancias normales la longitud del nombre no supera 10, lo que acelera la velocidad de consulta del índice, reduce el tamaño del archivo de índice y mejora la velocidad de actualización de INSERT.
Al ejecutar T-SQL, ¡MySQL encuentra el único registro sin tener que escanear ningún registro!
Si se crean índices de una sola columna en vc_Name, vc_City e i_Age respectivamente, haciendo que la tabla tenga 3 índices de una sola columna, ¿será la eficiencia de la consulta la misma que la del índice compuesto anterior? La respuesta es muy diferente, muy inferior a nuestro índice compuesto. Aunque ahora hay tres índices, MySQL solo puede usar el que considera aparentemente más eficiente entre los índices de una sola columna; los otros dos no se utilizan, es decir, sigue siendo un proceso de escaneo de toda la tabla.
Crear un índice compuesto así equivale en realidad a crear por separado:
- vc_Name,vc_City,i_Age
- vc_Name,vc_City
- vc_Name
¡Estos tres índices compuestos! ¿Por qué no hay índices compuestos como vc_City, i_Age, etc.? Esto se debe al resultado del “prefijo más a la izquierda” del índice compuesto de MySQL. En pocas palabras, solo se combina comenzando desde la parte más a la izquierda. No todas las consultas que incluyen estas tres columnas usarán este índice compuesto; los siguientes T-SQL lo usarán:
SELECT * FROM myIndex WHREE vc_Name=”erquan” AND vc_City=”郑州” SELECT * FROM myIndex WHREE vc_Name=”erquan”
Mientras que los siguientes no lo usarán:
SELECT * FROM myIndex WHREE i_Age=20 AND vc_City=”郑州” SELECT * FROM myIndex WHREE vc_City=”郑州”
Es decir, name_city_age(vc_Name(10), vc_City, i_Age) indexa de izquierda a derecha. Si no hay un índice frontal izquierdo, MySQL no ejecuta la búsqueda por índice.
Índice de prefijo
Si la longitud de la columna indexada es demasiado larga, este tipo de índice de columna generará un archivo de índice muy grande, difícil de manejar. Se puede utilizar el método de índice de prefijo. El índice de prefijo debe controlarse en un punto adecuado, alrededor del valor áureo de 0.31 (si es mayor que este valor, se puede crear).
SELECT COUNT(DISTINCT(LEFT(`title`,10)))/COUNT(*) FROM Arctic; — Si este valor es mayor que 0.31, se puede crear un índice de prefijo. DISTINCT elimina duplicados. ALTER TABLE `user` ADD INDEX `uname`(title(10)); — Agrega el SQL del índice de prefijo, estableciendo el índice del nombre en 10, lo que reduce el tamaño del archivo de índice y acelera la velocidad de consulta del índice.
¿Qué tipo de SQL no utiliza índices?
Se debe tratar de evitar estos SQL que no utilizan índice.
SELECT `sname` FROM `stu` WHERE `age`+10=30;-- 不会使用索引,因为所有索引列参与了计算

SELECT `sname` FROM `stu` WHERE LEFT(`date`,4) <1990; -- 不会使用索引,因为使用了函数运算,原理与上面相同

SELECT * FROM `houdunwang` WHERE `uname` LIKE'后盾%' -- 走索引

SELECT * FROM `houdunwang` WHERE `uname` LIKE "%后盾%" -- 不走索引

-- 正则表达式不使用索引,这应该很好理解,所以为什么在SQL中很难看到regexp关键字的原因

-- 字符串与数字比较不使用索引;
CREATE TABLE `a` (`a` char(10));
EXPLAIN SELECT * FROM `a` WHERE `a`="1" -- 走索引
EXPLAIN SELECT * FROM `a` WHERE `a`=1 -- 不走索引

select * from dept where dname='xxx' or loc='xx' or deptno=45 --如果条件中有or,即使其中有条件带索引也不会使用。换言之,就是要求使用的所有字段,都必须建立索引,我们建议大家尽量避免使用or 关键字

-- 如果mysql估计使用全表扫描要比使用索引快,则不使用索引
Eficiencia del índice en asociaciones de múltiples tablas
- SELECT `sname` FROM `stu` WHERE LEFT(`date`,4) <1990; — No usará el índice, porque se usa una operación de función; el principio es el mismo que el anterior.
- SELECT * FROM `houdunwang` WHERE `uname` LIKE’后盾%’ — utiliza el índice
- SELECT * FROM `houdunwang` WHERE `uname` LIKE “%后盾%” — no utiliza el índice
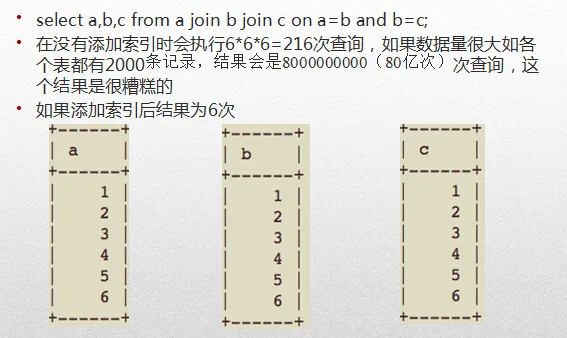
De la figura anterior se puede ver que el type de todas las tablas es all, lo que indica un escaneo de tabla completa. Es decir, 6 6 6, con un total de 216 recorridos de consulta.
Excepto la primera tabla, que representa el escaneo de tabla completa (es necesario, ya que se usa para asociar con otras tablas), las demás son de tipo range (obtenido mediante rango de índice), es decir, 6+1+1+1, con un total de solo 9 recorridos de consulta.
Por lo tanto, recomendamos unir la menor cantidad de tablas posible al hacer JOIN de múltiples tablas, porque sin cuidado se convierte en un terrible escaneo de producto cartesiano. Además, también recomendamos usar LEFT JOIN tanto como sea posible, para usar la tabla pequeña al asociarse con la grande. Porque al usar JOIN, la primera tabla debe escanearse por completo; usando la tabla pequeña para asociarse con la grande se puede reducir este número de escaneos.
Desventajas de los índices
No cree índices a ciegas; cree índices solo para las columnas que se consultan con frecuencia. Crear un índice hace que las operaciones de consulta sean más rápidas, pero reduce la velocidad de las operaciones de inserción, eliminación y actualización, porque al ejecutar estas operaciones también se reordenan o actualizan los archivos de índice.
Sin embargo, en las aplicaciones de Internet, las sentencias de consulta superan con creces a las sentencias DML, incluso pueden representar del 80% al 90%. Así que no hay que preocuparse demasiado; solo durante la importación de grandes volúmenes de datos, se puede eliminar el índice primero, insertar los datos en lote y finalmente volver a añadir el índice.