1. Was ist ein Webcrawler
Webcrawler: Ein Programm, das automatisch Informationen aus dem Internet sammelt und dabei wertvolle Informationen aus dem Internet für uns erfasst.
2. Architektur des Python-Webcrawlers
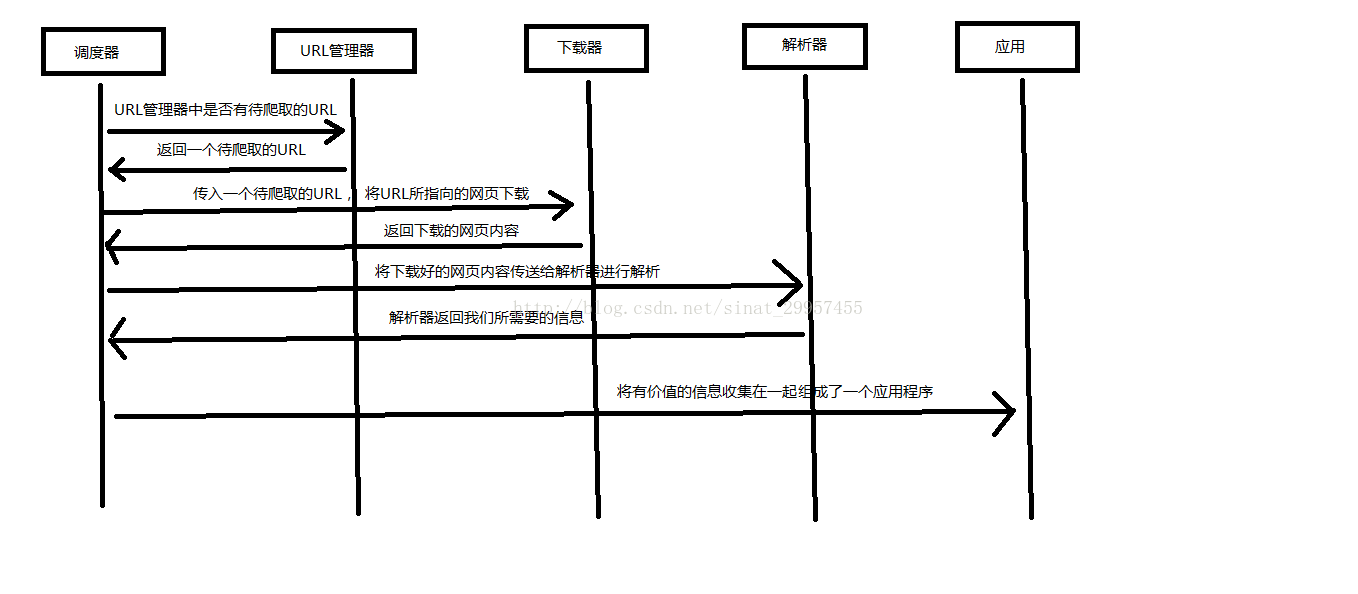
Die Architektur eines Python-Webcrawlers besteht hauptsächlich aus fünf Teilen: dem Scheduler, dem URL-Manager, dem Webseiten-Downloader, dem Webseiten-Parser und der Anwendung (wertvolle gecrawlte Daten).
- Scheduler:Entspricht der CPU eines Computers und ist hauptsächlich dafür verantwortlich, die Arbeit zwischen URL-Manager, Downloader und Parser zu koordinieren.
- URL-Manager:Enthält URLs, die gecrawlt werden sollen, und bereits gecrawlte URLs, wodurch doppeltes Crawlen und zirkuläres Crawlen von URLs verhindert wird. Der URL-Manager wird hauptsächlich auf drei Arten implementiert: über Speicher, Datenbank und Cache-Datenbank.
- Webseiten-Downloader:Lädt eine Webseite herunter, indem eine URL-Adresse übergeben wird, und wandelt die Webseite in eine Zeichenkette um. Webseiten-Downloader umfassen urllib2 (Pythons offizielles Basismodul), einschließlich Unterstützung für Login, Proxy und Cookies, sowie requests (Drittanbieter-Paket).
- Webseiten-Parser:Parst eine Webseiten-Zeichenkette, extrahiert nützliche Informationen gemäß unseren Anforderungen und kann auch basierend auf der DOM-Baum-Parsing-Methode parsen. Webseiten-Parser umfassen reguläre Ausdrücke (intuitiv, wandeln Webseiten in Zeichenketten um und extrahieren wertvolle Informationen durch unscharfes Matching; wenn das Dokument komplex ist, wird diese Methode zum Extrahieren von Daten sehr schwierig), html.parser (in Python integriert), beautifulsoup (Drittanbieter-Plugin, das Pythons eingebauten html.parser oder lxml zum Parsen verwenden kann; es ist im Vergleich zu den anderen Methoden leistungsfähiger) und lxml (Drittanbieter-Plugin, das XML und HTML parsen kann). html.parser, beautifulsoup und lxml parsen alle mit der DOM-Baum-Methode.
- Anwendung:Sie ist eine Anwendung, die aus aus Webseiten extrahierten nützlichen Daten besteht.
Das folgende Diagramm erklärt, wie der Scheduler die Arbeit koordiniert:
3. Drei Möglichkeiten, wie urllib2 das Herunterladen von Webseiten implementiert
4. Installation der Drittanbieter-Bibliothek Beautiful Soup
Beautiful Soup: Ein Python-Plugin eines Drittanbieters, das verwendet wird, um Daten aus XML und HTML zu extrahieren. Offizielle Website-Adressehttps://www.crummy.com/software/BeautifulSoup/
1. Beautiful Soup installieren
Öffnen Sie cmd (Eingabeaufforderung), navigieren Sie zum Ordner scripts im Installationsverzeichnis von Python (Version Python 2.7), geben Sie dir ein, um zu prüfen, ob pip.exe vorhanden ist. Falls ja, können Sie den in Python integrierten pip-Befehl zur Installation verwenden. Geben Sie den folgenden Befehl ein, um zu installieren:
pip install beautifulsoup4
2. Testen, ob die Installation erfolgreich war
Schreiben Sie eine Python-Datei und geben Sie Folgendes ein:
import bs4
print bs4
Führen Sie die Datei aus. Wenn sie normal ausgibt, war die Installation erfolgreich.
5. Verwenden von Beautiful Soup zum Parsen von HTML-Dateien
Originaladresse: https://blog.csdn.net/sinat_29957455/article/details/70846427