1. ¿Qué es un rastreador web?
Rastreador web: Un programa que captura automáticamente información de Internet, extrayendo de Internet la información que es valiosa para nosotros.
2. Arquitectura de un rastreador web de Python
La arquitectura del rastreador web de Python consta principalmente de cinco partes: el planificador, el administrador de URL, el descargador de páginas web, el analizador de páginas web y la aplicación (los datos valiosos extraídos).
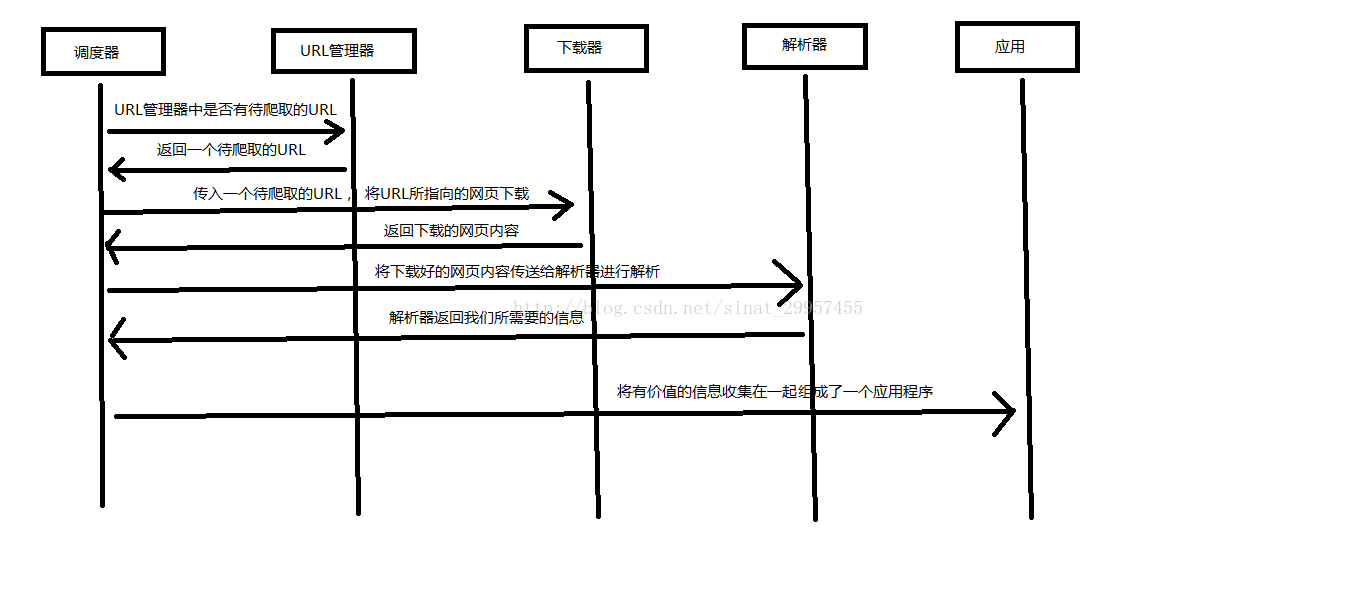
- Planificador:Es equivalente a la CPU de una computadora; se encarga principalmente de planificar y coordinar el trabajo entre el administrador de URL, el descargador y el analizador.
- Administrador de URL:Incluye las direcciones URL pendientes de rastrear y las ya rastreadas, para evitar rastreos duplicados y bucles de rastreo. Se implementa principalmente de tres formas: mediante memoria, base de datos y base de datos en caché.
- Descargador de páginas web:Descarga una página web pasando una dirección URL y la convierte en una cadena. Los descargadores de páginas web incluyen urllib2 (módulo básico oficial de Python), que incluye manejo de inicio de sesión, proxy y cookies, y requests (paquete de terceros).
- Analizador de páginas web:Analiza una cadena de una página web; puede extraer información útil según nuestros requisitos y también puede analizar siguiendo el árbol DOM. Los analizadores de páginas web incluyen: expresiones regulares (intuitivas, convierten la página web en una cadena y extraen información valiosa mediante coincidencias aproximadas; cuando el documento es más complejo, este método de extracción de datos resulta muy difícil), html.parser (incluido con Python), Beautiful Soup (complemento de terceros que puede usar html.parser incluido con Python o lxml para analizar; es algo más potente que los otros), y lxml (complemento de terceros que puede analizar XML y HTML). html.parser, Beautiful Soup y lxml analizan todos en forma de árbol DOM.
- Aplicación:Es una aplicación compuesta por los datos útiles extraídos de las páginas web.
A continuación, un diagrama explica cómo el planificador coordina el trabajo:
3. Tres formas de descargar páginas web con urllib2
4. Instalación de la librería de terceros Beautiful Soup
Beautiful Soup: Complemento de terceros de Python utilizado para extraer datos de XML y HTML. Dirección del sitio web oficial.https://www.crummy.com/software/BeautifulSoup/
1. Instalar Beautiful Soup
Abra cmd (símbolo del sistema), vaya al directorio scripts dentro del directorio de instalación de Python (versión Python 2.7), escriba dir para comprobar si existe pip.exe. Si es así, puede usar el comando pip incluido con Python para instalar. Simplemente ejecute el siguiente comando para instalarlo:
pip install beautifulsoup4
2. Probar si la instalación fue exitosa
Escriba un archivo Python e introduzca:
import bs4
print bs4
Ejecute el archivo. Si produce una salida normal, la instalación fue exitosa.
5. Usar Beautiful Soup para analizar archivos HTML
Dirección del artículo original: https://blog.csdn.net/sinat_29957455/article/details/70846427