1. Qu'est-ce qu'un crawler web ?
Crawler web: Un programme qui récupère automatiquement des informations sur Internet, en capturant pour nous des informations précieuses depuis Internet.
2. Architecture d'un crawler web Python
L’architecture d’un crawler web Python se compose principalement de cinq parties : l’ordonnanceur, le gestionnaire d’URL, le téléchargeur de pages web, l’analyseur de pages web et l’application (les données précieuses récoltées).
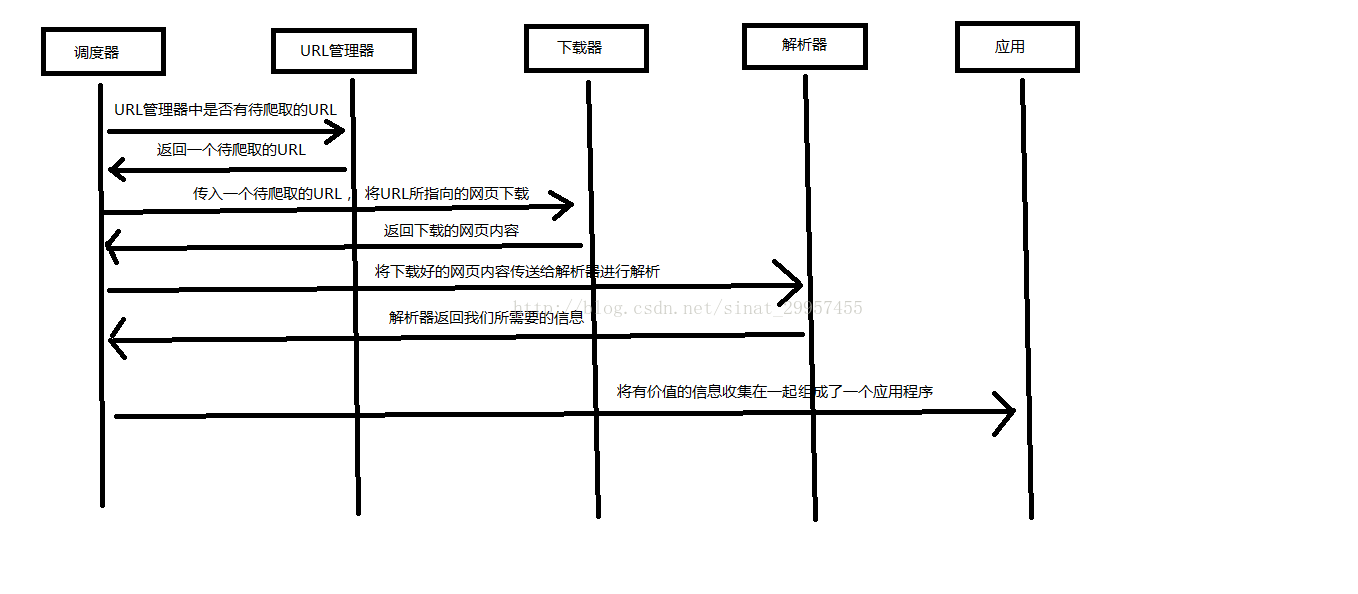
- Ordonnanceur :Équivalent au CPU d’un ordinateur, principalement chargé de coordonner le travail entre le gestionnaire d’URL, le téléchargeur et l’analyseur.
- Gestionnaire d’URL :Comprend les URL à explorer et les URL déjà explorées, ce qui évite l’exploration en double et l’exploration circulaire des URL. Le gestionnaire d’URL est principalement implémenté de trois manières : en mémoire, en base de données et en base de données de cache.
- Téléchargeur de pages web :Télécharge une page web en passant une adresse URL, en convertissant la page web en chaîne de caractères. Les téléchargeurs de pages web incluent urllib2 (module de base officiel de Python), avec prise en charge de la connexion, du proxy et des cookies, et requests (paquet tiers).
- Analyseur de pages web :Analyse une chaîne de page web, en extrayant les informations utiles selon nos besoins, et peut aussi analyser selon la méthode d’analyse par arborescence DOM. Les analyseurs de pages web incluent les expressions régulières (intuitives, convertissant les pages web en chaînes et extrayant des informations précieuses par correspondance floue ; lorsque le document est complexe, cette méthode devient très difficile pour extraire des données), html.parser (intégré à Python), beautifulsoup (plugin tiers qui peut utiliser html.parser ou lxml intégré à Python pour analyser ; il est plus puissant par rapport aux autres méthodes), et lxml (plugin tiers qui peut analyser le XML et le HTML). html.parser, beautifulsoup et lxml analysent tous à l’aide de la méthode par arborescence DOM.
- Application :Il s’agit d’une application composée de données utiles extraites des pages web.
Le diagramme suivant explique comment l’ordonnanceur coordonne le travail :
3. Trois façons dont urllib2 implémente le téléchargement de pages web
4. Installation de la bibliothèque tierce Beautiful Soup
Beautiful Soup: Un plugin Python tiers utilisé pour extraire des données à partir de XML et HTML. Adresse du site officielhttps://www.crummy.com/software/BeautifulSoup/
1. Installer Beautiful Soup
Ouvrez cmd (Invite de commandes), accédez au dossier scripts dans le répertoire d'installation de Python (version Python 2.7), tapez dir pour vérifier si pip.exe existe. Si c'est le cas, vous pouvez utiliser la commande pip intégrée à Python pour installer. Entrez la commande suivante pour installer :
pip install beautifulsoup4
2. Tester si l'installation a réussi
Écrivez un fichier Python et saisissez :
import bs4
print bs4
Exécutez le fichier. S'il produit une sortie normale, l'installation a réussi.
5. Utilisation de Beautiful Soup pour analyser des fichiers HTML
Adresse d'origine : https://blog.csdn.net/sinat_29957455/article/details/70846427