1. Что такое веб-краулер
Веб-краулер: программа, которая автоматически собирает информацию из интернета, извлекая для нас ценную информацию из интернета.
2. Архитектура веб-краулера Python
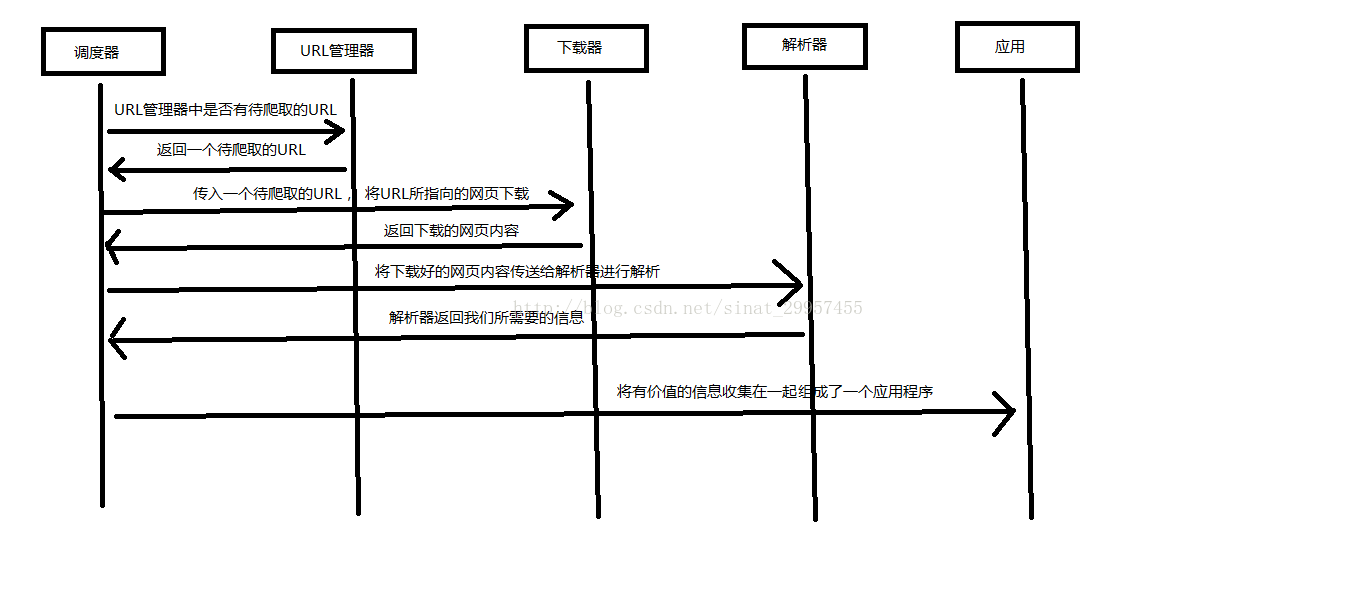
Архитектура веб-краулера на Python в основном состоит из пяти частей: планировщик, менеджер URL, загрузчик веб-страниц, парсер веб-страниц и приложение (ценные собранные данные).
- Планировщик:Эквивалентен CPU компьютера, в основном отвечает за координацию работы между менеджером URL, загрузчиком и парсером.
- Менеджер URL:Включает URL для обхода и уже обойденные URL, предотвращая повторный обход и циклический обход URL. Менеджер URL в основном реализуется тремя способами: через память, базу данных и кэш-базу данных.
- Загрузчик веб-страниц:Загружает веб-страницу, принимая URL-адрес, преобразуя веб-страницу в строку. Загрузчики веб-страниц включают urllib2 (официальный базовый модуль Python), включая поддержку входа, прокси и cookie, а также requests (сторонний пакет).
- Парсер веб-страниц:Разбирает строку веб-страницы, извлекая полезную информацию в соответствии с нашими требованиями, а также может выполнять разбор на основе метода разбора по DOM-дереву. Парсеры веб-страниц включают регулярные выражения (интуитивно понятные, преобразуют веб-страницы в строки и извлекают ценную информацию с помощью нечеткого сопоставления; когда документ сложный, этот метод становится очень трудным для извлечения данных), html.parser (встроен в Python), beautifulsoup (сторонний плагин, который может использовать встроенный в Python html.parser или lxml для разбора; он более мощный по сравнению с другими методами) и lxml (сторонний плагин, который может разбирать XML и HTML). html.parser, beautifulsoup и lxml все выполняют разбор с использованием метода DOM-дерева.
- Приложение:Это приложение, состоящее из полезных данных, извлеченных из веб-страниц.
Следующая диаграмма объясняет, как планировщик координирует работу:
3. Три способа реализации загрузки веб-страниц с помощью urllib2
4. Установка сторонней библиотеки Beautiful Soup
Beautiful Soup: сторонний плагин Python, используемый для извлечения данных из XML и HTML. Официальный адрес сайтаhttps://www.crummy.com/software/BeautifulSoup/
1. Установите Beautiful Soup
Откройте cmd (командную строку), перейдите в папку scripts в каталоге установки Python (версии Python 2.7), введите dir, чтобы проверить, существует ли pip.exe. Если да, можно использовать встроенную команду pip Python для установки. Введите следующую команду для установки:
pip install beautifulsoup4
2. Проверьте, успешно ли прошла установка
Создайте файл Python и введите:
import bs4
print bs4
Запустите файл. Если он выводит данные нормально, установка прошла успешно.
5. Использование Beautiful Soup для парсинга HTML-файлов
Исходный адрес: https://blog.csdn.net/sinat_29957455/article/details/70846427