Redis-Datentypen werden unterteilt in: String-Typ, Hash-Typ, List-Typ, Set-Typ, Sorted-Set-Typ.
Redis ist so beliebt; wie schnell läuft es? Ein gewöhnlicher Laptop kann 100.000 Lese-/Schreiboperationen in einer Sekunde abschließen.
Atomare Operation: die kleinste Operationseinheit, die nicht weiter aufgeteilt werden kann. Das heißt, die kleinste Ausführungseinheit, die nicht von anderen Befehlen unterbrochen wird. Unter hoher Nebenläufigkeit gibt es keine Race Condition.
KEY-Benennung: Ein guter Vorschlag ist, article:1:title zu verwenden, um den Titel des Artikels mit der ID 1 zu speichern.
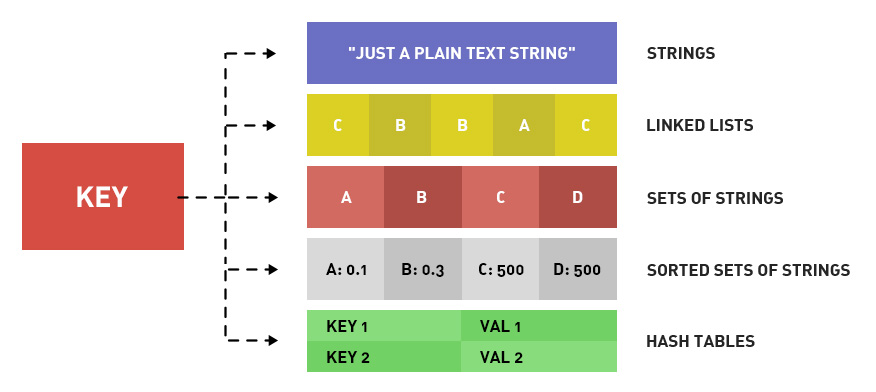
I. Einführung
- 1. Die Liste der Schlüssel abrufen: KEYS pattern. Wildcards umfassen ? * [] und Escape \.
- 2. Ob ein Schlüssel existiert: EXISTS key. Gibt 1 zurück, wenn er existiert, 0, wenn nicht.
- 3. Einen Schlüssel erstellen und einen Schlüssel löschen: SET key und DEL key.
- 4. Den im Schlüssel gespeicherten Redis-Datentyp anhand des Schlüssels abrufen: TYPE key. Die Rückgabe ist string, list, hash, set, zset. Im Folgenden erklären wir diese 5 zurückgegebenen Redis-Datentypen einzeln.
- 5. rename oldkey newkey: Benennt den Schlüssel um. Wenn newkey existiert, wird er überschrieben.
- 6. renamenx oldkey newkey: Benennt den Schlüssel um. Wenn newkey existiert, wird er nicht überschrieben.
- 7. randomkey: Gibt zufällig einen Schlüssel zurück.
- 8. move key db-index: Verschiebt den Schlüssel in die angegebene Datenbank. Wenn der Schlüssel nicht existiert oder sich bereits in dieser Datenbank befindet, wird 0 zurückgegeben. Bei Erfolg wird 1 zurückgegeben.
II. Redis-Datentypen Redis-Datenbefehle
1. Redis-Datentyp 1: String-Typ: Das ist leicht zu verstehen; ein Schlüssel speichert einen String. Was ist, wenn Sie Daten speichern möchten? Konvertieren Sie sie in JSON oder eine andere String-Serialisierung.
2. Redis-Datenbefehle 1: String-Typ:
- 1) Zuweisung: SET key value. Z. B. set hello world
- 2) Abruf: GET key. Z. B. get hello. Die Rückgabe ist world
- 3) Inkrement: INCR key. Dies ist MySQLs AUTO_INCREMENT. Jedes Mal, wenn INCR key ausgeführt wird, erhöht sich der Wert dieses Schlüssels um 1. Wenn der Schlüssel nicht existiert, wird zuerst eine 0 erzeugt, dann +1, und 1 zurückgegeben. Wenn der Wert keine Ganzzahl ist, wird ein Fehler gemeldet. Diese Operation ist atomar.
- 4) Dekrement: DECR key. Verringert den Wert des angegebenen Schlüssels um 1. Zum Beispiel bedeutet DECR num num-1
- 5) Inkrement um N: INCRBY key increment. Wird verwendet, um increment zum Wert des angegebenen Schlüssels hinzuzufügen. Zum Beispiel bedeutet INCRBY num 5 num+5
- 6) Dekrement um N: DECRBY key increment. Wird verwendet, um increment vom Wert des angegebenen Schlüssels zu subtrahieren. Zum Beispiel bedeutet DECRBY num 5 num-5
- 7) Erhöhung um eine Gleitkommazahl: INCRBYFLOAT key increment.
- 8) Anhängen ans Ende: APPEND key value. Zum Beispiel: set test:key 123, append test:key 456, get test:key ergibt 123456
- 9) Länge abrufen: STRLEN key.
- 10) Mehreren Schlüsseln gleichzeitig Werte zuweisen: MSET title This is the title description This is the description content This is the content.
- 11) Die Werte mehrerer Schlüssel gleichzeitig abrufen: MGET title description content
- 12) Bitoperation – Abrufen: GETBIT key offset. Zum Beispiel wird das Zeichen a in Redis als 01100001 (ASCII 98) gespeichert, dann gibt GETBIT key 2 1 zurück, GET key 0 gibt 0 zurück.
- 13) Bit-Operation – Setzen: SETBIT key offset value. Zum Beispiel wird das Zeichen a in Redis als 01100001 (ASCII 98) gespeichert, dann SETBIT key 6 0, SETBIT key 5 1, danach gibt get key b zurück. Denn die abgerufene Binärfolge ist 01100010.
- 14) Bit-Operation – Zählen: BITCOUNT key [start] [end]. BITCOUNT key wird verwendet, um die Anzahl der Bits zu ermitteln, die im Wert des Keys den Wert 1 haben. BITCOUNT key start end wird verwendet, um die Anzahl der Bits zu zählen, die in der Binärdarstellung der Teilzeichenkette zwischen start und end im Wert des Keys den Wert 1 haben (ziemlich verwirrend).
- 15) Bit-Operation – bitweise Operationen: BITOP operation resultKey key1 key2. operation ist eine bitweise Operation, einschließlich AND, OR, XOR, NOT. resultKey speichert das Ergebnis der Operation in diesem Key. key1 und key2 sind die an der Operation beteiligten Keys. Für die Operation können mehrere Keys angegeben werden.
3. Redis-Datentyp 2: Hash-Typ:
Redis speichert Daten in Form eines Wörterbuchs (assoziatives Array), wobei ein Key einem Wert entspricht. Im String-Typ kann der Wert nur ein String sein. Im Hash-Typ (auch Hash genannt) entspricht der Wert ebenfalls einem Wörterbuch (assoziatives Array). Man kann also verstehen, dass im Hash-Typ/Hash-Typ von Redis der einem Key entsprechende Wert ein zweidimensionales Array ist. Die Werte der Felder können jedoch nur Strings sein. Das heißt, es kann nur ein zweidimensionales Array sein und nicht mehr Dimensionen haben.
4. Redis-Datenbefehle 2: Hash-Typ:
- 1) Zuweisung: HSET key field value. Z. B. hset user name lane. hset user age 23
- 2) Abruf: HGET key field. Z. B. gibt hget user name lane zurück.
- 3) Werte mehreren Feldern desselben Keys zuweisen: HMSET key field1 value1 field2 value2...
- 4) Werte mehrerer Felder desselben Keys abrufen: HMGET key field1 fields2...
- 5) Alle Felder und alle Werte des Keys abrufen: HGETALL key. Zum Beispiel gibt HGETALL user name lane age 23 zurück. Jede Rückgabe erfolgt in einer separaten Zeile.
- 6) Ob ein Feld existiert: HEXISTS key field. Gibt 1 zurück, wenn es existiert, 0, wenn nicht.
- 7) Weist einen Wert zu, wenn das Feld nicht existiert: HSETNX key field value. Wenn das Feld unter dem Schlüssel nicht existiert, erstelle das Feld mit dem Wert. Wenn das Feld existiert, wird keine Operation ausgeführt. Seine Wirkung entspricht HEXISTS + HSET. Der Vorteil dieses Befehls ist jedoch, dass es sich um eine atomare Operation handelt. Egal wie hoch die Parallelität ist, es besteht keine Notwendigkeit zu befürchten.
- 8) Erhöhung um N: HINCREBY key field increment. Gleich wie beim String-Inkrement-Typ, keine weitere Erläuterung.
- 9) Felder löschen: DEL key field1 field2... Löscht ein oder mehrere Felder des angegebenen Schlüssels.
- 10) Nur Feldnamen abrufen: HKEYS key. Ähnlich wie HGETALL, ruft aber nur Feldnamen ab, nicht Feldwerte.
- 11) Nur Feldwerte abrufen: HVALS key. Ähnlich wie HGETALL, ruft aber nur Feldwerte ab, nicht Feldnamen.
- 12) Anzahl der Felder abrufen: HLEN key.
5. Redis-Datentyp 3: Listentyp
Der Listentyp speichert eine geordnete Liste von Strings. Häufige Operationen sind das Einfügen neuer Elemente an beiden Enden. Die Zeitkomplexität ist O(1). Die Struktur ist eine verknüpfte Liste, die die Adressen von Kopf und Ende aufzeichnet. Wenn man das sieht, wird eine wichtige Rolle des Listentyps des Redis-Datentyps bald deutlich, nämlich eine Warteschlange. Neue Anfragen werden am Ende eingefügt und bearbeitete vom Kopf gelöscht. Darüber hinaus zum Beispiel Weibos frische Nachrichten. Zum Beispiel Protokolle. Der Listentyp ist ein Array mit Indizes, die bei 0 beginnen. Da er als verknüpfte Liste gespeichert wird, ist die Operation umso schneller, je näher am Kopf und Ende; je näher in der Mitte, desto langsamer.
6. Redis-Datenbefehle 3: Listentyp:
- 1) Am Kopf einfügen: LPUSH key value1 value2... Gibt die Länge der Liste nach der Erhöhung zurück.
- 2) Am Ende einfügen: RPUSH key value1 value2... . Gibt die Länge der Liste nach dem Hinzufügen zurück.
- 3) Vom Kopf entnehmen: LPOP key. Gibt den Wert des entnommenen Elements zurück. Diese Operation entfernt zuerst das erste Element der key-Liste und gibt es dann zurück.
- 4) Vom Ende entfernen (Pop): RPOP key. Gibt den Wert des entfernten Elements zurück.
- 5) Anzahl der Listenelemente: LLEN key. Gibt 0 zurück, wenn key nicht existiert.
- 6) Unterliste der Liste abrufen: LRANGE start end. Gibt die Liste der Elemente vom start-ten bis zum end-ten zurück, einschließlich start und end. Unterstützt negative Indizes. -1 steht für das letzte Element, -2 für das vorletzte Element.
- 7) Angegebene Werte in der Liste löschen: LREM key count value. Löscht alle Elemente mit dem Wert gleich value in der Liste von key, aber es werden nur count Elemente gelöscht. Wenn count+1 vorhanden sind, wird das letzte behalten. Wenn count nicht existiert oder 0 ist, alle löschen. Wenn count > 0, count Elemente vom Kopf zum Ende löschen; wenn count < 0, count Elemente vom Ende zum Kopf löschen.
- 8) Wert am angegebenen Index abrufen: LINDEX key index. Zum Beispiel ruft LINDEX key 0 das erste Element der Liste ab. index kann negativ sein.
- 9) Index und Wert setzen: LSET key index value. Diese Operation ändert nur den Wert am angegebenen Index für den angegebenen key. Wenn index nicht existiert, wird ein Fehler gemeldet.
- 10) Einen Ausschnitt behalten und den Rest löschen: LTRIM key start end. Behält alle Elemente zwischen start und end, einschließlich start und end. Löscht alle anderen.
- 11) Ein Element in eine Liste einfügen: LINSERT key BEFORE/AFTER value1 value2. Durchläuft die Liste vom Kopf aus, stoppt, wenn ein Wert gleich value1 gefunden wird, und fügt dann value2 ein, entweder vor oder nach value1, je nach BEFORE oder AFTER.
- 12) Ein Element von einer Liste in eine andere verschieben: RPOPLPUSH list1 list2. Entfernt das rechtsste Element von list1 und fügt dieses Element auf der linken Seite von list2 ein. Atomare Operation.
7. Redis-Datentyp 4: Set-Typ:
Der Set-Typ ist für bequeme Operationen und Berechnungen auf mehreren Sets konzipiert. Jedes Element in einem Set ist eindeutig und hat kein Konzept von Reihenfolge; jedes Element ist und kann nur eine Zeichenkette sein. Häufige Operationen sind Einfügen, Löschen, Mitgliedschaftstests usw. Die Zeitkomplexität ist O(1). Er unterstützt Schnittmengen-, Vereinigungs- und Differenzoperationen. Zum Beispiel hat Artikel 1 3 Tags, gespeichert als Redis-Set-Typ. Artikel 2 hat 3 Tags, gespeichert als Redis-Set-Typ. Artikel 1 handelt von MySQL, und Artikel 2 handelt von Redis. Ergibt dann die Schnittmenge nicht eine Datenbank? (vorausgesetzt, das Tag "database" existiert in beiden Artikeln). Ein Set-Typ in Redis wird als Hash-Tabelle mit Nullwerten gespeichert.
8. Redis-Datenbefehle 4: Set-Typ:
- 1) Hinzufügen: SADD key value.
- 2) Löschen: SREM key value.
- 3) Alle Elemente des angegebenen Sets abrufen: SMEMBERS key.
- 4) Prüfen, ob ein Element existiert: SISMEMBER key value.
- 5) Differenzoperation: SDIFF key1 key2... . Führt eine Differenzoperation auf mehreren Sets durch.
- 6) Schnittmengenoperation: SINNER key1 key2... . Führt eine Schnittmengenoperation auf mehreren Sets durch.
- 7) Vereinigungsoperation: SUNION key1 key2... . Führt eine Vereinigungsoperation auf mehreren Sets durch.
- 8) Die Anzahl der Elemente in einem Set abrufen: SCARD key. Gibt die Gesamtzahl der Elemente im Set zurück.
- 9) Das Ergebnis der Differenz-, Schnittmengen- oder Vereinigungsoperation in einem angegebenen Schlüssel speichern: SDIFFSTORE storekey key1 key2. Berechnet die Differenz zwischen key1 und key2 und speichert das Ergebnis in dem Set mit dem Schlüssel storekey. SINNERSTORE und SUNIONSTORE sind ähnlich.
- 10) Zufällige Elemente aus einem Set abrufen: SRANDMEMBER key [count]. Der Parameter count ist optional; wenn count nicht angegeben wird, wird ein zufälliges Element zurückgegeben. Wenn count > 0, werden count unterschiedliche Elemente zurückgegeben. Wenn count < 0, werden insgesamt |count| Elemente zurückgegeben, wobei Duplikate erlaubt sind.
- 11) Zufälliges Herausnehmen eines Elements: SPOP key. Nimmt zufällig ein Element aus dem Set heraus, entfernt es und gibt den Wert dieses Elements zurück.
9. Redis-Datentyp 5: Sorted-Set-Typ:
Der Set-Typ ist ungeordnet, und jedes Element ist eindeutig. Ein Sorted Set hingegen ist geordnet, und jedes Element ist eindeutig. Der Unterschied zwischen dem Sorted-Set-Typ und dem Set-Typ besteht darin, dass das Sorted Set jedem Element ein Attribut zuweist: score. Das Sorted Set wird nach score sortiert. Das Sorted Set wird mithilfe von Hash-Tabellen und Skip-Listen implementiert. Daher ist das Arbeiten mit mittleren Elementen im Vergleich zu Listen ebenfalls sehr schnell. Die Zeitkomplexität beträgt O(log(N)). Bei den Redis-Datentypen verbraucht der Sorted-Set-Typ mehr Ressourcen als der List-Typ.
10. Redis-Datenbefehle 5: Sorted-Set-Typ
- 1) Hinzufügen: ZADD key sorce1 value1 sorce2 value2... .
- 2) Score abrufen: ZSCORE key value. Ruft den Score des Elements mit dem Wert value im Sorted Set von key ab.
- 3) Die Liste der Elemente abrufen, deren Rang innerhalb eines Bereichs liegt: ZRANFGE key start stop [WITHSCORE]. Ruft die Liste der Elemente ab, deren Rang zwischen start und stop liegt, einschließlich start und stop. Jedes Element steht in einer Zeile. Wenn der Parameter WITHSCORE enthalten ist, dann eine Zeile für den Elementwert und eine Zeile für den Score. Die Zeitkomplexität beträgt O(log n + m). Wenn die Scores gleich sind, dann 0<0.
- 4) Elemente innerhalb eines angegebenen Score-Bereichs abrufen: ZRANGEBYSCORE key min max [WITHSCORE] [LIMIT offset count]. Ruft die Liste der Elemente mit Scores zwischen min und max ab, einschließlich beider Enden. Jedes Element steht in einer Zeile. Wenn der Parameter WITHSCORE enthalten ist, dann eine Zeile für den Elementwert und eine Zeile für den Score. Wenn min größer als max ist, ist die Reihenfolge umgekehrt.
- 5) Den Score eines Elements erhöhen: ZINCRBY key increment value. Der Score des Elements mit dem Wert value im angegebenen Sorted Set wird um increment erhöht. Gibt den Score nach der Änderung zurück.
- 6) Die Anzahl der Elemente im Set abrufen: ZCARD key.
- 7) Ermittelt die Anzahl der Elemente innerhalb eines angegebenen Score-Bereichs: ZCOUNT key min max.
- 8) Löscht ein oder mehrere Elemente: ZREM key value1 value2...
- 9) Löscht Elemente nach Rangbereich: ZREMRANGEBYRANK key start end. Löscht Elemente, deren Rang zwischen start und end liegt.
- 10) Löscht Elemente nach Score-Bereich: ZREMRANGEBYSCORE key min max.
- 11) Ermittelt den Rang eines Elements (aufsteigend): ZRANK key value. Ermittelt den Rang von value in der Menge vom kleinsten zum größten.
- 12) Ermittelt den Rang eines Elements (absteigend): ZREVRANK key value. Ermittelt den Rang von value in der Menge vom größten zum kleinsten.
- 13) Schnittmenge sortierter Sets: ZINTERSTORE storekey key1 key2...[WEIGHTS weight [weight..]] [AGGREGATE SUM|MIN|MAX]. Wird verwendet, um die Schnittmenge mehrerer Sets zu berechnen, wobei das Ergebnis in storekey gespeichert wird. Der Rückgabewert ist die Anzahl der Elemente in storekey. Wenn AGGREGATE gleich SUM ist, dann ist der Score jedes Elements im storekey-Set die Summe der Scores aus den beteiligten Sets. MIN ist das Minimum der beteiligten Scores. MAX ist das Maximum der beteiligten Scores. WEIGHTS legt das Gewicht für jedes Set fest, z. B. WEIGHTS 1 0.1. Dann wird der Score jedes Elements von Set A mit 1 multipliziert und der Score jedes Elements von Set B mit 0.1 multipliziert.
- 14) Vereinigung sortierter Sets: ZUNIONSTORE storekey key1 kye2...[WEIGHTS weight [weight..]] [AGGREGATE SUM|MIN|MAX]