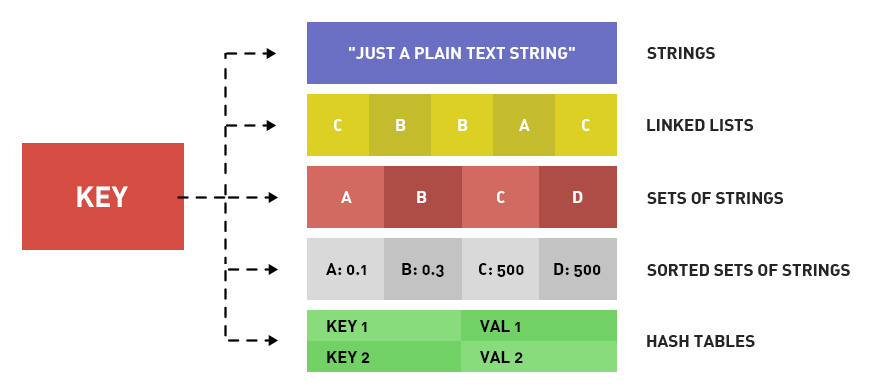
Типы данных Redis делятся на: строковый тип, хеш-тип, тип списка, тип множества, тип сортированного множества.
Redis настолько популярен; как быстро он работает? Обычный ноутбук может выполнить 100,000 операций чтения/записи за одну секунду.
Атомарная операция: наименьшая единица операции, которую нельзя разделить дальше. То есть наименьшая единица выполнения, которая не будет прервана другими командами. При высокой конкурентности не возникает состояния гонки.
Именование KEY: хорошая рекомендация — использовать article:1:title для хранения заголовка статьи с ID 1.
I. Введение
- 1. Получить список ключей: KEYS pattern. Подстановочные знаки включают ? * [] и экранирование \.
- 2. Существует ли ключ: EXISTS key. Возвращает 1, если он существует, и 0, если нет.
- 3. Создать ключ и удалить ключ: SET key и DEL key.
- 4. Получить тип данных Redis, хранимый по ключу, на основе ключа: TYPE key. Возвращается string, list, hash, set, zset. Ниже мы объясним эти 5 возвращаемых типов данных Redis по очереди.
- 5. rename oldkey newkey: Переименовать ключ. Если newkey существует, он будет перезаписан.
- 6. renamenx oldkey newkey: Переименовать ключ. Если newkey существует, он не будет перезаписан.
- 7. randomkey: Случайным образом вернуть ключ.
- 8. move key db-index: Переместить ключ в указанную базу данных. Если ключ не существует или уже находится в этой базе данных, вернуть 0. В случае успеха вернуть 1.
II. Типы данных Redis. Команды данных Redis
1. Тип данных Redis 1: Строковый тип: Это легко понять; один ключ хранит одну строку. Что делать, если вы хотите сохранить данные? Преобразуйте их в JSON или другую строковую сериализацию.
2. Команды данных Redis 1: Строковый тип:
- 1) Присваивание: SET key value. Например, set hello world
- 2) Получение: GET key. Например, get hello. Возвращается world
- 3) Инкремент: INCR key. Это аналог AUTO_INCREMENT в MySQL. Каждый раз при выполнении INCR key значение этого ключа увеличивается на 1. Если ключ не существует, сначала создаётся 0, затем +1, возвращается 1. Если значение не является целым числом, сообщается об ошибке. Эта операция атомарна.
- 4) Декремент: DECR key. Уменьшает значение указанного ключа на 1. Например, DECR num означает num-1
- 5) Увеличение на N: INCRBY key increment. Используется для прибавления increment к значению указанного ключа. Например, INCRBY num 5 означает num+5
- 6) Уменьшение на N: DECRBY key increment. Используется для вычитания increment из значения указанного ключа. Например, DECRBY num 5 означает num-5
- 7) Увеличение на число с плавающей точкой: INCRBYFLOAT key increment.
- 8) Добавление в конец: APPEND key value. Например, set test:key 123, append test:key 456, get test:key даёт 123456
- 9) Получение длины: STRLEN key.
- 10) Присваивание значений нескольким ключам одновременно: MSET title This is the title description This is the description content This is the content.
- 11) Получение значений нескольких ключей одновременно: MGET title description content
- 12) Побитовая операция — получение: GETBIT key offset. Например, символ a хранится в Redis как 01100001 (ASCII 98), тогда GETBIT key 2 возвращает 1, GET key 0 возвращает 0.
- 13) Битовая операция — установка: SETBIT key offset value. Например, символ a хранится в Redis как 01100001 (ASCII 98), затем SETBIT key 6 0, SETBIT key 5 1, после чего get key возвращает b. Потому что полученное двоичное значение — 01100010.
- 14) Битовая операция — подсчёт: BITCOUNT key [start] [end]. BITCOUNT key используется для получения количества битов, равных 1, в значении ключа. BITCOUNT key start end используется для подсчёта количества битов, равных 1, в двоичном представлении подстроки между start и end в значении ключа (довольно запутанно).
- 15) Битовая операция — побитовые операции: BITOP operation resultKey key1 key2. operation — это побитовая операция, включая AND, OR, XOR, NOT. resultKey сохраняет результат операции в этом ключе. key1 и key2 — ключи, участвующие в операции. Для операции можно указать несколько ключей.
3. Тип данных Redis 2: Хеш-тип:
Redis хранит данные в виде словаря (ассоциативного массива), где одному ключу соответствует одно значение. В строковом типе значением может быть только строка. Затем в хеш-типе (также называемом хеш-типом) значение также соответствует словарю (ассоциативному массиву). Таким образом, можно понять, что в хеш-типе/хеш-типе Redis значение, соответствующее ключу, — это двумерный массив. Но значения полей могут быть только строками. То есть это может быть только двумерный массив, и не может иметь больше измерений.
4. Команды данных Redis 2: Хеш-тип:
- 1) Присваивание: HSET key field value. Например, hset user name lane. hset user age 23
- 2) Получение: HGET key field. Например, hget user name возвращает lane.
- 3) Присвоить значения нескольким полям одного и того же ключа: HMSET key field1 value1 field2 value2...
- 4) Получить значения нескольких полей одного и того же ключа: HMGET key field1 fields2...
- 5) Получить все поля и все значения ключа: HGETALL key. Например, HGETALL user возвращает name lane age 23. Каждый возвращаемый элемент выводится на отдельной строке.
- 6) Существует ли поле: HEXISTS key field. Возвращает 1, если существует, 0, если нет.
- 7) Присвоить значение, когда поле не существует: HSETNX key field value. Если поле по ключу не существует, создайте поле со значением. Если поле существует, операция не выполняется. Её эффект эквивалентен HEXISTS + HSET. Но преимущество этой команды в том, что это атомарная операция. Как бы высока ни была конкурентность, бояться не нужно.
- 8) Увеличить на N: HINCREBY key field increment. То же, что и строковый тип увеличения, подробнее не описывается.
- 9) Удалить поля: DEL key field1 field2... Удаляет одно или несколько полей указанного ключа.
- 10) Получить только имена полей: HKEYS key. Похоже на HGETALL, но получает только имена полей, а не значения полей.
- 11) Получить только значения полей: HVALS key. Похоже на HGETALL, но получает только значения полей, а не имена полей.
- 12) Получить количество полей: HLEN key.
5. Тип данных Redis 3: тип список
Тип список хранит упорядоченный список строк. Обычные операции — вставка новых элементов с обоих концов. Временная сложность — O(1). Структура представляет собой связанный список, хранящий адреса головы и хвоста. Видя это, становится ясна одна из главных ролей типа список в Redis — очередь. Новые запросы вставляются в хвост, а обработанные удаляются из головы. Кроме того, например, свежие новости Weibo. Например, логи. Тип список — это массив с индексами, начинающимися с 0. Поскольку он хранится как связанный список, чем ближе к голове и хвосту, тем быстрее операция; чем ближе к середине, тем медленнее.
6. Команды данных Redis 3: тип список:
- 1) Вставка в голову: LPUSH key value1 value2... Возвращает длину списка после увеличения.
- 2) Вставка в хвост: RPUSH key value1 value2... . Возвращает длину списка после добавления.
- 3) Извлечь из головы: LPOP key. Возвращает значение извлечённого элемента. Эта операция сначала удаляет первый элемент списка ключа, затем возвращает его.
- 4) Извлечение из хвоста: RPOP key. Возвращает значение извлечённого элемента.
- 5) Количество элементов списка: LLEN key. Возвращает 0, если ключ не существует.
- 6) Получить подсписок списка: LRANGE start end. Возвращает список элементов с start-го по end-й, включая start и end. Поддерживает отрицательные индексы. -1 обозначает последний элемент, -2 обозначает предпоследний элемент.
- 7) Удалить указанные значения в списке: LREM key count value. Удаляет все элементы со значением, равным value, в списке key, но удаляется только count элементов. Если их count+1, то последний сохраняется. Если count отсутствует или равен 0, удалить все. Если count > 0, удалить count элементов от головы к хвосту; если count < 0, удалить count элементов от хвоста к голове.
- 8) Получить значение по указанному индексу: LINDEX key index. Например, LINDEX key 0 получает первый элемент списка. index может быть отрицательным.
- 9) Установить индекс и значение: LSET key index value. Эта операция изменяет только значение по указанному индексу для заданного ключа. Если index не существует, сообщается об ошибке.
- 10) Оставить срез и удалить остальное: LTRIM key start end. Оставляет все элементы между start и end, включая start и end. Удаляет все остальные.
- 11) Вставить элемент в список: LINSERT key BEFORE/AFTER value1 value2. Пройти от головы списка, остановиться, когда найдено значение, равное value1, затем вставить value2 либо перед value1, либо после value1 в зависимости от BEFORE или AFTER.
- 12) Переместить элемент из одного списка в другой: RPOPLPUSH list1 list2. Удаляет самый правый элемент list1 и вставляет этот элемент в левую часть list2. Атомарная операция.
7. Тип данных Redis 4: тип Set:
Тип set предназначен для удобных операций и вычислений над несколькими множествами. Каждый элемент в множестве уникален, и понятие порядка отсутствует; каждый элемент является строкой и может быть только строкой. Обычные операции — вставка, удаление, проверка принадлежности и т. д. Временная сложность — O(1). Он поддерживает операции пересечения, объединения и разности. Например, у статьи 1 есть 3 тега, сохранённых как тип set в Redis. У статьи 2 есть 3 тега, сохранённых как тип set в Redis. Статья 1 — про MySQL, а статья 2 — про Redis. Тогда разве пересечение не даст базу данных? (при условии, что тег "database" есть в обеих статьях). Тип set в Redis хранится как хеш-таблица со значениями null.
8. Команды работы с данными Redis 4: тип set:
- 1) Добавить: SADD key value.
- 2) Удалить: SREM key value.
- 3) Получить все элементы указанного множества: SMEMBERS key.
- 4) Проверить, существует ли элемент: SISMEMBER key value.
- 5) Операция разности: SDIFF key1 key2... . Выполняет операцию разности над несколькими множествами.
- 6) Операция пересечения: SINNER key1 key2... . Выполняет операцию пересечения над несколькими множествами.
- 7) Операция объединения: SUNION key1 key2... . Выполняет операцию объединения над несколькими множествами.
- 8) Получить количество элементов в множестве: SCARD key. Возвращает общее количество элементов в множестве.
- 9) Сохранить результат операции разности, пересечения или объединения в указанном ключе: SDIFFSTORE storekey key1 key2. Вычисляет разность между key1 и key2 и сохраняет результат в множестве с ключом storekey. SINNERSTORE и SUNIONSTORE работают аналогично.
- 10) Получить случайные элементы из множества: SRANDMEMBER key [count]. Параметр count необязателен; если count не указан, возвращается один случайный элемент. Если count > 0, возвращается count различных элементов. Если count < 0, возвращается всего |count| элементов, при этом дубликаты допускаются.
- 11) Случайным образом извлечь элемент: SPOP key. Случайным образом извлекает элемент из множества, удаляет его и возвращает значение этого элемента.
9. Тип данных Redis 5: тип Sorted Set:
Тип set неупорядочен, и каждый элемент уникален. Sorted set, напротив, упорядочен, и каждый элемент уникален. Отличие типа sorted set от типа set состоит в том, что sorted set назначает каждому элементу атрибут: score. Sorted set сортируется по score. Sorted set реализован с использованием хеш-таблиц и списков с пропусками. Поэтому по сравнению со списками операции над средними элементами также очень быстры. Временная сложность — O(log(N)). Среди типов данных Redis тип sorted set потребляет больше ресурсов, чем тип list.
10. Команды для работы с данными Redis 5: тип Sorted Set
- 1) Добавить: ZADD key sorce1 value1 sorce2 value2... .
- 2) Получить score: ZSCORE key value. Получает score элемента со значением value в sorted set ключа key.
- 3) Получить список элементов, входящих в диапазон по рангу: ZRANFGE key start stop [WITHSCORE]. Получает список элементов, ранг которых находится между start и end включительно. Каждый элемент на отдельной строке. Если параметр WITHSCORE указан, то одна строка для значения элемента и одна строка для score. Временная сложность — O(log n + m). Если score одинаковы, то 0<0.
- 4) Получить элементы в заданном диапазоне score: ZRANGEBYSCORE key min max [WITHSCORE] [LIMIT offset count]. Получает список элементов со score между min и max включительно. Каждый элемент на отдельной строке. Если параметр WITHSCORE указан, то одна строка для значения элемента и одна строка для score. Если min больше max, порядок обратный.
- 5) Увеличить score элемента: ZINCRBY key increment value. Score элемента со значением value в указанном sorted set увеличивается на increment. Возвращает score после изменения.
- 6) Получить количество элементов в множестве: ZCARD key.
- 7) Получить количество элементов в заданном диапазоне оценок: ZCOUNT key min max.
- 8) Удалить один или несколько элементов: ZREM key value1 value2...
- 9) Удалить элементы по диапазону рангов: ZREMRANGEBYRANK key start end. Удаляет элементы с рангами между start и end.
- 10) Удалить элементы по диапазону оценок: ZREMRANGEBYSCORE key min max.
- 11) Получить ранг элемента (по возрастанию): ZRANK key value. Возвращает ранг value в множестве от наименьшего к наибольшему.
- 12) Получить ранг элемента (по убыванию): ZREVRANK key value. Возвращает ранг value в множестве от наибольшего к наименьшему.
- 13) Пересечение упорядоченных множеств: ZINTERSTORE storekey key1 key2...[WEIGHTS weight [weight..]] [AGGREGATE SUM|MIN|MAX]. Используется для вычисления пересечения нескольких множеств, результат сохраняется в storekey. Возвращаемое значение — количество элементов в storekey. Если AGGREGATE имеет значение SUM, то оценка каждого элемента во множестве storekey равна сумме оценок из участвующих множеств. MIN — минимум из оценок участвующих множеств. MAX — максимум из оценок участвующих множеств. WEIGHTS задаёт вес для каждого множества, например WEIGHTS 1 0.1. Тогда оценка каждого элемента множества A умножается на 1, а оценка каждого элемента множества B умножается на 0.1.
- 14) Объединение упорядоченных множеств: ZUNIONSTORE storekey key1 kye2...[WEIGHTS weight [weight..]] [AGGREGATE SUM|MIN|MAX]