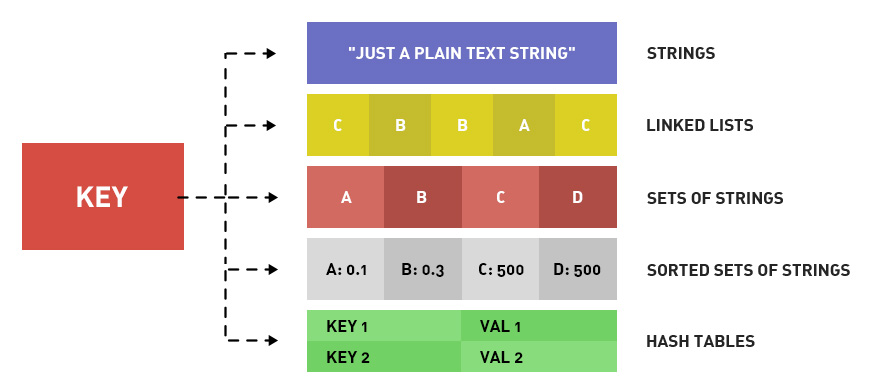
Los tipos de datos de Redis se dividen en: tipo string, tipo hash, tipo lista, tipo conjunto y tipo conjunto ordenado.
Redis es tan popular, ¿qué tan rápido funciona? Una computadora portátil normal puede completar cien mil operaciones de lectura y escritura en 1 segundo.
Operación atómica: la unidad de operación más pequeña, no se puede dividir más. Es decir, la unidad de ejecución más pequeña, no puede ser interrumpida por otros comandos. Bajo alta concurrencia no existen condiciones de carrera.
Nombramiento de claves: un buen consejo es usar article:1:title para almacenar el título del artículo con ID 1.
I. Introducción
- 1. Obtener la lista de claves: KEYS pattern. Los comodines son ? * [] y el escape \.
- 2. Comprobar si existe una clave: EXISTS key. Devuelve 1 si existe, 0 si no existe.
- 3. Crear y eliminar una clave: SET key y DEL key.
- 4. Obtener el tipo de datos de Redis almacenado en la clave: TYPE key. Devuelve string, list, hash, set, zset. A continuación se explicarán estos 5 tipos de datos de Redis uno por uno.
- 5. rename oldkey newkey: renombra la clave. Si newkey ya existe, se sobrescribe.
- 6. renamenx oldkey newkey: renombra la clave. Si newkey ya existe, no se sobrescribe.
- 7. randomkey: devuelve una clave aleatoriamente.
- 8. move key db-index: mueve la clave a la base de datos especificada. Si la clave no existe o ya está en esa base de datos, devuelve 0. Si tiene éxito, devuelve 1.
II. Tipos de datos de Redis y comandos de datos de Redis
1. Primer tipo de datos de Redis: tipo string. Esto es fácil de entender: una clave almacena una cadena. ¿Y si quieres almacenar datos? Conviértelos a JSON u otra serialización de cadena.
2. Comandos de datos de Redis para el tipo string:
- 1) Asignación: SET key value. Por ejemplo, set hello world
- 2) Obtención: GET key. Por ejemplo, get hello. Devuelve world
- 3) Incremento: INCR key. Es como AUTO_INCREMENT de MySQL. Cada vez que se ejecuta INCR key, el valor de la clave aumenta en 1. Si la clave no existe, primero se crea un 0, luego se suma 1, y devuelve 1. Si el valor no es un entero, se produce un error. Esta operación es atómica.
- 4) Decremento: DECR key. Reduce el valor de la clave especificada en 1. Por ejemplo, DECR num, es num-1
- 5) Incremento en N: INCRBY key increment se usa para sumar increment al valor de la clave especificada. Por ejemplo, INCRBY num 5 es num+5
- 6) Decremento en N: DECRBY key increment se usa para restar increment al valor de la clave especificada. Por ejemplo, DECRBY num 5 es num-5
- 7) Sumar número de punto flotante: INCRBYFLOAT key increment.
- 8) Añadir al final: APPEND key value. Por ejemplo, set test:key 123, append test:key 456, get test:key devuelve 123456
- 9) Obtener longitud: STRLEN key.
- 10) Asignar valores a múltiples claves simultáneamente: MSET title este es el título description esta es la descripción content este es el contenido.
- 11) Obtener valores de múltiples claves simultáneamente: MGET title description content
- 12) Operación de bits - obtener: GETBIT key offset. Por ejemplo, el carácter 'a' se almacena en Redis como 01100001 (ASCII 98), entonces GETBIT key 2 es 1, GET key 0 es 0.
- 13) Operación de bits - establecer: SETBIT key offset value. Por ejemplo, el carácter 'a' se almacena en Redis como 01100001 (ASCII 98), entonces SETBIT key 6 0, SETBIT key 5 1, y get key devuelve 'b'. Porque el binario resultante es 01100010.
- 14) Operación de bits - conteo: BITCOUNT key [start] [end]: BITCOUNT key se usa para obtener el número de bits que son 1 en el valor de la clave. Mientras que BITCOUNT key start end se usa para contar el número de bits que son 1 en la subcadena entre start y end del valor de la clave (¡qué confuso!).
- 15) Operación de bits - operaciones bit a bit: BITOP operation resultKey key1 key2. operation es la operación de bits, que puede ser AND, OR, XOR, NOT. resultKey es donde se almacena el resultado de la operación. key1 y key2 son las claves que participan en la operación; se pueden especificar múltiples claves.
3. Segundo tipo de datos de Redis: tipo hash:
Redis almacena en forma de diccionario (array asociativo), una clave corresponde a un valor. En el tipo string, el valor solo puede ser una cadena. En el tipo hash, también llamado tipo hash, el valor corresponde a un diccionario (array asociativo). Entonces se puede entender que en el tipo hash de Redis, el valor correspondiente a una clave es un array bidimensional. Pero el valor de un campo solo puede ser una cadena. Es decir, solo puede ser un array bidimensional, no puede tener más dimensiones.
4. Comandos de datos de Redis para el tipo hash:
- 1) Asignación: HSET key field value. Por ejemplo, hset user name lane. hset user age 23
- 2) Obtención: HGET key field. Por ejemplo, hget user name, devuelve lane.
- 3) Asignar múltiples campos de la misma clave: HMSET key field1 value1 field2 value2...
- 4) Obtener múltiples campos de la misma clave: HMGET key field1 field2...
- 5) Obtener todos los campos y valores de una clave: HGETALL key. Por ejemplo, HGETALL user devuelve name lane age 23. Cada valor devuelto es una línea independiente.
- 6) Verificar si existe un campo: HEXISTS key field. Devuelve 1 si existe, 0 si no existe.
- 7) Asignar solo si el campo no existe: HSETNX key field value. Si el campo field bajo la clave no existe, se crea el campo field con el valor value. Si el campo field existe, no se realiza ninguna operación. Su efecto equivale a HEXISTS + HSET. Pero la ventaja de este comando es que es una operación atómica. No hay que temer ni a la concurrencia más alta.
- 8) Incremento en N: HINCREBY key field increment. Igual que el incremento del tipo string, no se explica de nuevo.
- 9) Eliminar campos: DEL key field1 field2... Elimina uno o más campos de la clave especificada.
- 10) Obtener solo los nombres de los campos: HKEYS key. Similar a HGETALL, pero solo obtiene los nombres de los campos, no los valores.
- 11) Obtener solo los valores de los campos: HVALS key. Similar a HGETALL, pero solo obtiene los valores, no los nombres.
- 12) Obtener el número de campos: HLEN key.
5. Tercer tipo de datos de Redis: tipo lista
El tipo lista almacena una lista ordenada de cadenas. La operación común es insertar nuevos elementos en ambos extremos. La complejidad temporal es O(1). La estructura es una lista enlazada. Registra las direcciones de la cabeza y la cola. Al ver esto, surge un papel importante del tipo lista de Redis: la cola. Las nuevas solicitudes se insertan al final, y las procesadas se eliminan desde la cabeza. Además, por ejemplo, las novedades de Weibo, como los registros. El tipo lista es un array cuyo índice comienza en 0. Debido al almacenamiento en lista enlazada, cuanto más cerca de la cabeza y la cola esté el elemento, más rápida será la operación; cuanto más cerca del centro, más lenta.
6. Comandos de datos de Redis para el tipo lista:
- 1) Insertar al principio: LPUSH key value1 value2... Devuelve la longitud de la lista después de la inserción.
- 2) Inserción por la cola: RPUSH key value1 value2... Devuelve la longitud de la lista después de la inserción.
- 3) Extracción por la cabeza: LPOP key. Devuelve el valor del elemento extraído. Esta operación primero elimina el primer elemento de la lista key y luego lo devuelve.
- 4) Extracción por la cola: RPOP key. Devuelve el valor del elemento extraído.
- 5) Número de elementos de la lista: LLEN key. Si key no existe, devuelve 0.
- 6) Obtener el subconjunto de la lista: LRANGE start end. Devuelve la lista de los elementos desde el índice start hasta el índice end. Incluye start y end. Admite índices negativos. -1 indica el último elemento, -2 indica el penúltimo elemento.
- 7) Eliminar valores específicos de la lista: LREM key count value. Elimina de la lista key todos los elementos con valor value, pero solo elimina count. Si hay count+1, conserva el último. Si count no existe o es 0, elimina todos. Si count es mayor que 0, elimina count elementos de principio a fin; si count es menor que 0, elimina count elementos de fin a principio.
- 8) Obtener el valor por índice: LINDEX key index. Por ejemplo, LINDEX key 0 es el primer elemento de la lista. index puede ser negativo.
- 9) Establecer índice y valor: LSET key index value. Esta operación solo modifica el valor del índice especificado en la key especificada. Si el index no existe, devuelve un error.
- 10) Conservar un segmento, eliminar el resto: LTRIM key start end. Conserva todos los elementos entre start y end, incluidos start y end. Elimina todo lo demás.
- 11) Insertar un elemento en la lista: LINSERT key BEFORE/AFTER value1 value2. Recorre desde el principio de la lista, se detiene al encontrar el valor value1, inserta value2, y según BEFORE o AFTER lo inserta antes o después de value1.
- 12) Transferir un elemento de una lista a otra: RPOPLPUSH list1 list2. Elimina el elemento de la derecha de la lista list1 e inserta ese elemento en la izquierda de la lista list2. Operación atómica.
7. Cuarto tipo de datos de Redis: tipo conjunto:
El tipo de conjunto está diseñado para facilitar operaciones y cálculos sobre múltiples conjuntos. Cada elemento del conjunto es diferente y no tiene concepto de orden; cada elemento es, y solo puede ser, una cadena. Las operaciones comunes son inserción, eliminación, verificación, etc. La complejidad temporal es O(1). Se pueden realizar operaciones de intersección, unión y diferencia. Por ejemplo, el artículo 1 tiene 3 etiquetas, almacenadas en un tipo de conjunto de Redis. El artículo 2 tiene 3 etiquetas, almacenadas en un tipo de conjunto de Redis. El artículo 1 es sobre mysql, el artículo 2 es sobre redis. Entonces, ¿la intersección no daría como resultado una base de datos? (Suponiendo que la etiqueta 'base de datos' esté presente en ambos artículos). El almacenamiento del tipo de conjunto en Redis es una tabla hash con valores vacíos.
8. Comandos de datos de Redis para el tipo conjunto:
- 1) Agregar: SADD key value.
- 2) Eliminar: SREM key value.
- 3) Obtener todos los elementos del conjunto especificado: SMEMBERS key.
- 4) Determinar si un elemento existe: SISMEMBER key value.
- 5) Operación de diferencia: SDIFF key1 key2... Realiza la operación de diferencia sobre múltiples conjuntos.
- 6) Operación de intersección: SINNER key1 key2... Realiza la operación de intersección sobre múltiples conjuntos.
- 7) Operación de unión: SUNION key1 key2... Realiza la operación de unión sobre múltiples conjuntos.
- 8) Obtener el número de elementos del conjunto: SCARD key. Devuelve el número total de elementos del conjunto.
- 9) Almacenar el resultado de las operaciones de diferencia, intersección y unión en una key especificada: SDIFFSTORE storekey key1 key2. Calcula la diferencia entre key1 y key2, y almacena el resultado en el conjunto con key storekey. SINNERSTORE y SUNIONSTORE son similares.
- 10) Obtener un elemento aleatorio del conjunto: SRANDMEMBER key [count]. El parámetro count es opcional; si count no existe, devuelve uno aleatorio. Si count es mayor que 0, devuelve count elementos no repetidos. Si count es menor que 0, devuelve un total de |count| elementos, que pueden repetirse.
- 11) Extraer aleatoriamente un elemento: SPOP key. Extrae y elimina aleatoriamente un elemento del conjunto y devuelve su valor.
9. Quinto tipo de datos de Redis: tipo conjunto ordenado:
El tipo de conjunto es desordenado y cada elemento es único. El conjunto ordenado, por su parte, es ordenado y cada elemento es único. La diferencia entre el tipo de conjunto ordenado y el tipo de conjunto es que el conjunto ordenado asigna a cada elemento un atributo: la puntuación (score). El conjunto ordenado se ordena según la puntuación. El conjunto ordenado se implementa mediante una tabla hash y una tabla de saltos (skip list). Por lo tanto, en comparación con las listas, la velocidad de operar sobre elementos intermedios también es muy rápida. La complejidad temporal es O(log(N)). El tipo de conjunto ordenado en los tipos de datos de Redis consume más recursos que el tipo de lista en los tipos de datos de Redis.
10. Comandos de datos de Redis para el tipo conjunto ordenado
- 1) Agregar: ZADD key sorce1 value1 sorce2 value2...
- 2) Obtener la puntuación: ZSCORE key value. Obtiene la puntuación del elemento con valor value en el conjunto ordenado de la key.
- 3) Obtener la lista de elementos clasificados en un rango: ZRANFGE key start stop [WITHSCORE]. Obtiene la lista de elementos entre las posiciones start y end, incluyendo start y end (los dos elementos). Cada elemento en una línea. Si se incluye el parámetro WITHSCORE, una línea para el valor del elemento y una línea para la puntuación. La complejidad temporal es O(LOGn+m). Si las puntuaciones son iguales, entonces 0<0.
- 4) Obtener los elementos dentro de un rango de puntuación especificado: ZRANGEBYSCORE key min max [WITHSCORE] [LIMIT offset count]. Obtiene la lista de elementos cuya puntuación está entre min y max. Incluye ambos extremos. Cada elemento en una línea. Si se incluye el parámetro WITHSCORE, una línea para el valor del elemento y una línea para la puntuación. Si min es mayor que max, el orden se invierte.
- 5) Incrementar la puntuación de un elemento: ZINCRBY key increment value. La puntuación del elemento con valor value en el conjunto ordenado especificado se incrementa en increment. Devuelve la puntuación modificada.
- 6) Obtener el número de elementos del conjunto: ZCARD key.
- 7) Obtener el número de elementos dentro de un rango de puntuación especificado: ZCOUNT key min max.
- 8) Eliminar uno o más elementos: ZREM key value1 value2...
- 9) Eliminar elementos según el rango: ZREMRANGEBYRANK key start end. Elimina los elementos cuya clasificación esté entre start y end.
- 10) Eliminar elementos según el rango de puntuación: ZREMRANGEBYSCORE key min max.
- 11) Obtener la clasificación de un elemento (orden ascendente): ZRANK key value. Obtiene la clasificación de value en el conjunto, de menor a mayor.
- 12) Obtener la clasificación de un elemento (orden descendente): ZREVRANK key value. Obtiene la clasificación de value en el conjunto, de mayor a menor.
- 13) Intersección de conjuntos ordenados: ZINTERSTORE storekey key1 key2...[WEIGHTS weight [weight..]] [AGGREGATE SUM|MIN|MAX]. Se utiliza para calcular la intersección de múltiples conjuntos, y el resultado se almacena en storekey. El valor de retorno es el número de elementos de storekey. Si AGGREGATE es SUM, la puntuación de cada elemento del conjunto storekey es la suma de las puntuaciones de los conjuntos participantes. MIN es el valor mínimo de las puntuaciones participantes. MAX es el valor máximo de las puntuaciones participantes. WEIGHTS establece el peso de cada conjunto, por ejemplo, WEIGHTS 1 0.1. Entonces la puntuación de cada elemento del conjunto A se multiplica por 1, y la puntuación de cada elemento del conjunto B se multiplica por 0.1.
- 14) Unión de conjuntos ordenados: ZUNIONSTORE storekey key1 kye2...[WEIGHTS weight [weight..]] [AGGREGATE SUM|MIN|MAX]