Les types de données Redis se divisent en : type chaîne, type hachage, type liste, type ensemble, type ensemble trié.
Redis est si populaire ; à quelle vitesse fonctionne-t-il ? Un ordinateur portable ordinaire peut effectuer 100,000 opérations de lecture/écriture en une seconde.
Opération atomique : la plus petite unité d'opération qui ne peut pas être divisée davantage. C'est-à-dire la plus petite unité d'exécution qui ne sera pas interrompue par d'autres commandes. En cas de forte concurrence, il n'y a pas de condition de course.
Nommage des KEY : une bonne suggestion est d'utiliser article:1:title pour stocker le titre de l'article avec l'ID 1.
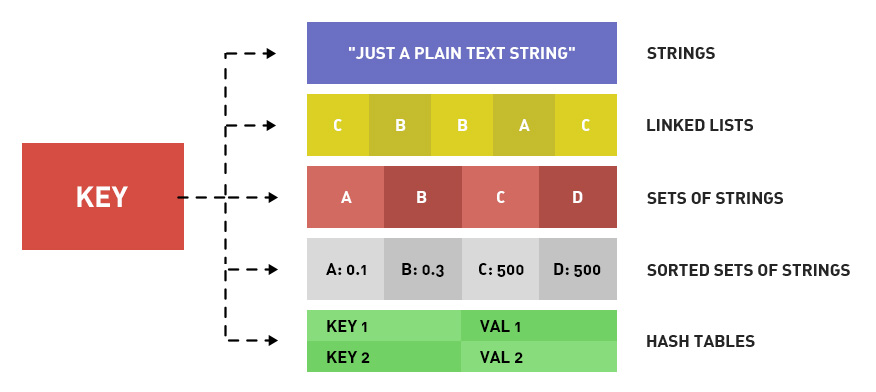
I. Introduction
- 1. Obtenir la liste des clés : KEYS pattern. Les caractères génériques incluent ? * [] et l'échappement \.
- 2. Savoir si une clé existe : EXISTS key. Renvoie 1 si elle existe, 0 sinon.
- 3. Créer une clé et supprimer une clé : SET key et DEL key.
- 4. Obtenir le type de données Redis stocké par la clé en fonction de la clé : TYPE key. Le retour est string, list, hash, set, zset. Ci-dessous, nous expliquerons ces 5 types de données Redis renvoyés un par un.
- 5. rename oldkey newkey : Renommer la clé. Si newkey existe, elle sera écrasée.
- 6. renamenx oldkey newkey : Renommer la clé. Si newkey existe, elle ne sera pas écrasée.
- 7. randomkey : Renvoyer une clé aléatoirement.
- 8. move key db-index : Déplacer la clé vers la base de données spécifiée. Si la clé n'existe pas ou se trouve déjà dans cette base de données, renvoie 0. Renvoie 1 en cas de succès.
II. Types de données Redis Commandes de données Redis
1. Type de données Redis 1 : Type String : C'est facile à comprendre ; une clé stocke une chaîne. Et si vous voulez stocker des données ? Convertissez-les en JSON ou en une autre sérialisation de chaîne.
2. Commandes de données Redis 1 : Type String :
- 1) Affectation : SET key value. Par exemple, set hello world
- 2) Récupération : GET key. Par exemple, get hello. La valeur retournée est world
- 3) Incrémentation : INCR key. C'est l'AUTO_INCREMENT de MySQL. Chaque fois que INCR key est exécuté, la valeur de cette clé augmente de 1. Si la clé n'existe pas, on crée d'abord un 0, puis +1, en retournant 1. Si la valeur n'est pas un entier, une erreur est signalée. Cette opération est atomique.
- 4) Décrémentation : DECR key. Diminue de 1 la valeur de la clé spécifiée. Par exemple, DECR num signifie num-1
- 5) Incrémentation de N : INCRBY key increment. Utilisé pour ajouter increment à la valeur de la clé spécifiée. Par exemple, INCRBY num 5 signifie num+5
- 6) Décrémentation de N : DECRBY key increment. Utilisé pour soustraire increment de la valeur de la clé spécifiée. Par exemple, DECRBY num 5 signifie num-5
- 7) Augmenter d'un flottant : INCRBYFLOAT key increment.
- 8) Ajouter à la fin : APPEND key value. Par exemple, set test:key 123, append test:key 456, get test:key donne 123456
- 9) Obtenir la longueur : STRLEN key.
- 10) Affecter des valeurs à plusieurs clés en même temps : MSET title Ceci est le titre description Ceci est la description content Ceci est le contenu.
- 11) Obtenir les valeurs de plusieurs clés en même temps : MGET title description content
- 12) Opération sur les bits - get : GETBIT key offset. Par exemple, le caractère a est stocké comme 01100001 (ASCII 98) dans Redis, alors GETBIT key 2 renvoie 1, GET key 0 renvoie 0.
- 13) Opération sur les bits - définition : SETBIT key offset value. Par exemple, le caractère a est stocké sous la forme 01100001 (ASCII 98) dans Redis, puis SETBIT key 6 0, SETBIT key 5 1, puis get key renvoie b. Parce que le binaire récupéré est 01100010.
- 14) Opération sur les bits - comptage : BITCOUNT key [start] [end]. BITCOUNT key est utilisé pour obtenir le nombre de bits qui valent 1 dans la valeur de la clé. BITCOUNT key start end est utilisé pour compter le nombre de bits qui valent 1 dans le binaire de la sous-chaîne entre start et end dans la valeur de la clé (c'est déroutant).
- 15) Opération sur les bits - opérations bit à bit : BITOP operation resultKey key1 key2. operation est une opération bit à bit, incluant AND, OR, XOR, NOT. resultKey stocke le résultat de l'opération dans cette clé. key1 et key2 sont les clés impliquées dans l'opération. Plusieurs clés peuvent être spécifiées pour l'opération.
3. Type de données Redis 2 : Type Hash :
Redis stocke les données sous la forme d'un dictionnaire (tableau associatif), où une clé correspond à une valeur. Dans le type string, la valeur ne peut être qu'une chaîne. Ensuite, dans le type hash (aussi appelé type hash), la valeur correspond également à un dictionnaire (tableau associatif). On peut donc comprendre que dans le type hash/type hash de Redis, la valeur correspondant à une clé est un tableau à deux dimensions. Mais les valeurs des champs ne peuvent être que des chaînes. C'est-à-dire qu'il ne peut s'agir que d'un tableau à deux dimensions, et qu'il ne peut pas avoir plus de dimensions.
4. Commandes de données Redis 2 : Type Hash :
- 1) Affectation : HSET key field value. Par ex., hset user name lane. hset user age 23
- 2) Récupération : HGET key field. Par ex., hget user name renvoie lane.
- 3) Affecter des valeurs à plusieurs champs de la même clé : HMSET key field1 value1 field2 value2...
- 4) Obtenir les valeurs de plusieurs champs de la même clé : HMGET key field1 fields2...
- 5) Obtenir tous les champs et toutes les valeurs de la clé : HGETALL key. Par exemple, HGETALL user renvoie name lane age 23. Chaque retour est sur une ligne séparée.
- 6) Savoir si un champ existe : HEXISTS key field. Renvoie 1 s'il existe, 0 sinon.
- 7) Attribuer une valeur lorsque le champ n'existe pas : HSETNX key field value. Si le champ sous la clé n'existe pas, créez le champ avec la valeur. Si le champ existe, aucune opération n'est effectuée. Son effet équivaut à HEXISTS + HSET. Mais l'avantage de cette commande est qu'il s'agit d'une opération atomique. Peu importe le niveau de concurrence, il n'y a pas lieu de craindre.
- 8) Incrémenter de N : HINCREBY key field increment. Identique au type d'incrémentation de chaîne, sans plus de détails.
- 9) Supprimer des champs : DEL key field1 field2... Supprime un ou plusieurs champs de la clé spécifiée.
- 10) Obtenir uniquement les noms de champs : HKEYS key. Similaire à HGETALL, mais obtient uniquement les noms de champs, pas les valeurs de champs.
- 11) Obtenir uniquement les valeurs de champs : HVALS key. Similaire à HGETALL, mais obtient uniquement les valeurs de champs, pas les noms de champs.
- 12) Obtenir le nombre de champs : HLEN key.
5. Type de données Redis 3 : Type liste
Le type liste stocke une liste ordonnée de chaînes. Les opérations courantes consistent à insérer de nouveaux éléments aux deux extrémités. La complexité temporelle est O(1). La structure est une liste chaînée, enregistrant les adresses de la tête et de la queue. En voyant cela, un rôle majeur du type liste des types de données Redis est sur le point d'apparaître, à savoir une file d'attente. Les nouvelles requêtes sont insérées à la queue, et celles traitées sont supprimées de la tête. De plus, par exemple, les actualités récentes de Weibo. Par exemple, les journaux. Le type liste est un tableau dont les indices commencent à 0. Comme il est stocké sous forme de liste chaînée, plus on se rapproche de la tête et de la queue, plus l'opération est rapide ; plus on se rapproche du milieu, plus elle est lente.
6. Commandes de données Redis 3 : Type liste :
- 1) Insérer en tête : LPUSH key value1 value2... Renvoie la longueur de la liste après l'ajout.
- 2) Insérer en queue : RPUSH key value1 value2... . Renvoie la longueur de la liste après l'ajout.
- 3) Extraire depuis la tête : LPOP key. Renvoie la valeur de l'élément extrait. Cette opération supprime d'abord le premier élément de la liste associée à la clé, puis le renvoie.
- 4) Dépiler depuis la queue : RPOP key. Renvoie la valeur de l'élément dépilé.
- 5) Nombre d'éléments de la liste : LLEN key. Renvoie 0 si key n'existe pas.
- 6) Obtenir une sous-liste de la liste : LRANGE start end. Renvoie la liste des éléments du start-ième au end-ième, start et end inclus. Prend en charge les indices négatifs. -1 représente le dernier élément, -2 représente l'avant-dernier élément.
- 7) Supprimer des valeurs spécifiées dans la liste : LREM key count value. Supprime tous les éléments dont la valeur est égale à value dans la liste associée à key, mais seuls count éléments sont supprimés. S'il y a count+1 éléments, alors le dernier est conservé. Si count n'existe pas ou vaut 0, supprimer tout. Si count > 0, supprimer count éléments de la tête vers la queue ; si count < 0, supprimer count éléments de la queue vers la tête.
- 8) Obtenir la valeur à l'index spécifié : LINDEX key index. Par exemple, LINDEX key 0 obtient le premier élément de la liste. index peut être négatif.
- 9) Définir l'index et la valeur : LSET key index value. Cette opération modifie uniquement la valeur à l'index spécifié pour la key donnée. Si index n'existe pas, une erreur est signalée.
- 10) Conserver une tranche et supprimer le reste : LTRIM key start end. Conserve tous les éléments entre start et end, start et end inclus. Supprime tous les autres.
- 11) Insérer un élément dans une liste : LINSERT key BEFORE/AFTER value1 value2. Parcourt depuis la tête de la liste, s'arrête lorsqu'une valeur égale à value1 est trouvée, puis insère value2, soit avant soit après value1 selon BEFORE ou AFTER.
- 12) Déplacer un élément d'une liste vers une autre : RPOPLPUSH list1 list2. Supprime l'élément le plus à droite de list1 et insère cet élément du côté gauche de list2. Opération atomique.
7. Type de données Redis 4 : Type Set :
Le type set est conçu pour des opérations et des calculs pratiques sur plusieurs ensembles. Chaque élément d'un ensemble est unique et n'a pas de notion d'ordre ; chaque élément est et ne peut être qu'une chaîne. Les opérations courantes sont l'insertion, la suppression, le test d'appartenance, etc. La complexité temporelle est O(1). Il prend en charge les opérations d'intersection, d'union et de différence. Par exemple, l'article 1 a 3 tags, stockés sous forme de type set Redis. L'article 2 a 3 tags, stockés sous forme de type set Redis. L'article 1 porte sur MySQL, et l'article 2 porte sur Redis. Alors l'intersection ne produit-elle pas une base de données ? (en supposant que le tag "database" existe dans les deux articles). Un type set dans Redis est stocké sous forme de table de hachage avec des valeurs nulles.
8. Commandes de données Redis 4 : type Set :
- 1) Ajouter : SADD key value.
- 2) Supprimer : SREM key value.
- 3) Obtenir tous les éléments de l'ensemble spécifié : SMEMBERS key.
- 4) Vérifier si un élément existe : SISMEMBER key value.
- 5) Opération de différence : SDIFF key1 key2... . Effectue une opération de différence sur plusieurs ensembles.
- 6) Opération d'intersection : SINNER key1 key2... . Effectue une opération d'intersection sur plusieurs ensembles.
- 7) Opération d'union : SUNION key1 key2... . Effectue une opération d'union sur plusieurs ensembles.
- 8) Obtenir le nombre d'éléments dans un ensemble : SCARD key. Renvoie le nombre total d'éléments dans l'ensemble.
- 9) Stocker le résultat d'une opération de différence, d'intersection ou d'union dans une clé spécifiée : SDIFFSTORE storekey key1 key2. Calcule la différence entre key1 et key2, et stocke le résultat dans l'ensemble avec la clé storekey. SINNERSTORE et SUNIONSTORE sont similaires.
- 10) Obtenir des éléments aléatoires d'un ensemble : SRANDMEMBER key [count]. Le paramètre count est facultatif ; si count n'est pas fourni, renvoie un élément aléatoire. Si count > 0, renvoie count éléments distincts. Si count < 0, renvoie un total de |count| éléments, avec des doublons autorisés.
- 11) Retirer aléatoirement un élément : SPOP key. Retire aléatoirement un élément de l'ensemble, le supprime et renvoie la valeur de cet élément.
9. Type de données Redis 5 : Type ensemble trié :
Le type ensemble est non ordonné, et chaque élément est unique. Un ensemble trié, en revanche, est ordonné, et chaque élément est unique. La différence entre le type ensemble trié et le type ensemble est que l'ensemble trié attribue un attribut à chaque élément : score. L'ensemble trié est trié par score. L'ensemble trié est implémenté à l'aide de tables de hachage et de listes à saut. Par conséquent, par rapport aux listes, les opérations sur les éléments du milieu sont également très rapides. La complexité temporelle est O(log(N)). Dans les types de données Redis, le type ensemble trié consomme plus de ressources que le type liste.
10. Commandes de données Redis 5 : Type ensemble trié
- 1) Ajouter : ZADD key sorce1 value1 sorce2 value2... .
- 2) Obtenir le score : ZSCORE key value. Obtient le score de l'élément ayant la valeur value dans l'ensemble trié de key.
- 3) Obtenir la liste des éléments classés dans un intervalle : ZRANFGE key start stop [WITHSCORE]. Obtient la liste des éléments dont le rang est compris entre start et stop, bornes incluses. Chaque élément est sur une ligne. Si le paramètre WITHSCORE est inclus, alors une ligne pour la valeur de l'élément et une ligne pour le score. La complexité temporelle est O(log n + m). Si les scores sont identiques, alors 0<0.
- 4) Obtenir les éléments dans un intervalle de score spécifié : ZRANGEBYSCORE key min max [WITHSCORE] [LIMIT offset count]. Obtient la liste des éléments dont les scores sont compris entre min et max, bornes incluses. Chaque élément est sur une ligne. Si le paramètre WITHSCORE est inclus, alors une ligne pour la valeur de l'élément et une ligne pour le score. Si min est supérieur à max, l'ordre est inversé.
- 5) Augmenter le score d'un élément : ZINCRBY key increment value. Le score de l'élément ayant la valeur value dans l'ensemble trié spécifié est incrémenté de increment. Renvoie le score après la modification.
- 6) Obtenir le nombre d'éléments dans l'ensemble : ZCARD key.
- 7) Obtenir le nombre d'éléments dans une plage de scores spécifiée : ZCOUNT key min max.
- 8) Supprimer un ou plusieurs éléments : ZREM key value1 value2...
- 9) Supprimer des éléments par plage de rangs : ZREMRANGEBYRANK key start end. Supprime les éléments classés entre start et end.
- 10) Supprimer des éléments par plage de scores : ZREMRANGEBYSCORE key min max.
- 11) Obtenir le rang d'un élément (croissant) : ZRANK key value. Obtient le rang de value dans l'ensemble, du plus petit au plus grand.
- 12) Obtenir le rang d'un élément (décroissant) : ZREVRANK key value. Obtient le rang de value dans l'ensemble, du plus grand au plus petit.
- 13) Intersection d'ensembles triés : ZINTERSTORE storekey key1 key2...[WEIGHTS weight [weight..]] [AGGREGATE SUM|MIN|MAX]. Utilisé pour calculer l'intersection de plusieurs ensembles, avec le résultat stocké dans storekey. La valeur de retour est le nombre d'éléments dans storekey. Si AGGREGATE est SUM, alors le score de chaque élément dans l'ensemble storekey est la somme des scores des ensembles participants. MIN est le minimum des scores participants. MAX est le maximum des scores participants. WEIGHTS définit le poids pour chaque ensemble, par exemple, WEIGHTS 1 0.1. Ensuite, le score de chaque élément de l'ensemble A est multiplié par 1, et le score de chaque élément de l'ensemble B est multiplié par 0.1.
- 14) Union d'ensembles triés : ZUNIONSTORE storekey key1 kye2...[WEIGHTS weight [weight..]] [AGGREGATE SUM|MIN|MAX]