In möglichst kurzer Form werden die Eigenschaften, Implementierungsmethoden und die Performance aller Collections und Concurrent Collections behandelt. Geeignet für alle, die behaupten, "Java zu beherrschen", aber noch nicht ganz selbstsicher sind.
ListeArrayList
Mit einem Array implementiert. Spart Speicherplatz, aber Arrays haben Kapazitätsgrenzen. Wenn das Limit überschritten wird, wird die Kapazität um 50% erhöht, und System.arraycopy() wird verwendet, um in ein neues Array zu kopieren, daher ist es am besten, eine geschätzte Array-Größe anzugeben. Standardmäßig wird beim Einfügen des ersten Elements ein Array der Größe 10 erstellt.
Zugriff auf Elemente über den Array-Index – get(i)/set(i,e) hat hohe Performance; das ist der grundlegende Vorteil von Arrays.
Das direkte Hinzufügen eines Elements am Ende des Arrays – add(e) – hat ebenfalls hohe Performance. Wenn Sie jedoch nach Index einfügen oder löschen – add(i,e), remove(i), remove(e) – müssen Sie System.arraycopy() verwenden, um die betroffenen Elemente zu verschieben, wodurch die Performance sinkt; das ist der grundlegende Nachteil.
LinkedList
Als doppelt verkettete Liste implementiert. Die verkettete Liste hat keine Kapazitätsgrenze, aber die doppelt verkettete Liste selbst benötigt mehr Speicher und erfordert zusätzliche Zeigeroperationen der verketteten Liste.
Der Zugriff auf Elemente über den Index – get(i)/set(i,e) – erfordert leider ein Durchlaufen der verketteten Liste, um den Zeiger an die Position zu bewegen (wenn i größer als die halbe Listengröße ist, wird vom Ende aus bewegt).
Beim Einfügen oder Löschen von Elementen müssen Sie nur die Zeiger der vorherigen und der nachfolgenden Knoten ändern, aber Sie müssen trotzdem einen Teil der verketteten Liste durchlaufen, um an die durch den Index angegebene Position zu gelangen. Nur Operationen an den beiden Enden der Liste – add(), addFirst(), removeLast() oder remove() auf iterator() – können Zeigerbewegungen vermeiden.
CopyOnWriteArrayList
Nebenläufigkeitsoptimierte ArrayList. Verwendet die CopyOnWrite-Strategie: Beim Ändern wird zuerst ein Snapshot zum Ändern kopiert, und nach der Änderung wird der interne Zeiger auf das neue Array gesetzt.
Da Änderungen am Snapshot für Leseoperationen unsichtbar sind, gibt es nur eine Schreibsperre und keine Lesesperre. Zusammen mit den hohen Kopierkosten ist es typischerweise für Szenarien mit vielen Lese- und wenigen Schreibzugriffen geeignet. Wenn die Aktualisierungsfrequenz hoch oder das Array groß ist, ist Collections.synchronizedList(list) besser, da für alle Operationen dieselbe Sperre verwendet wird, um Thread-Sicherheit zu gewährleisten.
Fügt eine Methode addIfAbsent(e) hinzu, die das Array durchläuft, um zu prüfen, ob das Element bereits existiert; wie zu erwarten, ist die Performance nicht besonders gut.
Ergänzung
Unabhängig von der Implementierung erfordert das Finden des Index anhand des Werts – contains(e), indexOf(e), remove(e) – das Durchlaufen aller Elemente zum Vergleich; wie man sich vorstellen kann, ist die Leistung nicht sehr gut.
Es gibt keine nach Elementwert sortierte SortedList, und unter den threadsicheren Klassen gibt es keine ConcurrentLinkedList mit einem lockfreien Algorithmus. Wenn man sich mit den äquivalenten Klassen in Set und Queue behelfen muss, vermisst man einige List-spezifische Methoden.
Map
HashMap
Ein Hash-Bucket-Array, implementiert als Entry[]-Array. Man verwendet den Hash-Wert des Key modulo der Größe des Bucket-Arrays, um den Array-Index zu erhalten.
Wenn beim Einfügen eines Elements zwei Keys in denselben Bucket fallen (zum Beispiel gehören die Hash-Werte 1 und 17 nach Modulo 16 beide zum ersten Hash-Bucket), verwendet Entry eine next-Eigenschaft, um mehrere Entries in einer einfach verketteten Liste zu speichern. Der Entry, der später in den Bucket gelangt, richtet sein next auf den aktuellen Entry des Buckets.
Wenn man einen Key mit Hash-Wert 17 sucht, lokalisiert man zuerst den ersten Hash-Bucket und durchläuft dann alle Elemente im Bucket über die verknüpfte Liste, wobei man ihre Key-Werte nacheinander vergleicht.
Wenn die Anzahl der Entries 75% der Anzahl der Buckets erreicht (viele Artikel sagen, die Anzahl der verwendeten Buckets erreiche 75%, aber wenn man sich den Code ansieht, stimmt das nicht), wird das Bucket-Array exponentiell erweitert, und alle ursprünglichen Entries werden neu gehasht. Also ist es hier auch am besten, einen geschätzten Wert zu haben.
Die Verwendung der bitweisen Operation (hash & (arrayLength-1)) für Modulo ist schneller, daher ist die Array-Größe immer eine Zweierpotenz. Wenn man beiläufig einen Anfangswert wie 17 angibt, wird er in 32 umgewandelt. Standardmäßig ist der Anfangswert, wenn das erste Element eingefügt wird, 16.
Beim Iterieren mit iterator() durchläuft es das Hash-Bucket-Array, was ungeordnet aussieht.
In JDK 8 hat ein neuer Schwellenwert standardmäßig den Wert 8. Wenn die Entries in einem Bucket den Schwellenwert überschreiten, werden sie in einem Rot-Schwarz-Baum anstelle einer einfach verketteten Liste gespeichert, um die Key-Suche zu beschleunigen.
LinkedHashMap
Erweitert HashMap um die Implementierung einer doppelt verketteten Liste; sie gilt als die speicherhungrigste Datenstruktur. Sie unterstützt das Sortieren nach der Entry-Einfügereihenfolge beim Iterieren mit iterator() (Aktualisierungen zählen jedoch nicht; wenn die Eigenschaft accessOrder auf true gesetzt ist, zählen alle Lese- und Schreibzugriffe).
In der Implementierung werden before/after-Zeiger zu Entry hinzugefügt. Beim Einfügen fügt man sich selbst vor dem Header Entry ein. Wenn alle Lese- und Schreibzugriffe geordnet werden müssen, muss man außerdem die before/after-Zeiger der vorhergehenden und nachfolgenden Entries neu verbinden, um sich selbst aus der verketteten Liste zu entfernen.
TreeMap
Mit einem Rot-Schwarz-Baum implementiert. Aus Platzgründen sieheEinführendes TutorialUnterstützt das Sortieren nach Key-Wert beim Iterieren mit iterator(); sie kann aufsteigend nach Keys sortieren, die das Comparable-Interface implementieren, oder durch einen übergebenen Comparator gesteuert werden. Wie man sich vorstellen kann, sind die Kosten für das Einfügen/Löschen von Elementen im Baum definitiv höher als bei HashMap.
Unterstützt die SortedMap-Schnittstelle, wie z. B. firstKey(), lastKey() zum Abrufen des kleinsten und größten Schlüssels, oder sub(fromKey, toKey), tailMap(fromKey), um einen Abschnitt der Map herauszuschneiden.
ConcurrentHashMap
Für Nebenläufigkeit optimierte HashMap. Standardmäßig hat sie 16 Schreibsperren (es können mehr festgelegt werden), wodurch die Wahrscheinlichkeit einer Blockierung wirksam verteilt wird, und es gibt keine Lesesperre.
Die Datenstruktur ist Segment[]. Innerhalb von Segment befindet sich das Hash-Bucket-Array. Jedes Segment hat eine Sperre. Der Key berechnet zuerst, in welchem Segment er liegt, und dann, in welchem Hash-Bucket er liegt.
Unterstützt die ConcurrentMap-Schnittstelle, wie z. B. putIfAbsent(key, value), das umgekehrte replace(key, value), und replace(key, oldValue, newValue), das CAS implementiert.
Es gibt keine Lesesperre, weil put/remove-Aktionen atomare Aktionen sind (zum Beispiel ist put eine Zuweisungsoperation auf ein Array-Element/einen Entry-Zeiger); Leseoperationen sehen keinen Zwischenzustand einer Aktualisierungsaktion.
ConcurrentSkipListMap
Nebenläufigkeitsoptimierte SortedMap in JDK 6 hinzugefügt, implementiert mit SkipList. SkipList ist eine vereinfachte Alternative zu Rot-Schwarz-Bäumen und ein beliebter Algorithmus für geordnete Sammlungen. Aus Platzgründen sieheEinführungstutorialDas Concurrent-Paket hat es gewählt, weil es CAS-basierte lock-free-Algorithmen unterstützt, während Rot-Schwarz-Bäume keine guten lock-free-Algorithmen haben.
Ganz speziell: Seine size()-Methode kann nicht einfach so aufgerufen werden; sie durchläuft die Struktur, um zu zählen.
Ergänzung
Bezüglich null: HashMap und LinkedHashMap sind tolerant. TreeMap kann keine null-Schlüssel haben, wenn kein Comparator gesetzt ist. In ConcurrentHashMap in JDK 7 darf der Wert nicht null sein (warum ist das so?); in JDK 8 dürfen weder Schlüssel noch Wert null sein. Bei ConcurrentSkipListMap dürfen in allen JDK-Versionen weder Schlüssel noch Wert null sein.
Set
Fast alle Sets werden intern mit einer Map implementiert, weil das KeySet in einer Map ein Set ist und der Wert ein Dummy-Wert ist, wobei alle dasselbe Object verwenden. Die Eigenschaften von Set erben auch die der internen Map-Implementierungen.
- HashSet: Intern ist es eine HashMap.
- LinkedHashSet: Intern ist es eine LinkedHashMap.
- TreeSet: Intern ist es ein SortedSet, implementiert mit TreeMap.
- ConcurrentSkipListSet: Intern ist es ein nebenläufigkeitsoptimiertes SortedSet, implementiert mit ConcurrentSkipListMap.
- CopyOnWriteArraySet: Intern ist es ein nebenläufigkeitsoptimiertes Set, implementiert mit CopyOnWriteArrayList, das seine Methode addIfAbsent() verwendet, um Elemente zu deduplizieren. Wie bereits erwähnt, ist die Leistung dieser Methode mittelmäßig.
Ergänzung: Es scheint, dass ein ConcurrentHashSet fehlt. Es hätte eine einfache Implementierung geben sollen, die intern ConcurrentHashMap verwendet, aber das JDK hat einfach keine bereitgestellt. Jetty hat selbst eines umhüllt, während Guava direkt java.util.Collections.newSetFromMap(new ConcurrentHashMap()) verwendet, um es zu implementieren.
Warteschlange
Queue ist eine Liste, bei der Elemente an den beiden Enden ein- und austreten, daher kann sie auch mit einem Array oder einer verketteten Liste implementiert werden.
– Gewöhnliche Queue –
LinkedList
Ja, eine mit einer doppelt verketteten Liste implementierte LinkedList ist sowohl eine List als auch eine Queue. Sie ist die einzige Queue, die null erlaubt.
ArrayDeque
Eine bidirektionale Queue, implementiert mit einem kreisförmigen Array. Die Größe ist ein Vielfaches von 2, und der Standardwert ist 16.
Ein gewöhnliches Array kann Elemente nur schnell am Ende hinzufügen. Um FIFO zu unterstützen und schnell Elemente vom Kopf zu entnehmen, wird ein kreisförmiges Array benötigt: Es gibt zwei Indizes, head und tail. Beim Entfernen eines Elements wird der head-Index inkrementiert. Beim Hinzufügen eines Elements wird, wenn das Ende des Array-Speicherplatzes erreicht ist, das Element zyklisch dem Array zugewiesen
PriorityQueue
Prioritätswarteschlange, implementiert mit einem binären Heap; sieheEinführendes TutorialSie ist nicht mehr FIFO; stattdessen werden Elemente gemäß dem Vergleichsergebnis der vom Element implementierten Comparable-Schnittstelle oder des übergebenen Comparator ausgereiht. Je kleiner der Wert, desto höher die Priorität und desto früher wird es ausgereiht. Beachten Sie jedoch, dass die Rückgabe von iterator() nicht sortiert.
–Threadsichere Queues–
ConcurrentLinkedQueue/ConcurrentLinkedDeque
Unbegrenzte, nebenläufigkeitsoptimierte Queue, basierend auf einer verketteten Liste, die einen lock-free Algorithmus implementiert, der auf CAS beruht.
Die Struktur von ConcurrentLinkedQueue ist eine einfach verkettete Liste mit head/tail-Zeigern. Da das Einreihen zwei CAS-Operationen erfordert – das Ändern des next-Zeigers des tail-Elements und das Aktualisieren von tail, damit es auf das neue Element zeigt –, die nicht atomar sein können, ist ein spezieller Algorithmus erforderlich. Aus Platzgründen sieheErste-Schritte-Tutorial。
PriorityBlockingQueue
Unbegrenzte, nebenläufigkeitsoptimierte PriorityQueue, ebenfalls auf einem binären Heap basierend. Sie verwendet ein gemeinsames Read-Write-Lock. Obwohl sie das BlockingQueue-Interface implementiert, hat sie eigentlich keine Blocking-Queue-Eigenschaften; sie erweitert sich automatisch, wenn der Speicherplatz nicht ausreicht.
DelayQueue
Enthält intern eine PriorityQueue, ebenfalls unbegrenzt. Elemente müssen das Delayed-Interface implementieren. Jeder Aufruf muss zurückgeben, wie viel Zeit bis zum Auslösezeitpunkt verbleibt; ein Wert kleiner als 0 bedeutet, dass ausgelöst werden soll.
Beim Aufruf von pull() wird peek() verwendet, um das Kopfelement zu prüfen und festzustellen, ob der Auslösezeitpunkt erreicht wurde. ScheduledThreadPoolExecutor verwendet eine ähnliche Struktur.
–Threadsichere blockierende Warteschlangen–
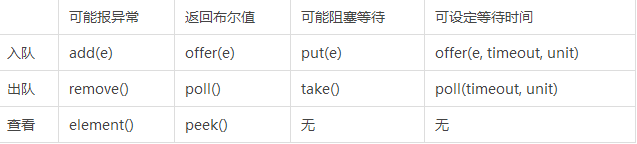
Die Länge einer BlockingQueue ist begrenzt, um sicherzustellen, dass sich die Geschwindigkeiten von Producer und Consumer nicht zu stark unterscheiden und eine Speichererschöpfung vermieden wird. Einmal festgelegt, kann die Warteschlangenlänge nicht geändert werden. Wenn die Warteschlange beim Enqueue voll oder beim Dequeue leer ist, sind die Auswirkungen der verschiedenen Methoden in der folgenden Tabelle dargestellt:
ArrayBlockingQueue
BlockingQueue mit fester Länge und Nebenläufigkeitsoptimierung, implementiert auf Basis eines zirkulären Arrays. Sie hat ein gemeinsames Read-Write-Lock und zwei Conditions, notFull und notEmpty, die die Blockierungszustände verwalten, wenn die Warteschlange voll oder leer ist.
LinkedBlockingQueue/LinkedBlockingDeque
Optional begrenzte, nebenläufigkeitsoptimierte BlockingQueue, implementiert auf Basis einer verketteten Liste, sodass die Länge auf Integer.MAX_VALUE gesetzt werden kann. Unter Ausnutzung der Eigenschaften einer verketteten Liste trennt sie die Sperren takeLock und putLock und verwendet weiterhin notEmpty und notFull, um die Blockierungszustände zu verwalten, wenn die Warteschlange voll oder leer ist.
Ergänzung
JDK7 hat eineLinkedTransferQueueDie Methode transfer(e) garantiert, dass das von Producer eingefügte Element zurückgegeben wird, nachdem Consumer es entnommen hat. Sie ist besser als SynchronousQueue; ich sollte sie mir ansehen, wenn ich Zeit habe.
Quelle: http://www.topthink.com/topic/11679.html