Максимально кратко рассмотрим характеристики, способы реализации и производительность всех коллекций и конкурентных коллекций. Подходит для всех, кто утверждает, что "владеет Java", но пока не совсем уверен в этом.
СписокArrayList
Реализовано с помощью массива. Экономит пространство, но у массивов есть ограничения по вместимости. При превышении лимита вместимость увеличивается на 50%, а System.arraycopy() используется для копирования в новый массив, поэтому лучше заранее указать предполагаемый размер массива. По умолчанию массив размера 10 создаётся при вставке первого элемента.
Доступ к элементам по индексу массива – get(i)/set(i,e) обладает высокой производительностью; это основное преимущество массивов.
Добавление элемента непосредственно в конец массива – add(e) также обладает высокой производительностью. Но если вы вставляете или удаляете по индексу – add(i,e), remove(i), remove(e) – необходимо использовать System.arraycopy() для перемещения затронутых элементов, поэтому производительность снижается; это основной недостаток.
LinkedList
Реализован как двусвязный список. У связного списка нет ограничения по ёмкости, но сам двусвязный список занимает больше места и также требует дополнительных операций с указателями связного списка.
Доступ к элементам по индексу – get(i)/set(i,e), к сожалению, требует обхода связного списка для перемещения указателя в нужную позицию (если i > половины размера списка, он начинает движение с хвоста).
При вставке или удалении элементов нужно только изменить указатели предыдущего и следующего узлов, но всё равно приходится обходить часть связного списка, чтобы добраться до позиции, указанной индексом. Только операции на обоих концах списка – add(), addFirst(), removeLast() или remove() у iterator() – позволяют избежать перемещения указателей.
CopyOnWriteArrayList
ArrayList, оптимизированный для многопоточности. Использует стратегию CopyOnWrite: при изменении сначала копируется снимок для изменения, а после изменения внутренний указатель направляется на новый массив.
Поскольку изменения в снимке невидимы для операций чтения, существует только блокировка записи и отсутствует блокировка чтения. В сочетании с высокой стоимостью копирования это обычно подходит для сценариев с интенсивным чтением и редкой записью. Если частота обновлений высока или массив большой, лучше подходит Collections.synchronizedList(list), использующий одну и ту же блокировку для всех операций, чтобы обеспечить потокобезопасность.
Добавляет метод addIfAbsent(e), который обходит массив, чтобы проверить, существует ли уже элемент; как можно догадаться, производительность не очень хорошая.
Дополнение
Независимо от реализации, поиск индекса по значению – contains(e), indexOf(e), remove(e) – требует обхода всех элементов для сравнения; как можно представить, производительность не очень хорошая.
Не существует SortedList, отсортированного по значению элемента, и среди потокобезопасных классов нет ConcurrentLinkedList с алгоритмом без блокировок. Когда вы обходитесь эквивалентными классами в Set и Queue, вы упустите некоторые методы, специфичные для List.
Map
HashMap
Массив хеш-бакетов, реализованный как массив Entry[]. Используйте значение хеша Key по модулю размера массива бакетов, чтобы получить индекс в массиве.
При вставке элемента, если два Key попадают в один и тот же бакет (например, хеш-значения 1 и 17 после взятия по модулю 16 оба принадлежат первому хеш-бакету), Entry использует свойство next, чтобы хранить несколько Entry в односвязном списке. Entry, попавший в бакет позже, указывает своим next на текущий Entry бакета.
При поиске Key со значением хеша 17 сначала найдите первый хеш-бакет, затем пройдите по всем элементам в бакете через связанный список, сравнивая их значения ключа одно за другим.
Когда количество Entry достигает 75% от количества бакетов (во многих статьях говорится, что количество использованных бакетов достигает 75%, но, судя по коду, это не так), массив бакетов расширяется экспоненциально, и все исходные Entry перехешируются. Поэтому здесь также лучше иметь оценочное значение.
Использование битовой операции (hash & (arrayLength-1)) для взятия по модулю быстрее, поэтому размер массива всегда является степенью 2. Если вы небрежно зададите начальное значение, например 17, оно будет расширено до 32. По умолчанию начальное значение при добавлении первого элемента равно 16.
При итерации с помощью iterator() он проходит вдоль массива хеш-бакетов, что выглядит неупорядоченно.
В JDK 8 новый порог по умолчанию равен 8. Когда количество Entry в бакете превышает порог, они хранятся в красно-чёрном дереве вместо односвязного списка, чтобы ускорить поиск по Key.
LinkedHashMap
Расширяет HashMap путем добавления реализации двусвязного списка; говорят, что это структура данных, потребляющая больше всего памяти. Она поддерживает сортировку по порядку вставки Entry при итерации с помощью iterator() (но обновления не учитываются; если свойство accessOrder установлено в true, то учитываются все обращения на чтение и запись).
В реализации в Entry добавляются указатели before/after. При вставке вы добавляете себя перед Header Entry. Если все обращения на чтение и запись должны быть упорядочены, также нужно перестроить указатели before/after предыдущей и следующей Entry, чтобы удалить себя из связанного списка.
TreeMap
Реализовано с помощью красно-черного дерева. Из-за ограничений по объему см.Вводное руководствоПоддерживает сортировку по значению Key при итерации с помощью iterator(); может сортировать по возрастанию по Keys, реализующим интерфейс Comparable, или управляться переданным Comparator. Как можно представить, стоимость вставки/удаления элементов в дереве определенно выше, чем в HashMap.
Поддерживает интерфейс SortedMap, например firstKey(), lastKey() для получения наименьшего и наибольшего ключей, или sub(fromKey, toKey), tailMap(fromKey) для выделения сегмента Map.
ConcurrentHashMap
HashMap, оптимизированный для параллелизма. По умолчанию у него 16 блокировок записи (можно задать больше), что эффективно распределяет вероятность блокировки, и нет блокировки чтения.
Структура данных — Segment[]. Внутри Segment находится массив хеш-корзин. Каждый Segment имеет одну блокировку. Key сначала вычисляет, в каком Segment он находится, затем вычисляет, в какой хеш-корзине он находится.
Поддерживает интерфейс ConcurrentMap, например putIfAbsent(key, value), противоположный replace(key, value), и replace(key, oldValue, newValue), реализующий CAS.
Блокировки чтения нет, потому что действия put/remove являются атомарными действиями (например, put — это операция присваивания элементу массива/указателю Entry); операции чтения не увидят промежуточное состояние действия обновления.
ConcurrentSkipListMap
Оптимизированный для многопоточности SortedMap, добавленный в JDK 6, реализован с помощью SkipList. SkipList — это упрощённая альтернатива красно-чёрным деревьям и популярный алгоритм упорядоченных коллекций. Из-за ограничений по объёму см.Вводное руководствоПакет Concurrent выбрал его, потому что он поддерживает неблокирующие алгоритмы на основе CAS, тогда как красно-чёрные деревья не имеют хороших неблокирующих алгоритмов.
Довольно специфично: его size() нельзя вызывать просто так; он выполняет обход для подсчёта.
Дополнение
Что касается null: HashMap и LinkedHashMap снисходительны. TreeMap не может иметь null-ключи, когда Comparator не задан. В ConcurrentHashMap в JDK 7 значение не может быть null (почему так?); в JDK 8 ни ключ, ни значение не могут быть null. Для ConcurrentSkipListMap во всех версиях JDK ни ключ, ни значение не могут быть null.
Set
Почти все Set внутри реализованы через Map, потому что KeySet в Map — это Set, а значение — фиктивное значение, все используют один и тот же Object. Характеристики Set также наследуются от внутренних реализаций Map.
- HashSet: внутри — HashMap.
- LinkedHashSet: внутри — LinkedHashMap.
- TreeSet: внутри — SortedSet, реализованный через TreeMap.
- ConcurrentSkipListSet: внутри — SortedSet, оптимизированный для многопоточности, реализованный через ConcurrentSkipListMap.
- CopyOnWriteArraySet: внутри — Set, оптимизированный для многопоточности, реализованный через CopyOnWriteArrayList, использующий его метод addIfAbsent() для устранения дубликатов элементов. Как упоминалось ранее, производительность этого метода посредственна.
Дополнение: Похоже, не хватает ConcurrentHashSet. Должна была быть простая реализация, использующая внутри ConcurrentHashMap, но JDK её просто не предоставил. Jetty обернул свой собственный, а Guava напрямую использует java.util.Collections.newSetFromMap(new ConcurrentHashMap()) для его реализации.
Очередь
Queue — это List, в котором элементы входят и выходят с двух концов, поэтому его также можно реализовать с помощью массива или связного списка.
– Обычная очередь –
LinkedList
Да, LinkedList, реализованный с помощью двусвязного списка, является одновременно List и Queue. Это единственная Queue, допускающая null.
ArrayDeque
Двунаправленная Queue, реализованная с помощью кольцевого массива. Размер кратен 2, по умолчанию — 16.
Обычный массив позволяет быстро добавлять элементы только в конец. Чтобы поддерживать FIFO и быстро извлекать элементы из начала, нужен кольцевой массив: есть два индекса — head и tail. При извлечении элемента индекс head увеличивается. При добавлении элемента, если достигнут конец пространства массива, элемент циклически помещается в массив
PriorityQueue
Очередь с приоритетами, реализованная с помощью двоичной кучи; см.Вводное руководствоОна больше не работает по FIFO; вместо этого элементы извлекаются из очереди в соответствии с результатом сравнения интерфейса Comparable, реализованного элементом, или переданного Comparator. Чем меньше значение, тем выше приоритет и тем раньше элемент извлекается из очереди. Но учтите, что возвращаемое iterator() не сортируется.
–Потокобезопасные очереди–
ConcurrentLinkedQueue/ConcurrentLinkedDeque
Неограниченная конкурентно-оптимизированная Queue, основанная на связанном списке и реализующая lock-free алгоритм, опирающийся на CAS.
Структура ConcurrentLinkedQueue — это односвязный список с указателями head/tail. Поскольку постановка в очередь требует двух операций CAS — изменения указателя next хвостового элемента и обновления tail так, чтобы он указывал на новый элемент — которые не могут быть атомарными, нужен специальный алгоритм. Из-за ограничений по объёму см.Руководство для начинающих。
PriorityBlockingQueue
Неограниченная оптимизированная для конкурентного доступа PriorityQueue, также основанная на двоичной куче. Использует общую блокировку чтения-записи. Хотя она реализует интерфейс BlockingQueue, на самом деле у неё нет характеристик блокирующей очереди; она автоматически расширяется при нехватке места.
DelayQueue
Внутри содержит PriorityQueue, также неограниченную. Элементы должны реализовывать интерфейс Delayed. Каждый вызов должен возвращать, сколько осталось до момента срабатывания; значение меньше 0 означает, что элемент должен сработать.
При вызове pull() он использует peek() для просмотра головного элемента и проверки, достигнуто ли время срабатывания. ScheduledThreadPoolExecutor использует похожую структуру.
–Потокобезопасные блокирующие очереди–
Длина BlockingQueue ограничена, чтобы скорости производителя и потребителя не слишком различались, избегая исчерпания памяти. После установки длина очереди не может быть изменена. Когда очередь заполнена при постановке в очередь или пуста при извлечении из очереди, эффекты различных методов показаны в таблице ниже:
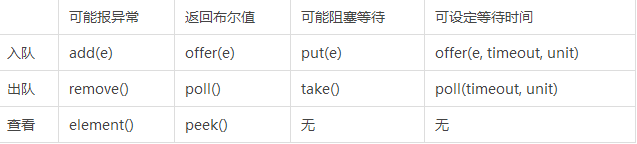
ArrayBlockingQueue
Блокирующая очередь фиксированной длины, оптимизированная для конкурентного доступа, реализованная на основе циклического массива. Имеет общую блокировку чтения-записи и два объекта Condition — notFull и notEmpty, управляющих состояниями блокировки, когда очередь заполнена или пуста.
LinkedBlockingQueue/LinkedBlockingDeque
Необязательно ограниченная блокирующая очередь, оптимизированная для конкурентного доступа, реализованная на основе связного списка, поэтому длину можно установить в Integer.MAX_VALUE. Используя особенности связного списка, она разделяет блокировки takeLock и putLock и продолжает использовать notEmpty и notFull для управления состояниями блокировки, когда очередь заполнена или пуста.
Дополнение
В JDK7 есть одинLinkedTransferQueueМетод transfer(e) гарантирует, что элемент, помещённый Producer, будет возвращён после того, как Consumer его заберёт. Он лучше, чем SynchronousQueue; мне стоит изучить его, когда будет время.
Источник: http://www.topthink.com/topic/11679.html