Dans un espace aussi court que possible, passez en revue les caractéristiques, les méthodes d'implémentation et les performances de toutes les collections et collections concurrentes. Convient à quiconque prétend être « expert en Java » mais n'est pas encore tout à fait sûr de lui.
ListeArrayList
Implémenté avec un tableau. Économise de l'espace, mais les tableaux ont des limites de capacité. Lorsque la limite est dépassée, la capacité est augmentée de 50%, et System.arraycopy() est utilisé pour copier vers un nouveau tableau, il est donc préférable de fournir une taille de tableau estimée. Par défaut, un tableau de taille 10 est créé lors de l'insertion du premier élément.
L'accès aux éléments par index de tableau – get(i)/set(i,e) – est très performant ; c'est l'avantage fondamental des tableaux.
L'ajout d'un élément directement à la fin du tableau – add(e) – est également très performant. Mais si vous insérez ou supprimez par index – add(i,e), remove(i), remove(e) – vous devez utiliser System.arraycopy() pour déplacer les éléments concernés, ce qui dégrade les performances ; c'est l'inconvénient fondamental.
LinkedList
Implémenté sous forme de liste doublement chaînée. La liste chaînée n'a pas de limite de capacité, mais la liste doublement chaînée elle-même utilise plus d'espace et nécessite également des opérations supplémentaires sur les pointeurs de liste chaînée.
L'accès aux éléments par index – get(i)/set(i,e) – nécessite malheureusement de parcourir la liste chaînée pour déplacer le pointeur jusqu'à la position (si i > la moitié de la taille de la liste, il commence à se déplacer depuis la queue).
Lors de l'insertion ou de la suppression d'éléments, vous ne devez modifier que les pointeurs des nœuds précédent et suivant, mais vous devez quand même parcourir une partie de la liste chaînée pour atteindre la position indiquée par l'index. Seules les opérations aux deux extrémités de la liste – add(), addFirst(), removeLast(), ou remove() sur iterator() – peuvent éviter le déplacement des pointeurs.
CopyOnWriteArrayList
ArrayList optimisée pour la concurrence. Utilise la stratégie CopyOnWrite : lors d'une modification, elle copie d'abord un instantané à modifier, puis après la modification, fait pointer le pointeur interne vers le nouveau tableau.
Comme les modifications apportées à l'instantané sont invisibles pour les opérations de lecture, il n'y a qu'un verrou d'écriture et aucun verrou de lecture. Ajouté au coût élevé de la copie, cela convient généralement aux scénarios à forte lecture et faible écriture. Si la fréquence de mise à jour est élevée ou si le tableau est grand, Collections.synchronizedList(list) est préférable, en utilisant le même verrou pour toutes les opérations afin de garantir la sûreté de thread.
Ajoute une méthode addIfAbsent(e), qui parcourt le tableau pour vérifier si l'élément existe déjà ; comme on peut l'imaginer, les performances ne sont pas très bonnes.
Complément
Quelle que soit l'implémentation, trouver l'index par valeur – contains(e), indexOf(e), remove(e) – nécessite de parcourir tous les éléments pour comparaison ; comme on peut l'imaginer, les performances ne sont pas très bonnes.
Il n'existe pas de SortedList triée par valeur d'élément, et il n'existe pas de ConcurrentLinkedList avec un algorithme sans verrou parmi les classes thread-safe. Lorsque vous vous contentez des classes équivalentes dans Set et Queue, vous passerez à côté de certaines méthodes spécifiques à List.
Map
HashMap
Un tableau de buckets de hachage implémenté sous la forme d'un tableau Entry[]. Utilisez la valeur de hachage de la Key modulo la taille du tableau de buckets pour obtenir l'index du tableau.
Lors de l'insertion d'un élément, si deux Keys tombent dans le même bucket (par exemple, les valeurs de hachage 1 et 17 appartiennent toutes deux au premier bucket de hachage après modulo 16), Entry utilise une propriété next pour stocker plusieurs Entries dans une liste simplement chaînée. L'Entry qui entre dans le bucket plus tard fait pointer son next vers l'Entry actuelle du bucket.
Lors de la recherche d'une Key avec la valeur de hachage 17, localisez d'abord le premier bucket de hachage, puis parcourez tous les éléments du bucket via la liste chaînée, en comparant leurs valeurs de clé une par une.
Lorsque le nombre d'Entries atteint 75% du nombre de buckets (beaucoup d'articles disent que le nombre de buckets utilisés atteint 75%, mais en regardant le code, ce n'est pas le cas), le tableau de buckets est agrandi de façon exponentielle, et toutes les Entries d'origine sont rehachées. Il est donc également préférable d'avoir une valeur estimée ici.
Utiliser l'opération bit à bit (hash & (arrayLength-1)) pour le modulo est plus rapide, donc la taille du tableau est toujours une puissance de 2. Si vous donnez négligemment une valeur initiale telle que 17, elle sera convertie en 32. Par défaut, la valeur initiale lorsque le premier élément est inséré est 16.
Lors d'une itération avec iterator(), il parcourt le tableau de buckets de hachage, ce qui semble non ordonné.
Dans JDK 8, un nouveau seuil vaut 8 par défaut. Lorsque les Entries d'un bucket dépassent le seuil, elles sont stockées dans un arbre rouge-noir au lieu d'une liste simplement chaînée pour accélérer la recherche de Key.
LinkedHashMap
Étend HashMap en ajoutant une implémentation de liste doublement chaînée ; on dit qu’elle est la structure de données la plus gourmande en mémoire. Elle prend en charge le tri par ordre d’insertion des Entry lors de l’itération avec iterator() (mais les mises à jour ne comptent pas ; si la propriété accessOrder est définie à true, alors tous les accès en lecture et en écriture comptent).
Dans l’implémentation, des pointeurs before/after sont ajoutés à Entry. Lors de l’insertion, vous vous ajoutez avant le Header Entry. Si tous les accès en lecture et en écriture doivent être ordonnés, vous devez également raccorder les pointeurs before/after des Entries précédents et suivants pour vous retirer de la liste chaînée.
TreeMap
Implémentée avec un arbre rouge-noir. Pour des raisons de place, voirTutoriel d’introductionPrend en charge le tri par valeur de Key lors de l’itération avec iterator() ; elle peut trier par ordre croissant selon les Keys qui implémentent l’interface Comparable, ou être contrôlée par un Comparator passé. Comme on peut l’imaginer, le coût d’insertion/suppression d’éléments sur l’arbre est forcément plus élevé que celui de HashMap.
Prend en charge l’interface SortedMap, comme firstKey(), lastKey() pour obtenir la plus petite et la plus grande clé, ou sub(fromKey, toKey), tailMap(fromKey) pour découper un segment de la Map.
ConcurrentHashMap
HashMap optimisée pour la concurrence. Par défaut, elle possède 16 verrous d’écriture (davantage peuvent être définis), ce qui répartit efficacement la probabilité de blocage, et il n’y a pas de verrou de lecture.
La structure de données est Segment[]. À l’intérieur de Segment se trouve le tableau de compartiments de hachage. Chaque Segment possède un verrou. La Key calcule d’abord dans quel Segment elle se trouve, puis calcule dans quel compartiment de hachage elle se trouve.
Prend en charge l’interface ConcurrentMap, comme putIfAbsent(key, value), l’inverse replace(key, value), et replace(key, oldValue, newValue) qui implémente CAS.
Il n’y a pas de verrou de lecture car les actions put/remove sont des actions atomiques (par exemple, put est une opération d’affectation sur un élément de tableau/pointeur Entry) ; les opérations de lecture ne verront pas d’état intermédiaire d’une action de mise à jour.
ConcurrentSkipListMap
SortedMap optimisé pour la concurrence ajouté dans JDK 6, implémenté avec SkipList. SkipList est une alternative simplifiée aux arbres rouge-noir et un algorithme de collection ordonnée populaire. Pour des raisons de place limitée, voirTutoriel d'introductionLe package Concurrent l'a choisi parce qu'il prend en charge les algorithmes sans verrou basés sur CAS, alors que les arbres rouge-noir n'ont pas de bons algorithmes sans verrou.
Assez spécial : son size() ne peut pas être appelé à la légère ; il parcourt pour compter.
Complément
À propos de null : HashMap et LinkedHashMap sont permissifs. TreeMap ne peut pas avoir de clés null lorsqu'aucun Comparator n'est défini. Dans ConcurrentHashMap dans JDK 7, la valeur ne peut pas être null (pourquoi cela ?) ; dans JDK 8, ni la clé ni la valeur ne peuvent être null. Pour ConcurrentSkipListMap, dans toutes les versions du JDK, ni la clé ni la valeur ne peuvent être null.
Set
Presque tous les Sets sont implémentés en interne avec une Map, car le KeySet d'une Map est un Set, et la valeur est une valeur factice, toutes utilisant le même Object. Les caractéristiques des Set héritent également de celles des implémentations de Map internes.
- HashSet: en interne, c'est un HashMap.
- LinkedHashSet: en interne, c'est un LinkedHashMap.
- TreeSet: en interne, c'est un SortedSet implémenté avec TreeMap.
- ConcurrentSkipListSet: en interne, c'est un SortedSet optimisé pour la concurrence implémenté avec ConcurrentSkipListMap.
- CopyOnWriteArraySet: en interne, c'est un Set optimisé pour la concurrence implémenté avec CopyOnWriteArrayList, utilisant sa méthode addIfAbsent() pour dédupliquer les éléments. Comme mentionné précédemment, les performances de cette méthode sont médiocres.
Complément: il semble qu'un ConcurrentHashSet manque. Il aurait dû y avoir une implémentation simple utilisant ConcurrentHashMap en interne, mais le JDK ne l'a tout simplement pas fournie. Jetty en a encapsulé un lui-même, tandis que Guava utilise directement java.util.Collections.newSetFromMap(new ConcurrentHashMap()) pour l'implémenter.
File
Queue est une List où les éléments entrent et sortent aux deux extrémités, elle peut donc aussi être implémentée à l'aide d'un tableau ou d'une liste chaînée.
– File d'attente ordinaire –
LinkedList
Oui, LinkedList implémentée avec une liste doublement chaînée est à la fois une List et une Queue. C'est la seule Queue qui autorise null.
ArrayDeque
Une Queue bidirectionnelle implémentée avec un tableau circulaire. La taille est un multiple de 2, et la valeur par défaut est 16.
Un tableau ordinaire ne peut ajouter rapidement des éléments qu'à la fin. Pour prendre en charge FIFO et retirer rapidement des éléments depuis la tête, un tableau circulaire est nécessaire : il y a deux indices, head et tail. Lorsqu'on retire un élément, l'indice head est incrémenté. Lorsqu'on ajoute un élément, si la fin de l'espace du tableau a été atteinte, l'élément est affecté cycliquement au tableau
PriorityQueue
File d'attente prioritaire implémentée avec un tas binaire ; voirTutoriel d'introductionElle n'est plus FIFO ; à la place, les éléments sortent de la file selon le résultat de comparaison de l'interface Comparable implémentée par l'élément ou du Comparator passé. Plus la valeur est petite, plus la priorité est élevée, et plus tôt l'élément sort de la file. Mais notez que le retour de son iterator() n'effectue pas de tri.
–Files d'attente thread-safe–
ConcurrentLinkedQueue/ConcurrentLinkedDeque
Queue non bornée optimisée pour la concurrence, basée sur une liste chaînée, implémentant un algorithme sans verrou reposant sur CAS.
La structure de ConcurrentLinkedQueue est une liste simplement chaînée avec des pointeurs head/tail. Comme l'enfilement nécessite deux opérations CAS — modifier le pointeur next de l'élément tail et mettre à jour tail pour qu'il pointe vers le nouvel élément — qui ne peuvent pas être atomiques, un algorithme spécial est nécessaire. Pour des raisons de place, voirTutoriel de démarrage。
PriorityBlockingQueue
PriorityQueue non bornée optimisée pour la concurrence, également basée sur un tas binaire. Elle utilise un verrou lecture-écriture commun. Bien qu'elle implémente l'interface BlockingQueue, elle n'a en réalité pas les caractéristiques d'une file d'attente bloquante ; elle s'agrandit automatiquement lorsque l'espace est insuffisant.
DelayQueue
Contient en interne une PriorityQueue, également non bornée. Les éléments doivent implémenter l'interface Delayed. Chaque appel doit renvoyer le temps restant avant l'heure de déclenchement ; une valeur inférieure à 0 signifie qu'il doit être déclenché.
Lors de l'appel de pull(), elle utilise peek() pour inspecter l'élément de tête et vérifier si l'heure de déclenchement a été atteinte. ScheduledThreadPoolExecutor utilise une structure similaire.
–Files d'attente bloquantes thread-safe–
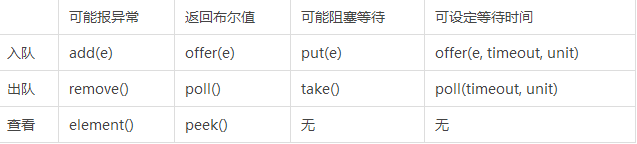
La longueur d'une BlockingQueue est limitée afin de garantir que les vitesses du producteur et du consommateur ne diffèrent pas trop, évitant ainsi l'épuisement de la mémoire. Une fois définie, la longueur de la file ne peut pas être modifiée. Lorsque la file est pleine lors de l'ajout, ou vide lors du retrait, les effets des différentes méthodes sont présentés dans le tableau ci-dessous :
ArrayBlockingQueue
BlockingQueue de longueur fixe optimisée pour la concurrence, implémentée à partir d'un tableau circulaire. Elle possède un verrou lecture-écriture commun et deux Conditions, notFull et notEmpty, gérant les états de blocage lorsque la file est pleine ou vide.
LinkedBlockingQueue/LinkedBlockingDeque
BlockingQueue éventuellement bornée et optimisée pour la concurrence, implémentée à partir d'une liste chaînée, de sorte que la longueur peut être définie sur Integer.MAX_VALUE. Tirant parti des caractéristiques d'une liste chaînée, elle sépare les verrous takeLock et putLock, et continue d'utiliser notEmpty et notFull pour gérer les états de blocage lorsque la file est pleine ou vide.
Complément
JDK7 en possède uneLinkedTransferQueueLa méthode transfer(e) garantit que l'élément placé par le producteur est renvoyé après que le consommateur l'a retiré. Elle est meilleure que SynchronousQueue ; je devrais l'étudier quand j'aurai le temps.
Source : http://www.topthink.com/topic/11679.html