できるだけ短い紙面で、すべてのコレクションと並行コレクションの特徴、実装方法、性能を整理して解説する。「Javaを精通している」と自称しながら実はまだ自信がない人に適した内容。
ListArrayList
配列で実装されている。スペースを節約できるが、配列には容量制限がある。制限を超えると容量が50%増加し、System.arraycopy()で新しい配列にコピーする。そのため、配列サイズの予測値を指定するのが望ましい。デフォルトでは最初の要素挿入時にサイズ10の配列を作成する。
配列のインデックスで要素にアクセスする–get(i)/set(i,e)の性能は非常に高い。これは配列の基本的な利点である。
配列の末尾に直接要素を追加する–add(e)の性能も高い。しかし、インデックスを指定して要素を挿入・削除する–add(i,e), remove(i), remove(e)の場合は、System.arraycopy()で影響を受ける一部の要素を移動する必要があるため、性能が低下する。これが基本的な欠点である。
LinkedList
双方向リンクリストで実装されている。リンクリストには容量制限がないが、双方向リンクリスト自体がより多くのスペースを使用し、追加のリンクポインタ操作も必要とする。
インデックスで要素にアクセスする–get(i)/set(i,e)は、残念ながらリンクリストを走査してポインタを目的の位置まで移動させる必要がある(iが配列サイズの半分より大きい場合は、末尾から移動する)。
要素の挿入・削除時は前後のノードのポインタを変更するだけでよい。ただし、インデックスが指す位置まで移動するには、リンクリストの一部のポインタを走査する必要がある。リンクリストの両端での操作–add(), addFirst(), removeLast()、またはiterator()のremove()のみ、ポインタの移動を省略できる。
CopyOnWriteArrayList
並行処理向けに最適化されたArrayList。CopyOnWrite戦略を用い、変更時にまずスナップショットをコピーして変更し、完了後に内部ポインタを新しい配列に向けさせる。
スナップショットへの変更は読み取り操作には見えないため、書き込みロックのみで読み取りロックはない。さらにコピーのコストが高いので、典型的には読み取りが多く書き込みが少ないシナリオに適している。更新頻度が高い場合や配列が大きい場合は、すべての操作に同じロックを使用してスレッドセーフを保証するCollections.synchronizedList(list)を使用する方が良い。
addIfAbsent(e)メソッドが追加されており、配列を走査して要素が既に存在するか確認するため、性能は想像どおりあまり良くない。
補足
どの実装でも、値からインデックスを返す–contains(e), indexOf(e), remove(e)は、すべての要素を走査して比較する必要があり、性能は想像どおりあまり良くない。
要素の値でソートされたSortedListはない。スレッドセーフなクラスにもロックフリーアルゴリズムのConcurrentLinkedListはない。SetとQueueの同等クラスで代用する場合、List特有のメソッドが一部欠けてしまう。
Map
HashMap
Entry[]配列で実装されたハッシュバケット配列。Keyのハッシュ値をバケット配列のサイズで剰余演算すると、配列のインデックスが得られる。
要素を挿入するとき、2つのKeyが同じバケットに該当する場合(例えばハッシュ値1と17を16で剰余するとどちらも最初のハッシュバケットになる)、Entryはnext属性を使って複数のEntryを単方向リンクリストとして格納する。後からバケットに入ったEntryはnextをバケット内の現在のEntryに向ける。
ハッシュ値17のkeyを検索する場合、まず最初のハッシュバケットを特定し、リンクリストでバケット内のすべての要素を走査して、各々のkey値を比較する。
Entry数がバケット数の75%に達すると(多くの記事は使用済みバケット数が75%に達したと言うが、コードを見るとそうではない)、バケット配列を倍に拡張し、元のすべてのEntryを再配置する。そのため、ここでも予測値を指定するのが望ましい。
剰余演算にビット演算(hash & (arrayLength-1))を使うと高速であるため、配列のサイズは常に2のN乗になる。適当な初期値として例えば17を与えると32に変換される。デフォルトでは最初に要素を入れるときの初期値は16である。
iterator()ではハッシュバケット配列に沿って走査するため、順序がバラバラに見える。
JDK8では、デフォルト8のしきい値が新たに追加された。1つのバケット内のEntryがしきい値を超えると、単方向リンクリストではなく赤黒木で格納され、Keyの検索速度を向上させる。
LinkedHashMap
HashMapを拡張して双方向リンクリストを追加した実装で、最もメモリを消費するデータ構造と言われている。iterator()時にEntryの挿入順でソートされることをサポートする(ただし更新は対象外。accessOrder属性をtrueに設定すると、すべての読み書きアクセスが対象となる)。
実装ではEntryにbefore/afterポインタ属性を追加し、挿入時には自分自身をHeader Entryの前に追加する。すべての読み書きアクセスをソートする場合は、前後のEntryのbefore/afterをつなぎ合わせて、リンクリストから自分自身を削除する必要もある。
TreeMap
赤黒木で実装されている。紙面の都合上、詳細は入門チュートリアル。iterator()でKey値によるソートをサポートし、Comparableインターフェースを実装したKeyの昇順ソート、または渡されたComparatorによる制御が可能。想像できるように、ツリー上での要素の挿入・削除のコストはHashMapよりも必ず大きい。
SortedMapインターフェースをサポートしており、firstKey()、lastKey()で最大・最小のkeyを取得したり、sub(fromKey, toKey)、tailMap(fromKey)でMapの一部を切り出したりできる。
ConcurrentHashMap
並行処理向けに最適化されたHashMap。デフォルトで16個の書き込みロック(より多く設定可能)を持ち、ブロックの確率を効果的に分散させる。また、読み取りロックはない。
データ構造はSegment[]で、Segmentの中に実際のハッシュバケット配列があり、各Segmentが1つのロックを持つ。Keyはまず自分がどのSegmentにあるかを計算し、次に自分がどのハッシュバケットにあるかを計算する。
ConcurrentMapインターフェースをサポートしており、putIfAbsent(key, value)や逆のreplace(key, value)、CASを実装するreplace(key, oldValue, newValue)などがある。
読み取りロックがないのは、put/remove操作が原子操作であるためである(例えばputは配列要素/Entryポインタへの代入操作であり、読み取り操作は更新操作の途中状態を見ることはない)。
ConcurrentSkipListMap
JDK6で新たに追加された並行処理向けに最適化されたSortedMap。SkipListで実装されている。SkipListは赤黒木の簡素化された代替案であり、人気のある順序付き集合アルゴリズムである。紙面の都合上、詳細は入門チュートリアル。Concurrentパッケージがこれを選んだのは、CASベースのロックフリーアルゴリズムをサポートしているためであり、赤黒木には優れたロックフリーアルゴリズムがないからである。
非常に特殊な点として、そのsize()は気軽に呼び出せず、走査して統計を取る。
補足
nullについて、HashMapとLinkedHashMapは制限がない。TreeMapはComparatorを設定していない場合、keyをnullにできない。ConcurrentHashMapはJDK7ではvalueをnullにできない(なぜだろう?)。JDK8ではkeyとvalueの両方をnullにできない。ConcurrentSkipListMapはすべてのJDKでkeyとvalueの両方をnullにできない。
Set
Setはほとんど内部でMapを使って実装されている。MapのKeySetがそのままSetであり、valueはダミー値で、すべて同じObjectを使用する。Setの特徴も内部のMap実装の特徴を引き継いでいる。
- HashSet:内部はHashMap。
- LinkedHashSet:内部はLinkedHashMap。
- TreeSet:内部はTreeMapのSortedSet。
- ConcurrentSkipListSet:内部はConcurrentSkipListMapの並行処理向けに最適化されたSortedSet。
- CopyOnWriteArraySet:内部はCopyOnWriteArrayListの並行処理向けに最適化されたSet。そのaddIfAbsent()メソッドを利用して要素の重複を排除する。前述のとおり、このメソッドの性能は平凡である。
補足:ConcurrentHashSetが足りないようだ。本来なら内部でConcurrentHashMapを使うシンプルな実装があってもよいはずだが、JDKはどうしても提供しなかった。Jettyは独自にラップしたものを実装し、Guavaはjava.util.Collections.newSetFromMap(new ConcurrentHashMap())を直接使って実装している。
Queue
Queueは両端で要素を出入りさせるListであるため、配列またはリンクリストで実装することもできる。
–通常のキュー–
LinkedList
そのとおり。双方向リンクリストで実装されたLinkedListはListでもありQueueでもある。nullを許容する唯一のQueueである。
ArrayDeque
循環配列で実装された双方向Queue。サイズは2の倍数で、デフォルトは16。
通常の配列は末尾に要素を素早く追加できるだけである。FIFOをサポートし、配列の先頭から要素を素早く取り出すには、循環配列を使用する必要がある。キューの先頭と末尾の2つのインデックスを持つ。要素をポップするときは先頭インデックスをインクリメントする。要素を追加するとき、配列空間の末尾に達した場合は、要素を配列
PriorityQueue
二分ヒープで実装された優先度付きキュー。詳細は入門チュートリアル。FIFOではなく、要素が実装したComparableインターフェース、または渡されたComparatorの比較結果に従ってデキューされる。数値が小さいほど優先度が高く、先にデキューされる。ただし、そのiterator()の戻り値はソートされないことに注意。
スレッドセーフなキュー
ConcurrentLinkedQueue/ConcurrentLinkedDeque
無制限の並行最適化Queue、リンクリストベースで、CASに依存したロックフリーアルゴリズムを実装。
ConcurrentLinkedQueueの構造は単方向リンクリストとhead/tailの2つのポインタ。エンキュー時には末尾要素のnextポインタの変更と、tailが新しくエンキューされた要素を指すように変更するという2つのCAS操作をアトミックに行えないため、特別なアルゴリズムが必要となる。紙面の都合上、以下を参照。入門チュートリアル。
PriorityBlockingQueue
無制限の並行最適化PriorityQueue、こちらも二分ヒープベース。共通の読み書きロックを1つ使用する。BlockingQueueインターフェースを実装しているが、実際にはブロッキングキューの特徴は一切なく、スペースが不足すると自動的に拡張される。
DelayQueue
内部にPriorityQueueを含み、これも無制限。要素はDelayedインターフェースを実装する必要があり、呼び出しのたびにトリガー時間まであとどれだけあるかを返す必要がある。0未満の場合はトリガーすべきことを示す。
pull()ではpeek()を使用してキューの先頭要素を確認し、トリガー時間に達したかどうかをチェックする。ScheduledThreadPoolExecutorも同様の構造を使用している。
スレッドセーフなブロッキングキュー
BlockingQueueのキューの長さは制限されており、生産者と消費者の速度があまり乖離しないようにして、メモリ枯渇を防ぐ。キューの長さは設定後に変更できない。エンキュー時にキューが満杯の場合、またはデキュー時にキューが空の場合の各関数の効果は以下の表を参照:
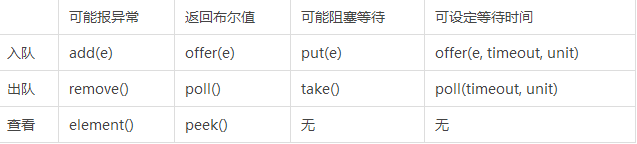
ArrayBlockingQueue
固定長の並行最適化BlockingQueue、循環配列ベースで実装。共通の読み書きロック1つと、notFull、notEmptyの2つのConditionを持ち、キューが満杯または空のときのブロッキング状態を管理する。
LinkedBlockingQueue/LinkedBlockingDeque
長さを選択できる並行最適化BlockingQueue、リンクリストベースで実装されているため、長さをInteger.MAX_VALUEに設定できる。リンクリストの特性を利用して、takeLockとputLockの2つのロックを分離し、notEmpty、notFullでキューが満杯または空のときのブロッキング状態を管理する。
補足
JDK7にはLinkedTransferQueue、transfer(e)メソッドはProducerが入れた要素がConsumerに取り出されてから戻ることを保証し、SynchronousQueueよりも優れている。時間があるときに勉強すべき。
出典:http://www.topthink.com/topic/11679.html