En el espacio más breve posible, repasa las características, la forma de implementación y el rendimiento de todas las colecciones y colecciones concurrentes. Es adecuado para todos aquellos que dicen ser "expertos en Java" pero en realidad no están muy seguros.
ListArrayList
Implementado con un array. Ahorra espacio, pero el array tiene un límite de capacidad. Cuando se supera el límite, aumenta la capacidad en un 50% y usa System.arraycopy() para copiar a un nuevo array; por lo tanto, es mejor proporcionar un valor estimado del tamaño del array. Por defecto, se crea un array de tamaño 10 al insertar el primer elemento.
Acceder a un elemento por el índice del array –get(i)/set(i,e) tiene un rendimiento muy alto; esta es la ventaja básica del array.
Agregar un elemento directamente al final del array –add(e) también tiene un rendimiento alto, pero si se inserta o elimina por índice –add(i,e), remove(i), remove(e), se debe usar System.arraycopy() para mover los elementos afectados, y el rendimiento empeora; esta es una desventaja básica.
LinkedList
Implementado como lista doblemente enlazada. La lista enlazada no tiene límite de capacidad, pero la lista doblemente enlazada en sí ocupa más espacio y también requiere operaciones adicionales con punteros de enlace.
Acceder a un elemento por índice –get(i)/set(i,e) requiere, lamentablemente, recorrer la lista enlazada para mover el puntero hasta la posición (si i > la mitad del tamaño de la lista, se comienza a mover desde el final).
Al insertar o eliminar un elemento, basta con modificar los punteros de los nodos anterior y posterior, pero aún hay que recorrer parte de la lista para mover el puntero hasta la posición indicada por el índice. Solo las operaciones en los dos extremos de la lista –add(), addFirst(), removeLast() o remove() sobre iterator() pueden evitar el movimiento de punteros.
CopyOnWriteArrayList
ArrayList optimizado para concurrencia. Usa la estrategia CopyOnWrite: al modificar, primero copia una instantánea para modificarla y, al terminar, hace que el puntero interno apunte al nuevo array.
Como las modificaciones sobre la instantánea no son visibles para las operaciones de lectura, solo hay bloqueo de escritura y no de lectura. Sumado al alto costo de la copia, es típicamente adecuado para escenarios de muchas lecturas y pocas escrituras. Si la frecuencia de actualización es alta o el array es grande, es mejor usar Collections.synchronizedList(list), que utiliza un mismo bloqueo para todas las operaciones y garantiza la seguridad entre hilos.
Añade el método addIfAbsent(e), que recorre el array para comprobar si el elemento ya existe; como es de imaginar, el rendimiento no será muy bueno.
Complemento
En cualquier implementación, los métodos que buscan por valor –contains(e), indexOf(e), remove(e) requieren recorrer todos los elementos para comparar; como es de imaginar, el rendimiento no será muy bueno.
No hay un SortedList ordenado por el valor del elemento, ni un ConcurrentLinkedList con algoritmo sin bloqueo entre las clases seguras para hilos; si se usa la clase equivalente de Set o Queue como solución provisional, se echarán en falta algunos métodos específicos de List.
Map
HashMap
Es un array de cubos hash implementado con un array Entry[]. Aplicando el módulo del valor hash de la Key con el tamaño del array de cubos se obtiene el índice del array.
Al insertar un elemento, si dos Keys caen en el mismo cubo (por ejemplo, los hash 1 y 17, tras el módulo 16, pertenecen al primer cubo hash), Entry usa un atributo next para almacenar varias Entry en una lista enlazada individual; la Entry que llega después apunta con next a la Entry actual del cubo.
Al buscar la key con valor hash 17, primero se localiza el primer cubo hash y luego se recorre la lista enlazada del cubo comparando el valor de cada key.
Cuando el número de Entry alcanza el 75% del número de cubos (muchos artículos dicen que el número de cubos usados alcanza el 75%, pero viendo el código no es así), el array de cubos se expande al doble y se redistribuyen todas las Entry originales; por eso también es mejor tener un valor estimado aquí.
El módulo se realiza con una operación de bits (hash & (arrayLength-1)), que es más rápida, por lo que el tamaño del array siempre es una potencia de 2. Si das un valor inicial cualquiera, como 17, se convierte en 32. El valor inicial predeterminado al colocar el primer elemento es 16.
Al usar iterator() se recorre el array de cubos hash a lo largo de su orden, por lo que parece desordenado.
En JDK 8, se añade un umbral con valor predeterminado de 8: cuando las Entry de un cubo superan el umbral, ya no se almacenan como lista enlazada individual sino como árbol rojo-negro, para acelerar la búsqueda de las Keys.
LinkedHashMap
Extiende HashMap añadiendo una lista doblemente enlazada; se dice que es la estructura de datos que más memoria ocupa. Al usar iterator(), soporta la ordenación según el orden de inserción de las Entry (pero las actualizaciones no cuentan; si el atributo accessOrder se establece a true, todos los accesos de lectura y escritura cuentan).
En la implementación, se añaden a la Entry los punteros before/after; al insertar, se coloca a sí misma delante de la Entry Header. Si todas las lecturas y escrituras deben ordenarse, también hay que enlazar los before/after de las Entry anterior y posterior para eliminar, en la lista enlazada, la Entry actual.
TreeMap
Implementado con un árbol rojo-negro; por limitación de espacio, ver detalle enTutorial de iniciación. Soporta la ordenación por valor de Key al usar iterator(); puede ordenar ascendentemente según la Key que implementa la interfaz Comparable, o estar controlado por un Comparator pasado como argumento. Como es de imaginar, el coste de insertar/eliminar elementos en el árbol es ciertamente mayor que en HashMap.
Soporta la interfaz SortedMap, como firstKey(), lastKey() para obtener la key máxima y mínima, o sub(fromKey, toKey), tailMap(fromKey) para recortar una parte del Map.
ConcurrentHashMap
HashMap optimizado para concurrencia; por defecto tiene 16 bloqueos de escritura (se pueden configurar más), lo que dispersa eficazmente la probabilidad de bloqueo, y no tiene bloqueos de lectura.
La estructura de datos es Segment[]; dentro de Segment está el array de cubos hash, y cada Segment tiene un bloqueo. Primero se calcula en qué Segment está la Key y luego en qué cubo hash.
Soporta la interfaz ConcurrentMap, como putIfAbsent(key, value) y el inverso replace(key, value), así como replace(key, oldValue, newValue) que implementa CAS.
No hay bloqueo de lectura porque put/remove son acciones atómicas (por ejemplo, put es una operación de asignación sobre un elemento del array / puntero Entry); una operación de lectura no puede ver un estado intermedio de una actualización.
ConcurrentSkipListMap
SortedMap optimizado para concurrencia añadido en JDK 6, implementado con SkipList. SkipList es una alternativa simplificada al árbol rojo-negro y un popular algoritmo de colección ordenada; por limitación de espacio, verTutorial de iniciación. El paquete Concurrent lo elige porque soporta algoritmos sin bloqueo basados en CAS, mientras que el árbol rojo-negro no tiene un buen algoritmo sin bloqueo.
Muy especial: su size() no se puede invocar a la ligera, porque recorre la estructura para hacer el recuento.
Complemento
Sobre null: HashMap y LinkedHashMap son permisivos; en TreeMap, la key no puede ser null si no se establece un Comparator; en ConcurrentHashMap, en JDK 7 el value no puede ser null (¿por qué?), y en JDK 8 ni la key ni el value pueden ser null; en ConcurrentSkipListMap, en todas las versiones de JDK, ni la key ni el value pueden ser null.
Set
Casi todos los Set se implementan internamente con un Map, porque el KeySet de un Map es en sí un Set, y el value es un valor ficticio, usando todos el mismo Object. Las características del Set también heredan las características de esas implementaciones internas de Map.
- HashSet: internamente es un HashMap.
- LinkedHashSet: internamente es un LinkedHashMap.
- TreeSet: internamente es un SortedSet de TreeMap.
- ConcurrentSkipListSet: internamente es un SortedSet optimizado para concurrencia de ConcurrentSkipListMap.
- CopyOnWriteArraySet: internamente es un Set optimizado para concurrencia de CopyOnWriteArrayList, que utiliza su método addIfAbsent() para eliminar duplicados; como se mencionó antes, el rendimiento de este método es bastante mediocre.
Complemento: Parece que falta un ConcurrentHashSet; debería haber una implementación simple que internamente use ConcurrentHashMap, pero el JDK simplemente no la proporcionó. Jetty encapsuló una por su cuenta, y Guava usa directamente java.util.Collections.newSetFromMap(new ConcurrentHashMap()).
Queue
Queue es una lista por la que se entra y sale por ambos extremos, por lo que también se puede implementar con un array o una lista enlazada.
–Queue normal–
LinkedList
Sí, LinkedList, implementada con una lista doblemente enlazada, es a la vez List y Queue. Es la única Queue que permite introducir null.
ArrayDeque
Queue de doble extremo implementada con un array circular. El tamaño es un múltiplo de 2; por defecto es 16.
Un array normal solo puede añadir elementos rápidamente al final. Para soportar FIFO y extraer rápidamente elementos desde la cabeza del array, se necesita un array circular: hay dos índices, el de cabeza y el de cola. Al extraer un elemento, el índice de cabeza se incrementa. Al añadir un elemento, si se ha llegado al final del espacio del array, el elemento se asigna circularmente a array
PriorityQueue
Cola de prioridad implementada con un montículo binario; ver detalle enTutorial de iniciación, ya no es FIFO, sino que la salida de la cola se determina según el resultado de comparación de la interfaz Comparable implementada por el elemento o del Comparator pasado. Cuanto menor es el valor, mayor es la prioridad y antes sale de la cola. Sin embargo, ten en cuenta que el iterador devuelto por iterator() no está ordenado.
–Cola segura para hilos–
ConcurrentLinkedQueue/ConcurrentLinkedDeque
Queue concurrente optimizada sin límites, basada en una lista enlazada, que implementa un algoritmo sin bloqueos basado en CAS.
La estructura de ConcurrentLinkedQueue es una lista enlazada individualmente y dos punteros head/tail. Al encolar, las dos acciones CAS —modificar el puntero next del elemento de la cola y modificar tail para que apunte al nuevo elemento encolado— no pueden ser atómicas, por lo que se necesita un algoritmo especial. Por limitaciones de espacio, véaseTutorial de introducción。
PriorityBlockingQueue
PriorityQueue optimizada para concurrencia sin límites, también basada en un montículo binario. Utiliza un bloqueo de lectura-escritura compartido. Aunque implementa la interfaz BlockingQueue, en realidad no tiene ninguna característica de cola bloqueante; se expande automáticamente cuando el espacio es insuficiente.
DelayQueue
Contiene internamente un PriorityQueue, también sin límites. Los elementos deben implementar la interfaz Delayed; en cada llamada deben devolver cuánto tiempo falta para el momento de activación. Un valor menor que 0 indica que debería activarse.
Al llamar a pull(), se utiliza peek() para examinar el elemento al frente de la cola y comprobar si ha llegado el momento de activación. ScheduledThreadPoolExecutor utiliza una estructura similar.
–Cola bloqueante segura para hilos–
La longitud de la cola de BlockingQueue es limitada para garantizar que la velocidad del productor y la del consumidor no difieran demasiado y evitar el agotamiento de la memoria. La longitud de la cola no se puede cambiar una vez establecida. Cuando la cola está llena al encolar, o vacía al desencolar, los efectos de las diferentes funciones se muestran en la siguiente tabla:
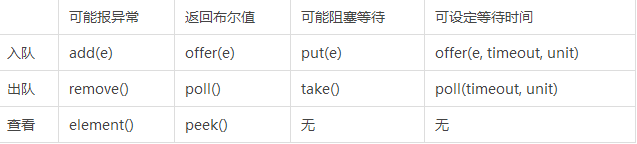
ArrayBlockingQueue
BlockingQueue optimizada para concurrencia de longitud fija, implementada sobre un array circular. Dispone de un bloqueo de lectura-escritura compartido y dos Conditions, notFull y notEmpty, para gestionar el estado de bloqueo cuando la cola está llena o vacía.
LinkedBlockingQueue/LinkedBlockingDeque
BlockingQueue optimizada para concurrencia de longitud fija opcional, implementada sobre una lista enlazada, por lo que la longitud puede establecerse en Integer.MAX_VALUE. Aprovechando las características de la lista enlazada, separa dos bloqueos, takeLock y putLock, y continúa utilizando notEmpty y notFull para gestionar el estado de bloqueo cuando la cola está llena o vacía.
Complemento
JDK7 tiene unLinkedTransferQueueEl método transfer(e) garantiza que el elemento colocado por el Producer sea tomado por el Consumer antes de regresar. Es mejor que SynchronousQueue; cuando tenga tiempo, debería estudiarlo.
Fuente: http://www.topthink.com/topic/11679.html