El big data es un término de amplio significado que se refiere a conjuntos de datos tan grandes y complejos que requieren herramientas de hardware y software especialmente diseñadas para procesarlos. Estos conjuntos de datos suelen tener un tamaño de terabytes o exabytes. Estos conjuntos de datos se recopilan de diversas fuentes: sensores, información climática, información pública como revistas, periódicos y artículos. Otros ejemplos de generación de big data incluyen registros de transacciones de compra, registros web, historiales médicos, vigilancia militar, archivos de video e imágenes, y grandes plataformas de comercio electrónico.
Hay un creciente interés en el big data y el análisis de big data, y en su impacto en las empresas. El análisis de big data es el proceso de estudiar grandes volúmenes de datos para encontrar patrones, correlaciones y otra información útil que pueda ayudar a las empresas a adaptarse mejor a los cambios y a tomar decisiones más inteligentes.
1. Hadoop
Hadoop es un marco de software que permite el procesamiento distribuido de grandes volúmenes de datos. Sin embargo, Hadoop procesa de una manera confiable, eficiente y escalable. Hadoop es confiable porque asume que los elementos de cómputo y el almacenamiento pueden fallar, por lo que mantiene múltiples copias de los datos de trabajo, asegurando que pueda redistribuir el procesamiento entre los nodos que fallaron. Hadoop es eficiente porque trabaja de forma paralela, acelerando el procesamiento mediante cómputo paralelo. Hadoop también es escalable, capaz de manejar datos a nivel de petabytes. Además, Hadoop depende de servidores comunitarios, por lo que su costo es relativamente bajo y cualquiera puede usarlo.
Hadoop es una plataforma de computación distribuida que permite a los usuarios diseñar y utilizar fácilmente. Los usuarios pueden desarrollar y ejecutar fácilmente aplicaciones de procesamiento masivo de datos en Hadoop. Tiene principalmente las siguientes ventajas:
1. Alta confiabilidad.La capacidad de Hadoop para almacenar y procesar datos bit a bit es digna de confianza.
2. Alta escalabilidad. Hadoop distribuye datos entre clústeres de computadoras disponibles y realiza tareas de cálculo. Estos clústeres pueden expandirse fácilmente a miles de nodos.
3. Alta eficiencia. Hadoop puede mover datos dinámicamente entre nodos y garantizar el equilibrio dinámico de cada nodo, por lo que la velocidad de procesamiento es muy rápida.
4. Alta tolerancia a fallos. Hadoop puede guardar automáticamente múltiples copias de los datos y reasignar automáticamente las tareas fallidas.
Hadoop viene con un marco escrito en lenguaje Java, por lo que es ideal para ejecutarse en plataformas de producción Linux. Las aplicaciones en Hadoop también pueden escribirse en otros lenguajes, como C++.
2. HPCC
HPCC es el acrónimo de High Performance Computing and Communications (Computación y Comunicaciones de Alto Rendimiento). En 1993, el Consejo Federal de Coordinación de Ciencia, Ingeniería y Tecnología de los Estados Unidos presentó al Congreso el informe "Proyecto de Desafíos Mayores: Computación y Comunicaciones de Alto Rendimiento", también conocido como el plan HPCC, es decir, el proyecto estratégico científico del Presidente de los Estados Unidos. Su objetivo es resolver una serie de importantes desafíos científicos y tecnológicos mediante el fortalecimiento de la investigación y el desarrollo. HPCC es un plan implementado por Estados Unidos para llevar a cabo la autopista de la información. La implementación de este plan costará decenas de miles de millones de dólares. Sus principales objetivos son: desarrollar sistemas de cómputo escalables y software relacionado para soportar el rendimiento de transmisión de redes a nivel de terabits, desarrollar tecnología de redes de gigabits y ampliar la capacidad de conexión de instituciones de investigación y educación y sus redes.
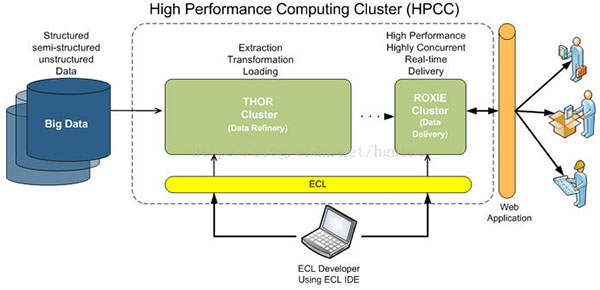
Este proyecto se compone principalmente de cinco partes:
1. Sistema de Computación de Alto Rendimiento (HPCS), cuyo contenido incluye la investigación de las próximas generaciones de sistemas informáticos, herramientas de diseño de sistemas, sistemas típicos avanzados y la evaluación de sistemas existentes;
2. Tecnología de Software Avanzado y Algoritmos (ASTA), que incluye soporte de software para problemas de grandes desafíos, diseño de nuevos algoritmos, ramas y herramientas de software, centros de cómputo y centros de investigación de computación de alto rendimiento, etc.;
3. Red Nacional de Investigación y Educación (NREN), cuyo contenido incluye la investigación y el desarrollo de estaciones intermedias y transmisión a nivel de gigabits;
4. Investigación Básica y Recursos Humanos (BRHR), cuyo contenido incluye investigación básica, capacitación, educación y materiales de cursos; está diseñado para aumentar el flujo de ideas innovadoras mediante la recompensa a investigaciones iniciadas por investigadores y de largo plazo en computación de alto rendimiento escalable; para ampliar el grupo de personal calificado y capacitado mediante la mejora de la educación, la formación en computación de alto rendimiento y las comunicaciones; y para proporcionar la infraestructura necesaria que respalde estas investigaciones y actividades de estudio;
5. Tecnología y Aplicaciones de Infraestructura de la Información (IITA), cuyo objetivo es garantizar el liderazgo de Estados Unidos en el desarrollo de tecnologías avanzadas de la información.
3. Storm
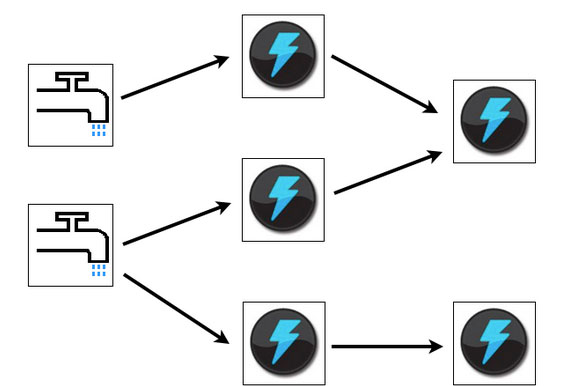
Storm es un software libre de código abierto, un sistema de computación en tiempo real distribuido y tolerante a fallos. Storm puede procesar flujos de datos masivos de manera muy confiable y se utiliza para procesar datos por lotes de Hadoop. Storm es muy sencillo, admite muchos lenguajes de programación y es muy divertido de usar. Storm fue liberado como código abierto por Twitter; otras empresas de aplicación conocidas incluyen Groupon, Taobao, Alipay, Alibaba, Happy Elements, AdMaster, etc.
Storm tiene muchos campos de aplicación: análisis en tiempo real, aprendizaje automático en línea, computación ininterrumpida, RPC distribuido (protocolo de llamada a procedimiento remoto, un método para solicitar servicios desde un programa de computadora remoto a través de la red), ETL (acrónimo de Extraction-Transformation-Loading, es decir, extracción, transformación y carga de datos), etc. La velocidad de procesamiento de Storm es asombrosa: según las pruebas, cada nodo puede procesar 1 millón de tuplas de datos por segundo. Storm es escalable, tolerante a fallos, y muy fácil de configurar y operar.
4. Apache Drill
Para ayudar a los usuarios empresariales a encontrar métodos más eficaces para acelerar las consultas de datos en Hadoop,la Apache Software Foundationlanzó recientemente un proyecto de código abierto llamado "Drill". Apache Drill implementa el Dremel de Google.
Según el proveedor de HadoopMapR Technologies, el gerente de producto Tomer Shiran, explicó que "Drill" ya se está ejecutando como un proyecto de incubadora de Apache y se promoverá continuamente entre los ingenieros de software de todo el mundo.
El proyecto creará una versión de código abierto de la herramienta Dremel Hadoop de Google (Google utiliza esta herramienta para acelerar las aplicaciones de Internet de las herramientas de análisis de datos de Hadoop). "Drill" ayudará a los usuarios de Hadoop a lograr el objetivo de consultar conjuntos de datos masivos más rápidamente.
El proyecto "Drill" en realidad también se inspira en el proyecto Dremel de Google: este proyecto ayudó a Google a lograr el procesamiento y análisis de conjuntos de datos masivos, incluido el análisis de documentos web rastreados, el seguimiento de los datos de las aplicaciones instaladas en Android Market, el análisis de correo no deseado, el análisis de los resultados de pruebas en el sistema de compilación distribuida de Google, etc.
Mediante el desarrollo del proyecto de código abierto Apache "Drill", las organizaciones podrán establecer las interfaces API y la arquitectura flexible y potente a la que pertenece Drill, ayudando así a admitir una amplia variedad de fuentes de datos, formatos de datos y lenguajes de consulta.
5. RapidMiner
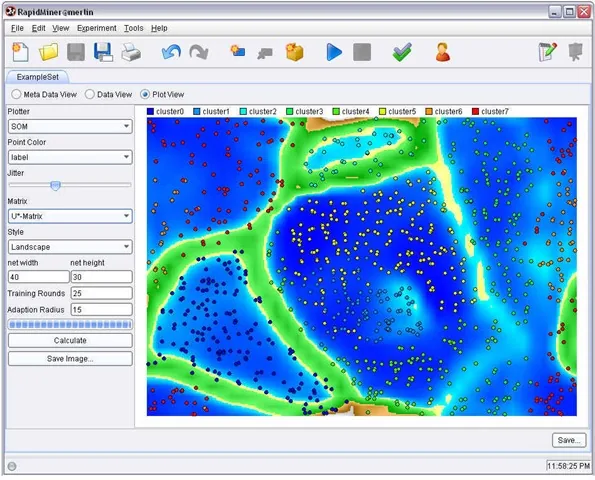
RapidMiner es la solución líder en minería de datos a nivel mundial, con tecnología avanzada en un grado muy alto. Sus tareas de minería de datos abarcan una amplia gama, incluyendo diversas técnicas de datos, y pueden simplificar el diseño y la evaluación del proceso de minería de datos.
Funciones y características
- Ofrece tecnología y bibliotecas de minería de datos de forma gratuita
- 100% en código Java (se puede ejecutar en sistemas operativos)
- El proceso de minería de datos es simple, potente e intuitivo
- El XML interno garantiza un formato estandarizado para representar e intercambiar procesos de minería de datos
- Se pueden automatizar procesos a gran escala con un lenguaje de script simple
- Vistas de datos de múltiples niveles, que garantizan datos eficaces y transparentes
- Prototipos interactivos con interfaz gráfica de usuario
- Aplicaciones automáticas a gran escala mediante línea de comandos (modo de procesamiento por lotes)
- API de Java (interfaz de programación de aplicaciones)
- Mecanismo simple de complementos y ampliación
- Potente motor de visualización, con numerosos modelados visuales de vanguardia para datos de alta dimensión
- Admite más de 400 operadores de minería de datos
La Universidad de Yale lo ha aplicado con éxito en muchos campos de aplicación diferentes, incluidos la minería de textos, la minería multimedia, el diseño de características, la minería de flujos de datos, métodos de desarrollo integrados y minería de datos distribuida.
6. Pentaho BI
La plataforma Pentaho BI se diferencia de los productos BI tradicionales; es un marco orientado a soluciones (Solution) y centrado en los procesos. Su objetivo es integrar una serie de componentes como productos BI de nivel empresarial, software de código abierto, API, etc., para facilitar el desarrollo de aplicaciones de inteligencia empresarial. Su aparición permite que una serie de productos independientes orientados a la inteligencia empresarial, como JFree y Quartz, entre otros, puedan integrarse para formar soluciones complejas y completas de inteligencia empresarial.
La plataforma Pentaho BI es la arquitectura central y la base del conjunto Pentaho Open BI; está centrada en el proceso porque su controlador central es un motor de flujo de trabajo. El motor de flujo de trabajo utiliza definiciones de procesos para definir los procesos de inteligencia empresarial que se ejecutan en la plataforma BI. Los procesos se pueden personalizar fácilmente y también se pueden agregar nuevos procesos. La plataforma BI incluye componentes e informes para analizar el rendimiento de estos procesos. Actualmente, los principales elementos constituyentes de Pentaho incluyen generación de informes, análisis, minería de datos y gestión de flujos de trabajo, etc. Estos componentes se integran en la plataforma Pentaho mediante tecnologías como J2EE, WebService, SOAP, HTTP, Java, JavaScript, Portals, etc. La distribución de Pentaho se realiza principalmente en forma de Pentaho SDK.
El SDK de Pentaho comprende cinco partes: la plataforma Pentaho, la base de datos de ejemplo de Pentaho, la plataforma Pentaho de ejecución independiente, el ejemplo de solución Pentaho y un servidor web Pentaho preconfigurado. La plataforma Pentaho es la parte principal de la plataforma Pentaho e incluye la mayor parte del código fuente de la plataforma Pentaho; la base de datos Pentaho proporciona servicios de datos para el funcionamiento normal de la plataforma Pentaho, incluyendo información de configuración, información relacionada con Solution, etc. No es imprescindible para la plataforma Pentaho; mediante configuración se puede sustituir por otros servicios de base de datos; la plataforma Pentaho de ejecución independiente es un ejemplo del modo de ejecución independiente de la plataforma Pentaho, que demuestra cómo hacer que la plataforma Pentaho se ejecute de forma independiente sin el soporte de un servidor de aplicaciones.
El ejemplo de solución Pentaho es un proyecto de Eclipse que se utiliza para demostrar cómo desarrollar soluciones de inteligencia empresarial relacionadas con la plataforma Pentaho.
La plataforma Pentaho BI está construida sobre servidores, motores y componentes. Estos proporcionan las funciones de servidor J2EE, seguridad, portal, flujo de trabajo, motor de reglas, gráficos, colaboración, gestión de contenidos, integración de datos, análisis y modelado. La mayoría de estos componentes se basan en estándares y pueden sustituirse por otros productos.
Autor: Jingwei Fanglue
Fuente: http://www.36dsj.com/archives/22617