Большие данные — это широкое понятие, обозначающее наборы данных настолько большие и сложные, что для их обработки требуются специально разработанные аппаратные и программные средства. Такие наборы данных обычно имеют размер в терабайтах или эксабайтах. Эти наборы данных собираются из различных источников: датчиков, климатической информации, общедоступной информации, такой как журналы, газеты и статьи. Другие примеры генерации больших данных включают записи о покупках и транзакциях, веб-логи, медицинские записи, военное наблюдение, видео- и фотоархивы, а также крупномасштабную электронную коммерцию.
Наблюдается всплеск интереса к большим данным и аналитике больших данных, а также их влиянию на бизнес. Аналитика больших данных — это процесс изучения больших объёмов данных для поиска закономерностей, корреляций и другой полезной информации, которая может помочь бизнесу лучше адаптироваться к изменениям и принимать более разумные решения.
1. Hadoop
Hadoop — это программная среда, которая может выполнять распределённую обработку больших объёмов данных. Однако Hadoop обрабатывает данные надёжным, эффективным и масштабируемым образом. Hadoop надёжен, поскольку предполагает, что вычислительные элементы и хранилище могут отказать, поэтому он поддерживает несколько копий рабочих данных, гарантируя, что обработка может быть перераспределена на отказавшие узлы. Hadoop эффективен, потому что работает параллельно, ускоряя обработку за счёт параллельной обработки. Hadoop также масштабируем и может обрабатывать данные уровня PB. Кроме того, Hadoop полагается на серверы сообщества, поэтому его стоимость относительно низка, и любой может его использовать.
Hadoop — это платформа распределённых вычислений, которая позволяет пользователям легко проектировать и использовать её. Пользователи могут легко разрабатывать и запускать приложения, обрабатывающие огромные объёмы данных на Hadoop. В основном она имеет следующие преимущества:
1. Высокая надёжность.Способность Hadoop хранить и обрабатывать данные заслуживает доверия.
2. Высокая масштабируемость. Hadoop распределяет данные между доступными компьютерными кластерами и выполняет вычислительные задачи. Эти кластеры можно легко расширить до тысяч узлов.
3. Высокая эффективность. Hadoop может динамически перемещать данные между узлами и обеспечивать динамическую балансировку между узлами, поэтому скорость обработки очень высока.
4. Высокая отказоустойчивость. Hadoop может автоматически сохранять несколько копий данных и автоматически переназначать задачи, завершившиеся сбоем.
Hadoop поставляется с фреймворком, написанным на Java, поэтому он идеально подходит для работы на производственных платформах Linux. Приложения для Hadoop также можно писать на других языках, например C++.
2. HPCC
HPCC — аббревиатура от High Performance Computing and Communications. В 1993 году Федеральный координационный совет по науке, технике и технологиям представил Конгрессу отчет «Grand Challenges: High Performance Computing and Communications», также известный как план HPCC, который является стратегическим научным проектом президента США. Его цель — решить ряд важных научно-технических задач путем усиления исследований и разработок. HPCC — это план, реализуемый Соединенными Штатами для информационной супермагистрали. Реализация этого плана будет стоить десятки миллиардов долларов. Его основные цели: разработать масштабируемые вычислительные системы и соответствующее программное обеспечение для поддержки терабитной производительности передачи данных по сети, разработать гигабитную сетевую технологию и расширить исследовательские и образовательные учреждения и возможности сетевого подключения.
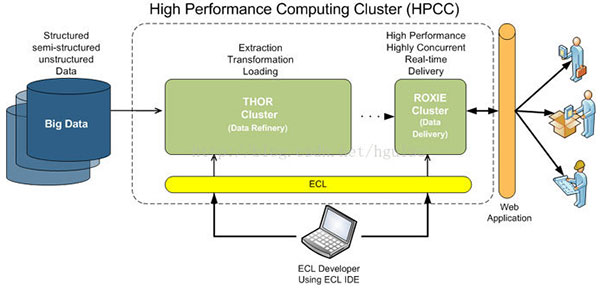
Проект в основном состоит из пяти частей:
1. Высокопроизводительные компьютерные системы (HPCS), включая исследования компьютерных систем будущих поколений, инструменты проектирования систем, передовые типовые системы и оценку существующих систем;
2. Передовые программные технологии и алгоритмы (ASTA), включая программную поддержку для задач grand challenge, разработку новых алгоритмов, программные ветви и инструменты, исследовательские центры вычислительной науки и высокопроизводительных вычислений и т. д.;
3. Национальная исследовательская и образовательная сеть (NREN), включая исследования и разработку промежуточных станций и передачи гигабитного уровня;
4. Фундаментальные исследования и человеческие ресурсы (BRHR), включая фундаментальные исследования, подготовку, образование и учебные материалы, предназначенные для увеличения потока инновационных идей за счёт вознаграждения инициированных исследователями долгосрочных исследований в области масштабируемых высокопроизводительных вычислений; для расширения пула квалифицированных и подготовленных кадров путём совершенствования образования и подготовки в сфере высокопроизводительных вычислений и коммуникаций; и для обеспечения необходимой инфраструктуры для поддержки этой исследовательской и научно-изыскательской деятельности;
5. Технологии и приложения информационной инфраструктуры (IITA), с целью обеспечения лидерства США в разработке передовых информационных технологий.
3. Storm
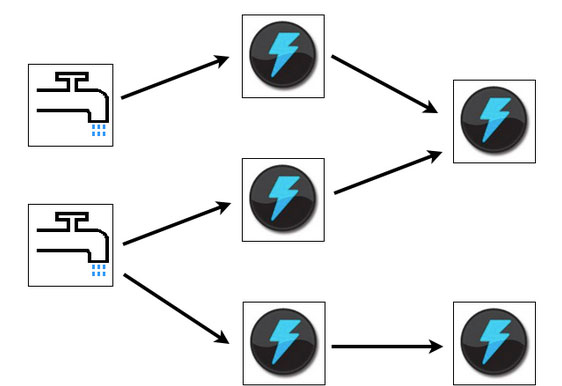
Storm — это бесплатное программное обеспечение с открытым исходным кодом, распределённая отказоустойчивая система вычислений в реальном времени. Storm может очень надёжно обрабатывать огромные потоки данных и используется для обработки пакетных данных Hadoop. Storm прост, поддерживает многие языки программирования, и его приятно использовать. Компания Twitter открыла исходный код Storm. Другие известные компании-пользователи включают Groupon, Taobao, Alipay, Alibaba, Happy Elements, Admaster и т. д.
Storm имеет множество областей применения: аналитика в реальном времени, онлайн-машинное обучение, непрерывные вычисления, распределённый RPC (протокол Remote Procedure Call — способ запроса услуг от удалённой компьютерной программы по сети), ETL (Extraction-Transformation-Loading, то есть извлечение, преобразование и загрузка данных) и так далее. Скорость обработки Storm впечатляет: по результатам тестирования обрабатывает 1 миллион кортежей данных в секунду на узел. Storm масштабируется, отказоустойчив, и его легко настраивать и эксплуатировать.
4. Apache Drill
Чтобы помочь корпоративным пользователям найти более эффективные способы ускорения запросов к данным Hadoop,фонд Apache Software Foundationнедавно запустил проект с открытым исходным кодом под названием «Drill». Apache Drill реализует Dremel от Google.
Представитель вендора HadoopMapR Томер Ширан, менеджер по продукту в компании Technologies, сказал, что «Drill» уже работает как инкубационный проект Apache и будет постоянно продвигаться среди программных инженеров по всему миру.
Проект создаст версию инструмента Dremel Hadoop от Google с открытым исходным кодом (Google использует этот инструмент для ускорения интернет-приложений средств анализа данных Hadoop). А «Drill» поможет пользователям Hadoop быстрее достичь цели выполнения запросов к огромным наборам данных.
Проект «Drill» на самом деле вдохновлен проектом Dremel от Google: этот проект помогает Google анализировать и обрабатывать огромные наборы данных, включая анализ веб-документов, собранных поисковым роботом, отслеживание данных приложений, установленных в Android Market, анализ спама, анализ результатов тестов в распределенной системе сборки Google и так далее.
Разрабатывая открытый проект Apache «Drill», организации смогут создавать API-интерфейсы и гибкую и мощную архитектуру, к которой относится Drill, тем самым помогая поддерживать широкий спектр источников данных, форматов данных и языков запросов.
5. RapidMiner
RapidMiner — это ведущее в мире решение для интеллектуального анализа данных с передовой технологией в очень значительной степени. Оно охватывает широкий спектр задач интеллектуального анализа данных, включая различные виды работы с данными, и позволяет упростить проектирование и оценку процессов интеллектуального анализа данных.
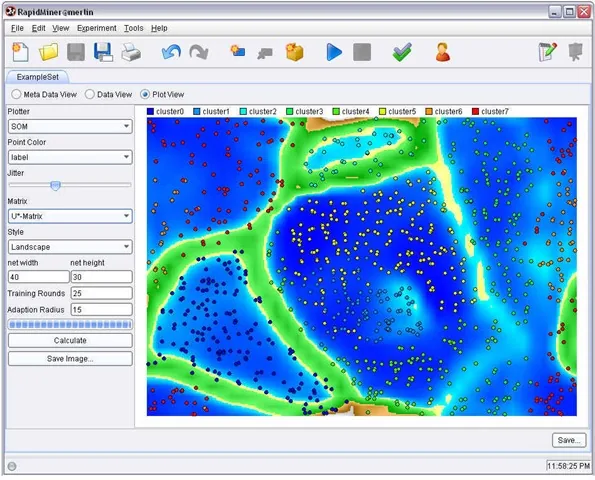
Возможности и характеристики
- Бесплатное предоставление методик и библиотек интеллектуального анализа данных
- 100% написано на Java (может работать в операционных системах)
- Процесс интеллектуального анализа данных — простой, мощный и интуитивно понятный
- Внутренний XML гарантирует стандартизированный формат для представления и обмена процессами интеллектуального анализа данных
- Крупномасштабные процессы можно автоматизировать с помощью простых скриптовых языков
- Многоуровневые представления данных обеспечивают эффективность и прозрачность данных
- Интерактивное прототипирование с графическим пользовательским интерфейсом
- Командная строка (пакетный режим) для автоматизированных крупномасштабных приложений
- Java API (интерфейс прикладного программирования)
- Простые механизмы плагинов и продвижения
- Мощный движок визуализации, множество передовых средств визуализационного моделирования для многомерных данных
- Поддержка более 400 операторов интеллектуального анализа данных
Йельский университет успешно применял его во многих различных прикладных областях, включая интеллектуальный анализ текстов, интеллектуальный анализ мультимедиа, проектирование признаков, интеллектуальный анализ потоков данных, интегрированные методы разработки и распределенный интеллектуальный анализ данных.
6. Pentaho BI
Платформа Pentaho BI отличается от традиционных BI-продуктов. Это фреймворк, ориентированный на процессы и решения. Ее цель — интегрировать ряд BI-продуктов корпоративного уровня, программное обеспечение с открытым исходным кодом, API и другие компоненты, чтобы облегчить разработку приложений бизнес-аналитики. Ее появление позволяет интегрировать вместе ряд независимых BI-ориентированных продуктов, таких как Jfree, Quartz и т. д., для формирования сложных, полноценных решений бизнес-аналитики.
Платформа Pentaho BI, основная архитектура и основа пакета Pentaho Open BI, ориентирована на процессы, поскольку ее центральный контроллер — это движок рабочих процессов. Движок рабочих процессов использует определения процессов для задания процессов бизнес-аналитики, выполняемых на платформе BI. Процессы можно легко настраивать, а также добавлять новые процессы. Платформа BI включает компоненты и отчеты для анализа производительности этих процессов. В настоящее время основные компоненты Pentaho включают генерацию отчетов, анализ, интеллектуальный анализ данных, управление рабочими процессами и т. д. Эти компоненты интегрированы в платформу Pentaho с помощью таких технологий, как J2EE, WebService, SOAP, HTTP, Java, JavaScript и Portals. Pentaho в основном распространяется в виде Pentaho SDK.
Pentaho SDK состоит из пяти частей: платформы Pentaho, образца базы данных Pentaho, автономно запускаемой платформы Pentaho, примеров решений Pentaho и предварительно настроенного веб-сервера Pentaho. Среди них платформа Pentaho — важнейшая часть Pentaho, включающая основную часть исходного кода платформы Pentaho; база данных Pentaho предоставляет службы данных для нормальной работы платформы Pentaho, включая информацию о конфигурации, информацию, связанную с Solution, и т. д. Она не обязательна для платформы Pentaho и может быть заменена другими службами баз данных с помощью настройки; автономно запускаемая платформа Pentaho — это пример автономного режима работы платформы Pentaho, демонстрирующий, как запускать платформу Pentaho независимо без поддержки сервера приложений.
Пример решения Pentaho — это проект Eclipse, используемый для демонстрации того, как разрабатывать связанные решения бизнес-аналитики для платформы Pentaho.
Платформа Pentaho BI построена на серверах, движках и компонентах. Они обеспечивают J2EE-сервер системы, безопасность, портал, рабочий процесс, движок правил, диаграммы, совместную работу, управление контентом, интеграцию данных, анализ и моделирование. Большинство этих компонентов основаны на стандартах и могут быть заменены другими продуктами.
Автор: Jingwei Fanglue
Источник: http://www.36dsj.com/archives/22617